

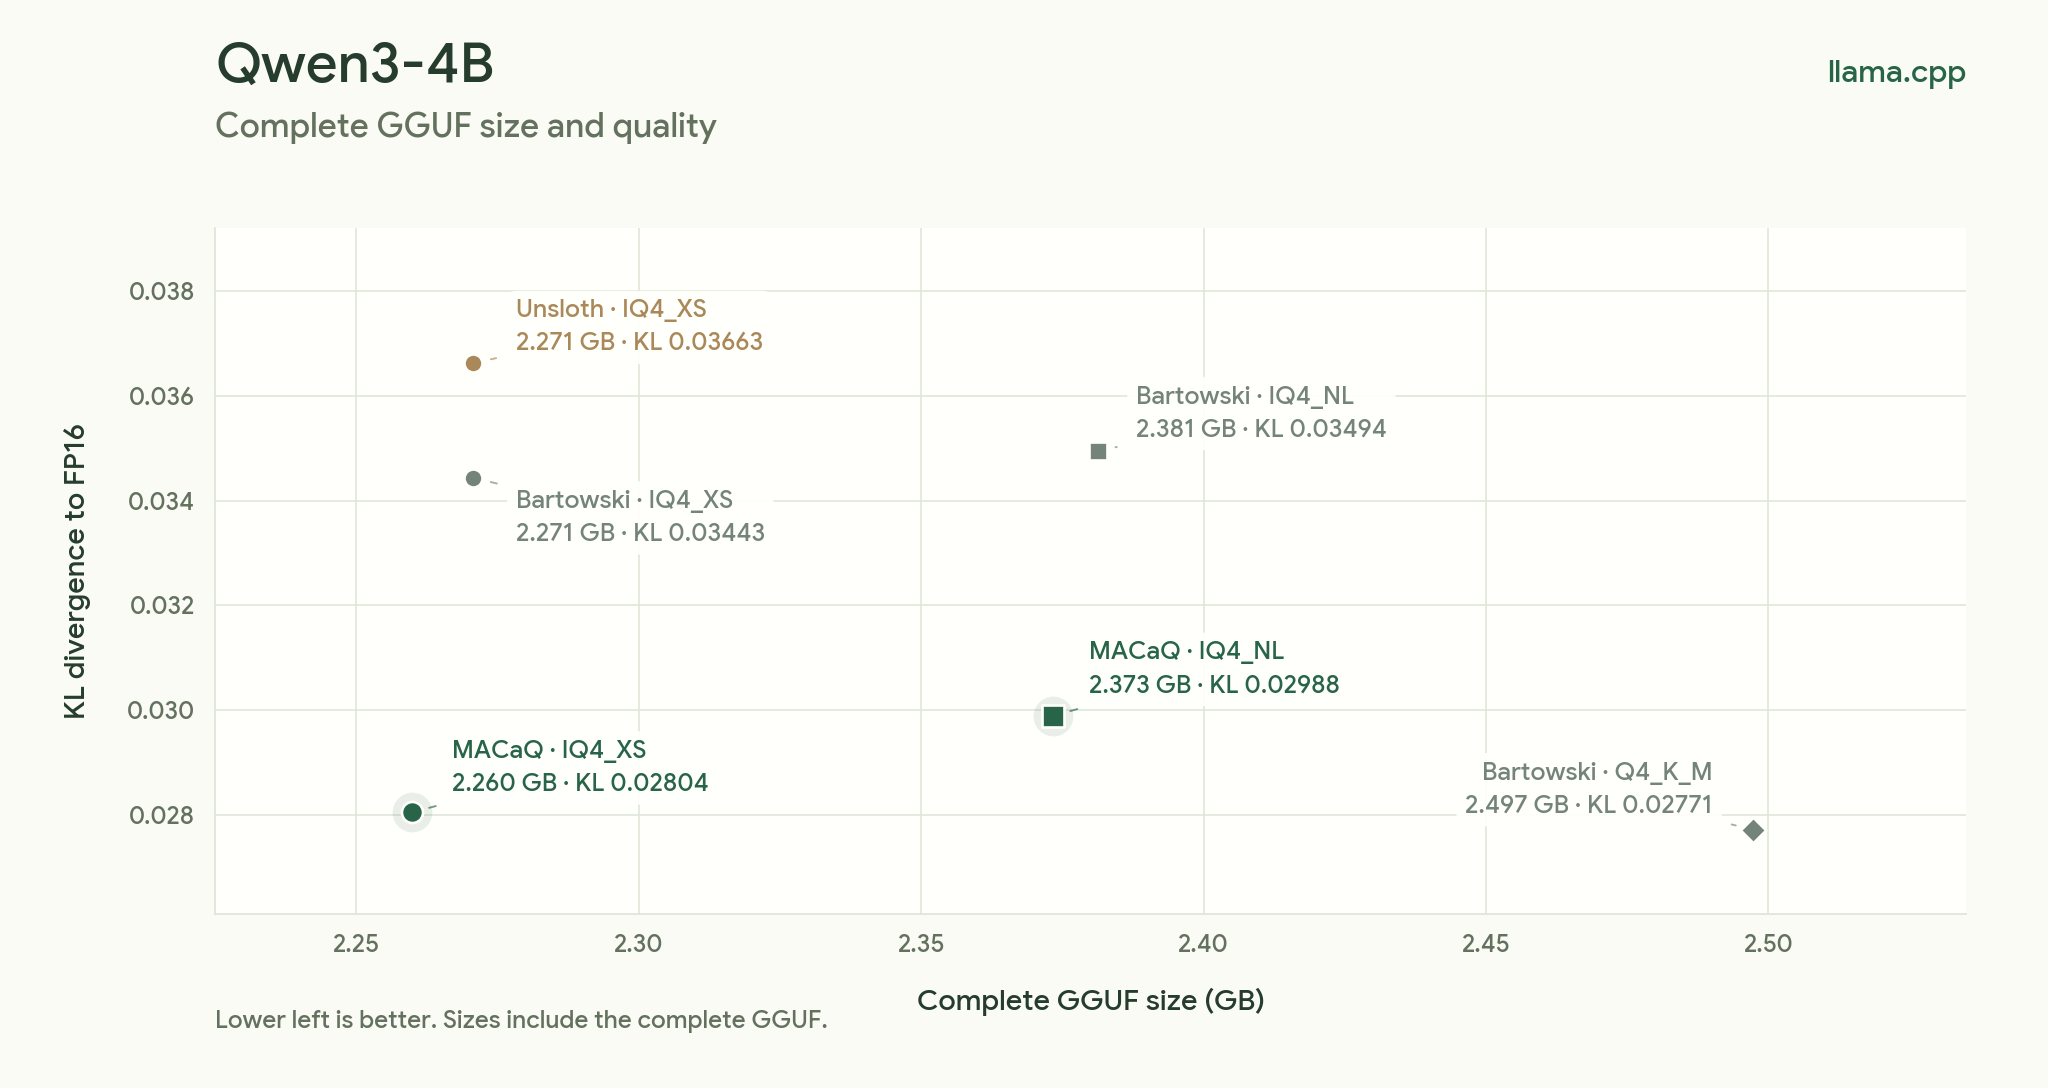
MACaQ ایک ماڈل سے آزاد، کیلیبریٹڈ کوانٹائزیشن پروجیکٹ ہے جو جدید AI ماڈلز کے لیے میموری اور کمپیوٹ کی ضروریات کم کرتا ہے۔ یہ llama.cpp، vLLM، Diffusers، اور PyTorch کے ذریعے متن، تصویر، ویڈیو، اور آڈیو ورک فلو کو سپورٹ کرتا ہے۔
یہ پروجیکٹ کیلیبریٹڈ کم درستگی والے وزن اور ایکٹیویشنز پر توجہ دیتا ہے، جبکہ عملی انفیرنس مطابقت برقرار رکھتا ہے۔ README کے مطابق، MACaQ 32.5 GB ڈیوائس میموری استعمال کرتے ہوئے 122 بلین پیرامیٹرز والے ماڈل کو 64 منٹ میں کوانٹائز کر سکتا ہے۔ بعض موازنوں میں یہ MR-GPTQ اور DuQuant++ کے مقابلے میں کم پرپلیکسیٹی بھی رپورٹ کرتا ہے، یا نمایاں طور پر کم کوانٹائزیشن وقت کے ساتھ Llama-3-8B جیسی پرپلیکسیٹی حاصل کرتا ہے۔
درست MACaQ بیک اینڈ منتخب کریں
سب سے پہلے ایسا بیک اینڈ منتخب کریں جو آپ کے ماڈل اور ڈیپلائمنٹ ہدف سے مطابقت رکھتا ہو۔ ہر بیک اینڈ کے لیے الگ ماحول اور Python 3.12 استعمال کریں۔
- Diffusers: تصویر، ویڈیو، اور آڈیو جنریشن ماڈلز کو W4A4 safetensors چیک پوائنٹس میں کوانٹائز کریں۔
- llama.cpp: متنی ماڈلز کو 2-، 3-، یا 4-بٹ GGUF فائلوں میں کوانٹائز کریں اور انہیں مقامی طور پر چلائیں، بشمول CPU پر۔
- vLLM: متنی ماڈلز کو W4A4 یا صرف وزن والے فارمیٹس کے ساتھ جنریشن یا HTTP سروسنگ کے لیے کوانٹائز کریں۔
- PyTorch: اسپیچ جنریشن ماڈلز کو W4A4 چیک پوائنٹس میں کوانٹائز کریں اور WAV آڈیو تیار کریں۔
ریپوزٹری میں ہر بیک اینڈ کے لیے انسٹالیشن، کیلیبریشن، کوانٹائزیشن، اور جنریشن کی ہدایات موجود ہیں۔ شروع کرنے سے پہلے اپنے منتخب کردہ بیک اینڈ کی گائیڈ کھولیں:
- Diffusers انسٹالیشن اور ورک فلو
- llama.cpp انسٹالیشن اور ورک فلو
- vLLM انسٹالیشن اور سروسنگ
- PyTorch اسپیچ ورک فلو
اپنا ماحول تیار کریں
Python 3.12 استعمال کریں اور اس بیک اینڈ کے لیے الگ ماحول بنائیں جسے آپ استعمال کرنا چاہتے ہیں۔ ماحول الگ رکھنے سے llama.cpp، vLLM، Diffusers، اور PyTorch کے درمیان انحصاری تنازعات سے بچنے میں مدد ملتی ہے۔
MACaQ ریپوزٹری کلون کریں اور اس کی ڈائریکٹری میں جائیں۔
منتخب بیک اینڈ کے لیے Python 3.12 کا ورچوئل ماحول بنائیں۔
اس بیک اینڈ کی README کی پیروی کرتے ہوئے اس کے انحصارات اور مطلوبہ رن ٹائم انسٹال کریں۔
بیک اینڈ گائیڈ میں بیان کردہ اصل ماڈل، کیلیبریشن ڈیٹا، اور آؤٹ پٹ ڈائریکٹری تیار کریں۔
درست انسٹالیشن کمانڈز بیک اینڈ اور ماڈل فیملی پر منحصر ہوتی ہیں، اس لیے ہر ورک فلو پر ایک عمومی انسٹالیشن کمانڈ لاگو کرنے کے بجائے منسلک README استعمال کریں۔
Diffusers کے ساتھ جنریٹو ماڈلز کو کوانٹائز کریں
Diffusers بیک اینڈ ڈفیوژن ٹرانسفارمرز کو سنبھالتا ہے اور کوانٹائزڈ safetensors چیک پوائنٹس محفوظ کرتا ہے۔ یہ تصویر، ویڈیو، تصویر سے ویڈیو، اور آڈیو جنریشن کو سپورٹ کرتا ہے۔
ریپوزٹری میں black-forest-labs/FLUX.2-klein-4B، Wan-AI/Wan2.2-TI2V-5B-Diffusers، اور ylacombe/stable-audio-1.0 سمیت ماڈلز کے لیے ورک فلو موجود ہیں۔ تصویر سے ویڈیو بنانے والے ماڈلز کے لیے کیلیبریشن میں کنڈیشنگ تصاویر استعمال کی جا سکتی ہیں، تاکہ کوانٹائزیشن کا عمل مطلوبہ ان پٹ پیٹرن کی عکاسی کرے۔
Diffusers گائیڈ کھولیں اور تصویر، ویڈیو، یا آڈیو ورک فلو منتخب کریں۔
ایک مختص Python 3.12 ماحول میں بیک اینڈ کی ضروریات انسٹال کریں۔
ماخذ ماڈل ڈاؤن لوڈ کریں یا اس کی شناخت کریں اور منتخب کردہ ترکیب کے لیے مطلوبہ کیلیبریشن ان پٹس تیار کریں۔
W4A4 safetensors چیک پوائنٹ محفوظ کرنے کے لیے دستاویزی کوانٹائزیشن کمانڈ چلائیں۔
تصویر، ویڈیو، یا آڈیو نتیجہ تیار کرنے کے لیے متعلقہ جنریشن کمانڈ استعمال کریں۔
llama.cpp کے ساتھ متنی ماڈلز کو کوانٹائز کریں
llama.cpp بیک اینڈ متنی جنریشن کے لیے مختصر GGUF فائلیں تیار کرتا ہے۔ یہ 2-بٹ، 3-بٹ، اور 4-بٹ GGUF فارمیٹس کو سپورٹ کرتا ہے اور نتیجے میں حاصل ہونے والے ماڈل سے متن تیار کرنے کے لیے رن ٹائم بھی شامل کرتا ہے۔
ریپوزٹری میں Qwen/Qwen3-4B جیسے ڈینس ماڈلز، Qwen/Qwen3.8-27B جیسے ہائبرڈ ماڈلز، اور Qwen/Qwen3-30B-A3B اور Qwen/Qwen3-Coder-30B-A3B-Instruct جیسے مکسچر آف ایکسپرٹس ماڈلز کے لیے دستاویزات موجود ہیں۔ اس میں Qwen3.6-35B-A3B اور Qwen3.8-Flash-Next کے لیے ترکیبات بھی شامل ہیں۔
معیاری کوانٹائزیشن ورک فلو
llama.cpp گائیڈ کھولیں اور اپنے ماڈل کے آرکیٹیکچر سے مطابقت رکھنے والی ترکیب منتخب کریں۔
ایک مختص Python 3.12 ماحول میں llama.cpp بیک اینڈ اور اس کے انحصارات انسٹال کریں۔
منتخب کردہ ترکیب میں بیان کردہ اصل Hugging Face ماڈل اور کیلیبریشن متن تیار کریں۔
دستاویزی MACaQ کوانٹائزیشن ورک فلو چلائیں اور GGUF آؤٹ پٹ محفوظ کریں۔
متن تیار کرنے کے لیے شامل کردہ رن ٹائم یا مطابقت رکھنے والی llama.cpp انسٹالیشن استعمال کریں۔
ماڈل سے متعلق مخصوص تفصیلات کے لیے بیک اینڈ README میں dense، hybrid، mixture-of-experts، یا Flash-Next سیکشن دیکھیں۔ یہ ترکیبیں مختلف ماڈل architectures کے درمیان فرق کو مدِنظر رکھتی ہیں۔
GGUF ماڈل چلائیں
GGUF فائل بن جانے کے بعد اسے llama.cpp کمانڈ لائن کلائنٹ کے ساتھ چلائیں:
llama cli -m models/model-macaq-r.ggufآپ ماڈل کو llama.cpp کے ذریعے serve بھی کر سکتے ہیں:
llama serve -m models/model-macaq-r.ggufMACaQ-R کے ساتھ موجودہ GGUF فائلوں کو بہتر بنائیں
MACaQ-R موجودہ quantized GGUF فائل میں weight codes کو بہتر بناتا ہے، جبکہ اس کے native formats اور block scales برقرار رہتے ہیں۔ نتیجے میں بننے والی فائل standard llama.cpp installation کے ساتھ compatible رہتی ہے۔
یہ اس وقت مفید ہے جب آپ کے پاس پہلے سے quantized ماڈل موجود ہو اور آپ GGUF format تبدیل کیے بغیر اس کا معیار بہتر بنانا یا اسے کسی workload کے مطابق ڈھالنا چاہتے ہوں۔ README میں Hugging Face پر Qwen3.6-35B-A3B MACaQ-R ماڈل فراہم کیا گیا ہے، اور اسی درج شدہ سائز کی موازنہ کی گئی Unsloth UD-Q4_K_XL فائل کے مقابلے میں کم KL divergence رپورٹ کی گئی ہے۔
Quantized MoE GGUF کو بہتر بنانے کے لیے quantized ماڈل، اس سے مطابقت رکھنے والا اصل Hugging Face ماڈل، FP16 teacher فائل، calibration متن، output path، اور working directory فراہم کریں:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
بہتری مکمل ہونے کے بعد output کو standard llama.cpp کے ساتھ load کریں:
llama cli -m models/model-macaq-r.ggufمکمل MACaQ workflow، بشمول activation transforms، کے لیے bundled-runtime guide استعمال کریں۔
vLLM کے ساتھ ماڈلز کو quantize اور serve کریں
vLLM backend generation یا HTTP serving کے لیے compact text-model checkpoints بناتا ہے۔ W4A4 default inference mode ہے، اور backend weight-only quantization کو بھی support کرتا ہے۔
vLLM guide کھولیں اور hybrid text model یا text mixture-of-experts model کے لیے workflow منتخب کریں۔
vLLM backend کو اپنے الگ Python 3.12 environment میں install کریں۔
منتخب recipe کے لیے درکار source model اور calibration data تیار کریں۔
compact checkpoint بنانے کے لیے درج شدہ quantization command چلائیں۔
checkpoint کو local generation کے لیے load کریں یا درج شدہ HTTP server شروع کریں۔
README میں Qwen3.8-27B کا ایک موازنہ دیا گیا ہے، جس میں MACaQ W4A4 کی perplexity 2.8994 اور BF16 کی 2.8463 رپورٹ کی گئی ہے، جبکہ درج شدہ test setup میں prefill اور decode کی پیمائشیں زیادہ تیز ہیں۔
PyTorch کے ساتھ speech generators کو quantize کریں
PyTorch backend speech generation کے لیے ہے اور W4A4 checkpoints محفوظ کرتا ہے۔ Checkpoint محفوظ ہونے کے بعد calibration دوبارہ کیے بغیر اسے load کیا جا سکتا ہے۔
دستاویزی workflows میں Qwen3-TTS اور Chatterbox Turbo شامل ہیں۔
PyTorch guide کھولیں اور speech model منتخب کریں۔
ضروری PyTorch dependencies کو الگ Python 3.12 environment میں install کریں۔
ماڈل سے متعلق ہدایات کے مطابق calibration اور quantization چلائیں۔
W4A4 checkpoint محفوظ کریں۔
محفوظ شدہ checkpoint کو load کریں اور دوبارہ calibration کیے بغیر WAV audio generate کریں۔
Ascend hardware کے ساتھ MACaQ استعمال کریں
MACaQ W4A4 dense اور grouped matrix multiplication kernels، CANN سے متعلق pull requests کے ذریعے دستیاب ہیں۔ README میں ops-nn pull request 12568 میں PTO-ISA kernels اور ops-tilelang pull request 44 میں CCE backend کے ساتھ TileLang kernels کی طرف اشارہ کیا گیا ہے۔
مطابقت رکھنے والے CANN، PyTorch، اور torch_npu versions کے لیے ان projects میں build instructions پر عمل کریں۔ مکمل ماڈل execution کے لیے Ascend inference runtime کے ساتھ integration درکار ہے۔
بہتر workflows کے لیے عملی تجاویز
- Backend کو deployment target کے مطابق منتخب کریں۔ قابلِ منتقلی local text inference کے لیے GGUF اور llama.cpp، text serving کے لیے vLLM، multimodal generation کے لیے Diffusers، اور speech models کے لیے PyTorch منتخب کریں۔
- ماڈل سے متعلق مخصوص recipes استعمال کریں۔ Dense، hybrid، اور mixture-of-experts models کے لیے تیاری اور quantization کے مختلف مراحل درکار ہو سکتے ہیں۔
- Calibration data کو استعمال کے مطابق رکھیں۔ مثال کے طور پر، Diffusers image-to-video workflow calibration کے دوران conditioning images استعمال کرتا ہے۔
- Environments الگ رکھیں۔ README ہر backend اور Python 3.12 کے لیے الگ environment کی واضح سفارش کرتا ہے۔
- صرف file size نہیں، معیار کا بھی موازنہ کریں۔ یہ project quantized models کا FP16 یا دیگر quantization methods کے مقابلے میں جائزہ لینے کے لیے perplexity اور KL divergence comparisons استعمال کرتا ہے۔
- جب آپ کے پاس پہلے سے GGUF موجود ہو تو MACaQ-R استعمال کریں۔ یہ standard llama.cpp compatibility برقرار رکھتے ہوئے موجودہ quantized فائل کو بہتر بنا سکتا ہے۔
نتیجہ
MACaQ متعدد AI ورک لوڈز کے لیے ایک ہی کوانٹائزیشن طریقہ فراہم کرتا ہے، جس میں GGUF ٹیکسٹ ماڈلز سے لے کر Diffusers کے امیج، ویڈیو اور آڈیو ماڈلز، vLLM سرونگ چیک پوائنٹس اور PyTorch اسپیچ جنریٹرز شامل ہیں۔ بیک اینڈ کے لیے مخصوص README سے آغاز کریں، الگ تھلگ ماحول میں Python 3.12 استعمال کریں، کیلیبریشن کے لیے ماڈل کی ترکیب پر عمل کریں، اور اپنے مطلوبہ رن ٹائم کے ساتھ تیار کردہ چیک پوائنٹ کی توثیق کریں۔
تحقیق یا تکنیکی دستاویزات کے لیے MACaQ کا مقالہ دیکھیں۔ یہ پروجیکٹ Apache License 2.0 کے تحت جاری کیا گیا ہے۔