

یہ پروجیکٹ کیا کرتا ہے
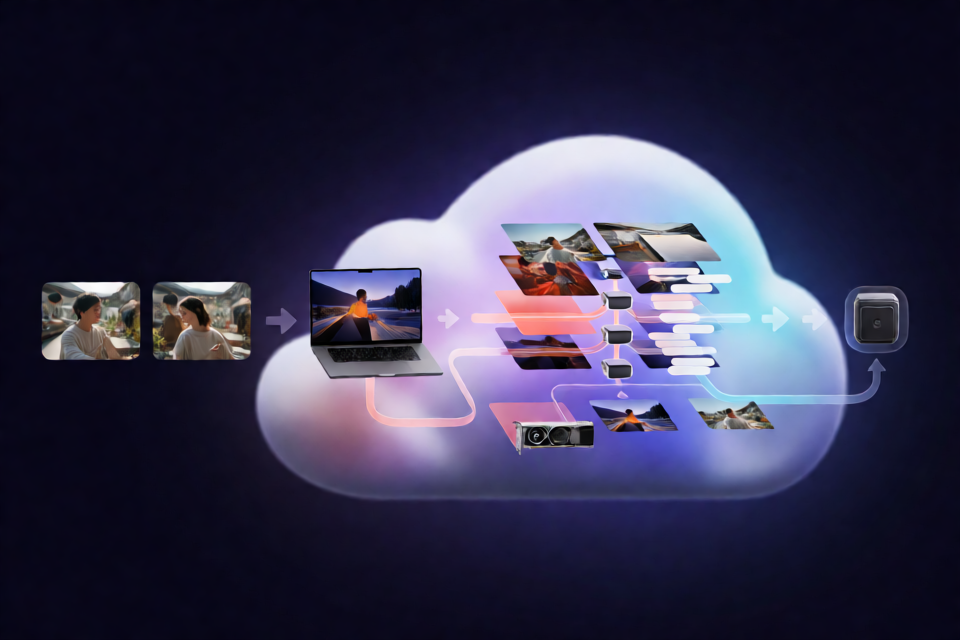
MiniMax H3 Ref2VA LoRA Colab Skill ایک قابلِ تنصیب Codex skill ہے جو جوڑی دار تصویری ڈیٹاسیٹس تیار کرنے اور Google Colab پر MiniMax H3 Ref2VA LoRA کی تربیت کے لیے استعمال ہوتی ہے۔ اس کا رنر مقامی تصاویر کو منظم کرتا ہے، ڈیٹاسیٹ پیک کرتا ہے، شامل کردہ Colab نوٹ بک شروع کرتا ہے، چیک پوائنٹس اور رن کے نمونے Google Drive میں محفوظ کرتا ہے، اور حتمی .safetensors اڈاپٹر آپ کے کمپیوٹر پر ڈاؤن لوڈ کرتا ہے۔
یہ ورک فلو خاص طور پر MiniMax H3 ٹرانسفارمر کے لیے ہے۔ H3 اپنے image-understanding پائپ لائن میں Qwen3-VL استعمال کرتا ہے، لیکن Qwen Image ایک الگ ماڈل ہے۔ Qwen Image LoRA، H3 اڈاپٹر کے ساتھ مطابقت نہیں رکھتا۔
اہم خصوصیات
- ہدف اور حوالہ/کنٹرول تصویروں کے جوڑی دار ڈیٹاسیٹس بناتا ہے۔
- دستیاب ہونے پر یکساں basename والی کیپشن فائلیں استعمال کرتا ہے۔
- قابلِ تکرار کیپشنز اور حوالہ جاتی انتخاب کے لیے JSON ڈیٹاسیٹ پلان کو سپورٹ کرتا ہے۔
- Google Colab پر Ostris AI Toolkit کے ذریعے MiniMax H3 Ref2VA LoRA کی تربیت چلاتا ہے۔
- تربیتی مراحل، LoRA rank، alpha، learning rate، GPU قسم، اور زیادہ میموری کی درخواست کو قابلِ تشکیل بناتا ہے۔
- چیک پوائنٹس، نمونے، کنفیگریشن، اور رن کا خلاصہ Google Drive کے ساتھ ہم وقت ساز کرتا ہے۔
- حتمی
.safetensorsاڈاپٹر کو مقامی آؤٹ پٹ ڈائریکٹری میں ڈاؤن لوڈ کرتا ہے۔ - Colab compute balance چیک کرنے اور ریموٹ رن ٹائم کنیکٹیویٹی جانچنے کے لیے کمانڈز فراہم کرتا ہے۔
ضروریات
Skill انسٹال کرنے سے پہلے یقینی بنائیں کہ آپ کے مقامی سسٹم میں یہ موجود ہیں:
- Python 3.10 یا اس کے بعد کا ورژن۔
- Google Colab CLI، جسے ریموٹ کمانڈز چلانے سے پہلے انسٹال اور تصدیق شدہ کیا گیا ہو۔
- ایسا Colab اکاؤنٹ جسے GPU ہارڈویئر تک رسائی حاصل ہو۔
- ضروری H3 ماڈل اور تربیتی اڈاپٹر اثاثوں تک رسائی، بشمول قابلِ اطلاق لائسنسز کی منظوری۔
- مطلوبہ تربیتی رن کے لیے کافی دستیاب Colab compute۔
شامل کردہ نوٹ بک کم از کم 60 GiB خالی ڈسک اسپیس کی جانچ کرتی ہے اور GPU VRAM، 48 GiB سے کم ہونے پر انتباہ دیتی ہے۔ پروجیکٹ زیادہ میموری والے A100 کی تجویز دیتا ہے، تاہم کم از کم VRAM کی کوئی سرکاری ضمانت موجود نہیں۔
Codex Skill انسٹال کریں
ریپوزٹری کلون کریں اور اس کا انسٹالر چلائیں:
git clone https://github.com/killkli/minimax-h3-lora-colab-skill.git
cd minimax-h3-lora-colab-skill
./install.sh
جب CODEX_HOME سیٹ ہو تو انسٹالر skill کو $CODEX_HOME/skills کے تحت رکھتا ہے۔ بصورتِ دیگر یہ ~/.codex/skills استعمال کرتا ہے۔
کسی دوسری skills ڈائریکٹری میں انسٹال کرنے کے لیے --dest فراہم کریں:
./install.sh --dest /path/to/skillsموجودہ تنصیبات بطورِ پیش فرض محفوظ رہتی ہیں۔ اگر آپ جان بوجھ کر کسی تنصیب کو تبدیل کرنا چاہتے ہیں تو --force استعمال کریں۔ انسٹالر پچھلی کاپی کو خاموشی سے حذف کرنے کے بجائے ٹائم اسٹیمپ والی بیک اپ کاپی میں منتقل کرتا ہے۔
تنصیب کی تصدیق کریں
Colab جاب شروع کیے بغیر رنر کی مدد دکھائیں:
python3 ~/.codex/skills/minimax-h3-lora-colab/scripts/runner.py --helpاگر CODEX_HOME تشکیل شدہ ہے تو ~/.codex/skills کی جگہ $CODEX_HOME/skills استعمال کریں۔ مقامی تنصیب اور مدد کی جانچ تربیت شروع نہیں کرتی اور Colab GPU وقت استعمال نہیں کرتی۔
اپنی تربیتی تصاویر تیار کریں
ہدف کی تصاویر ایک ڈائریکٹری میں رکھیں۔ تصاویر میں ایک ہی شخص یا موضوع نظر آنا چاہیے۔ آپ اختیاری طور پر یکساں basename والی ٹیکسٹ فائلوں میں کیپشنز شامل کر سکتے ہیں۔ مثال کے طور پر، photo01.jpg کی کیپشن photo01.txt میں ہو سکتی ہے۔
کلون کردہ ریپوزٹری سے ڈیٹاسیٹ تیار کریں:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
تیار کردہ ڈائریکٹری میں یہ شامل ہوتا ہے:
prepared_dataset/
├── targets/
├── references/
└── dataset_manifest.jsontargets/میں ہدف کی تصاویر اور ان کی یکساں basename والی کیپشن فائلیں شامل ہوتی ہیں۔references/میں اہداف کے ساتھ matching basenames والی حوالہ یا کنٹرول تصاویر شامل ہوتی ہیں۔dataset_manifest.jsonہر نمونے کے ماخذ، ہدف، حوالہ، اور کیپشن کا ریکارڈ رکھتا ہے۔
ڈیٹاسیٹ کی تیاری مقامی طور پر ہوتی ہے۔ یہ اصل تصاویر کو تیار کردہ ڈیٹاسیٹ میں کاپی کرتی ہے، لیکن انہیں Colab پر اپ لوڈ نہیں کرتی۔
حوالے خودکار طور پر منتخب کریں
اگر آپ الگ حوالہ فولڈر فراہم نہیں کرتے تو رنر کو کم از کم دو ہدف تصاویر درکار ہوتی ہیں۔ یہ تصاویر کو باری باری استعمال کر کے حوالہ جاتی جوڑیاں بناتا ہے۔
ممکن ہو تو ایک ہی موضوع کے متنوع اور مفید زاویے استعمال کریں۔ کسی ہدف کو اپنا ہی حوالہ نہیں بننا چاہیے۔
الگ حوالہ فولڈر استعمال کریں
کسی دوسری ڈائریکٹری سے حوالے منتخب کرنے کے لیے --reference-dir شامل کریں:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
ہر منتخب حوالہ، ہدف کے مجموعے میں موجود اسی موضوع کو دکھانا چاہیے۔ اگر آپ کسی بڑے مجموعے کے صرف ایک حصے کو منتخب کر رہے ہیں تو منتخب اہداف اور حوالے staging فولڈرز میں رکھیں اور اصل تصویری مجموعے کو برقرار رہنے دیں۔
قابلِ تکرار ڈیٹاسیٹ پلان بنائیں
ڈیٹاسیٹ پلان تصویر کے لحاظ سے کیپشنز اور اختیاری ہدف سے حوالہ جاتی انتخاب ریکارڈ کرتا ہے۔ اس سے دستی یا agent-assisted کیوریٹنگ کو قابلِ تکرار بنایا جا سکتا ہے۔
{
  "captions": {
    "photo01.jpg": "studio_subject person, waist-up portrait in a blue jacket, outdoors in soft daylight",
    "photo02.jpg": "studio_subject person, side profile wearing a white shirt, indoors by a window"
  },
  "references": {
    "photo01.jpg": "front_reference.png",
    "photo02.jpg": "side_reference.png"
  }
}
captions آبجیکٹ میں ہر ہدفی تصویر کا basename شامل ہونا چاہیے۔ اگر اختیاری references آبجیکٹ موجود ہو، تو اسے ہر ہدفی basename کو امیدوار reference ڈائریکٹری میں موجود ایک image basename سے بھی منسلک کرنا چاہیے۔
Captions میں صرف نظر آنے والی تفصیلات بیان کریں۔ غیر متعلقہ افراد یا موضوعات کو الگ datasets میں رکھیں، اور کسی ہدفی تصویر کو خود اسی تصویر سے map نہ کریں۔
درج ذیل منصوبے کے مطابق dataset تیار کریں:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --dataset-plan /path/to/dataset-plan.json \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
اگر --dataset-plan شامل نہ کیا جائے، تو runner موجودہ sidecar captions استعمال کرتا ہے اور missing captions کے لیے ایک سادہ default فراہم کرتا ہے۔
اپ لوڈ سے پہلے جائزہ
Training شروع کرنے سے پہلے dataset_manifest.json کھولیں اور ہر source، target، reference اور caption کی تصدیق کریں۔ غلط pairings، missing descriptions یا کسی مختلف subject سے متعلق تصاویر پکڑنے کے لیے یہ بہترین مرحلہ ہے۔ Training وہ مرحلہ ہے جس میں تیار شدہ تصاویر Colab runtime پر اپ لوڈ ہوتی ہیں۔
Google Colab پر LoRA کی training
تیار شدہ dataset کا جائزہ لینے کے بعد training run شروع کریں:
python3 scripts/runner.py train \
  --dataset-dir ./prepared_dataset \
  --name studio_subject \
  --trigger "studio_subject person" \
  --steps 1000 \
  --rank 16 \
  --alpha 16 \
  --gpu A100 \
  --output-dir ./outputs
Default training settings یہ ہیں:
- 1,000 training steps۔
- LoRA rank 16۔
- Alpha 16۔
- Learning rate
1e-4۔ - زیادہ میموری والا A100 Colab session۔
Notebook H3 model اور training-adapter کے لیے درکار assets ڈاؤن لوڈ کرتا ہے۔ حتمی adapter کو ./outputs/ میں .safetensors فائل کے طور پر رکھا جاتا ہے۔
Run artifacts بھی اس مقام پر synchronize کیے جاتے ہیں:
MyDrive/MiniMax_H3_LoRAs/<name>/<run-id>/Drive directory میں checkpoints، generated samples، configuration data اور run summary شامل ہوتے ہیں۔
Training parameters احتیاط سے تبدیل کریں
آپ steps، rank، alpha، GPU اور output directory کی مثال میں دی گئی values تبدیل کر سکتے ہیں۔ تمام supported training options دیکھنے کے لیے چلائیں:
python3 scripts/runner.py train --helpHigh-memory mode بطور default طلب کیا جاتا ہے۔ --no-high-mem صرف اس وقت شامل کریں جب منتخب Colab GPU allocation میں یہ درخواست شامل نہ کرنی ہو۔
Colab کے استعمال اور connectivity کی جانچ
موجودہ Colab compute balance کو JSON format میں پڑھنے کے لیے استعمال کریں:
python3 scripts/runner.py usage --jsonRemote GPU runtime فراہم کرنے اور probe، file transfer اور Google Drive path کی تصدیق کے لیے چلائیں:
python3 scripts/runner.py test
testcommand training validation نہیں ہے۔ یہ ثابت نہیں کرتا کہ MiniMax H3 training دستیاب VRAM میں مکمل ہو جائے گی یا کامیابی سے ختم ہوگی۔
اعلیٰ درجے کی تجاویز اور عملی رہنمائی
Subject sets کو مرکوز رکھیں
ہر dataset میں ایک ہی شخص یا subject کی تصاویر استعمال کریں۔ غیر متعلقہ subjects کو الگ رکھنے سے captions اور reference mappings زیادہ واضح رہتی ہیں اور runner کے متوقع workflow کی پابندی ہوتی ہے۔
تصویر کے مطابق captions استعمال کریں
صرف generic caption پر انحصار کرنے کے بجائے pose، clothing، framing، environment اور lighting جیسی نظر آنے والی خصوصیات بیان کریں۔ منتخب trigger کو مستقل طور پر شامل کریں، لیکن ایسی تفصیلات شامل نہ کریں جو تصویر میں نظر نہیں آتیں۔
مفید reference diversity کو ترجیح دیں
ایسے references منتخب کریں جو مختلف views فراہم کریں، مگر پھر بھی اسی subject کو دکھاتے ہوں۔ مثال کے طور پر، جہاں مناسب ہو front-facing اور side-profile views کو pair کریں۔ کسی target کو خود اسی سے کبھی pair نہ کریں۔
قابلِ جائزہ ریکارڈ محفوظ رکھیں
Dataset plan اور generated manifest کو project کے ساتھ محفوظ رکھیں۔ یہ دونوں مل کر کسی run کے لیے استعمال ہونے والے captions اور pairings کا ریکارڈ رکھتے ہیں اور preparation process کا audit یا اعادہ آسان بناتے ہیں۔
مقامی اور cloud outputs کی نگرانی کریں
Local output directory میں downloaded final adapter ہوتا ہے، جبکہ Google Drive وسیع تر run artifacts محفوظ رکھتا ہے۔ اگر training run غیر متوقع طور پر رک جائے تو checkpoints، samples، configuration اور run summary دیکھنے کے لیے Drive copy استعمال کریں۔
Hardware fit کو runtime پر منحصر سمجھیں
تجویز کردہ high-memory A100 کامیابی کی ضمانت نہیں دیتا۔ اصل memory fit کا انحصار Colab runtime اور training configuration پر ہوتا ہے۔ Notebook 48 GiB سے کم VRAM پر warning دیتا ہے اور 60 GiB خالی disk کی جانچ کرتا ہے، لیکن یہ checks hardware کی سرکاری ضمانت نہیں ہیں۔
Validation status کو سمجھیں
Upstream AI Toolkit Ref2VA example configuration کو unverified قرار دیا گیا ہے۔ اس لیے repository یہ دعویٰ نہیں کرتی کہ ہر cloud training run کامیاب ہوگا۔ Notebook قابلِ تکرار نتائج کے لیے inspected AI Toolkit source commit کو pin کرتا ہے، لیکن successful installation یا remote probe کو end-to-end training مکمل ہونے کا ثبوت نہیں سمجھنا چاہیے۔
مزید مطالعہ
- MiniMax H3 model architecture
- Ostris AI Toolkit MiniMax-H3 Ref2VA documentation
- Pinned AI Toolkit H3 implementation
نتیجہ
MiniMax H3 Ref2VA LoRA Colab Skill مقامی تصاویر کی ترتیب سے لے کر ڈاؤن لوڈ کیے جا سکنے والے H3 اڈاپٹر تک ایک قابلِ تکرار طریقہ فراہم کرتا ہے۔ ہدف اور حوالہ تصاویر کے جوڑوں کو مقامی طور پر تیار اور جانچیں، جب قابلِ تکرار کیپشنز اور میپنگز درکار ہوں تو ڈیٹاسیٹ پلان استعمال کریں، اپنے Colab وسائل اور لائسنسز کی تصدیق کریں، پھر تربیت شروع کریں۔ یاد رکھیں کہ اپ اسٹریم کنفیگریشن کی ابھی تصدیق نہیں ہوئی اور Qwen Image LoRAs، MiniMax H3 اڈاپٹرز کے ساتھ قابلِ تبادلہ نہیں ہیں۔