

Tiny Classifiers کیا کرتا ہے
tiny-classifiers چھوٹے، مخصوص کاموں کے لیے بنائے گئے ٹیکسٹ کلاسیفائرز کی تربیت کا ایک عملی طریقہ ہے۔ یہ 17 ملین پیرامیٹرز والے Ettin-17M encoder کا استعمال کرتا ہے، اس کے تمام وزنوں کو فائن ٹیون کرتا ہے، اور نتیجے کو ایک معیاری Hugging Face ماڈل کے طور پر محفوظ کرتا ہے۔
یہ منصوبہ بینک پیغامات کی روٹنگ، خبروں کی درجہ بندی، صارف کی نیت کی شناخت، جذبات کا پتا لگانے، یا قانونی دستاویزات کو پہلے سے متعین زمروں میں رکھنے جیسے کلاسیفیکیشن کاموں کے لیے بنایا گیا ہے۔ اگر آپ کے پاس لیبل شدہ مثالیں کافی نہ ہوں، تو ایک بڑا لینگویج ماڈل استاد کے طور پر کام کرتے ہوئے تربیتی ڈیٹا سیٹ کو لیبل کر سکتا ہے۔
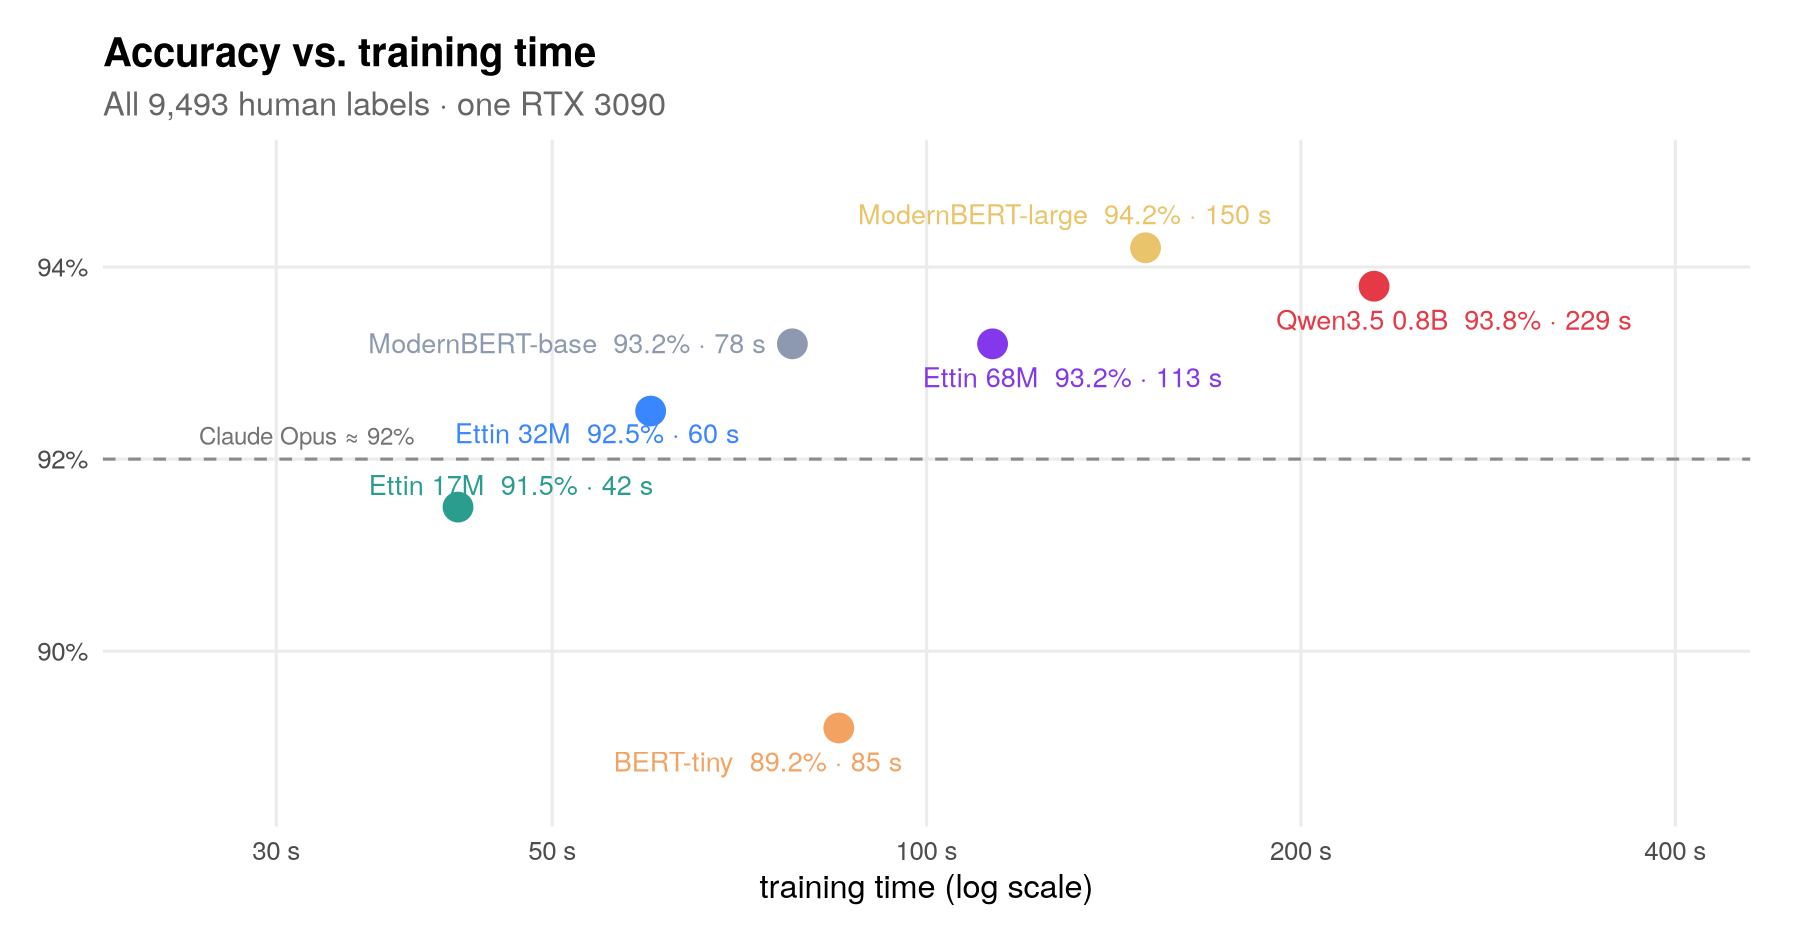
ریپوزٹری کے Banking77 تجربے میں Ettin-17M نے 91.5% درستگی حاصل کی، جبکہ Claude Opus کی درستگی 92% تھی۔ ایک گیمنگ GPU پر تربیت میں 42 سیکنڈ لگے، جبکہ inference میں فی پیغام تقریباً 5 ملی سیکنڈ لگے۔ تربیت لیپ ٹاپ CPU پر تقریباً 11 منٹ اور فون GPU پر تقریباً 21 منٹ میں بھی مکمل ہوئی۔
Banking77 کی درستگی کا تربیتی وقت کے ساتھ موازنہ۔
اہم خصوصیات
- چھوٹا مقامی ماڈل: Ettin-17M میں 17 ملین پیرامیٹرز ہیں اور یہ ہر زمرے کے لیے ایک اسکور تیار کرتا ہے۔
- انسانی یا استاد کے لیبل: تصدیق شدہ لیبلز کے ساتھ تربیت دیں یا بغیر لیبل والے پیغامات کو لیبل کرنے کے لیے Kimi K3 سے کہیں۔
- GPU اور CPU پر تربیت: تربیتی اسکرپٹ دونوں ماحولوں کو سپورٹ کرتی ہے۔
- معیاری ماڈل آؤٹ پٹ: تربیت یافتہ کلاسیفائرز کو Hugging Face کی
transformersپائپ لائن کے ذریعے لوڈ کیا جا سکتا ہے۔ - دوبارہ شروع ہونے والی لیبلنگ: لیبلنگ اسکرپٹ دوبارہ کوششوں، موافق concurrency، سست درخواستوں کے لیے hedging، اور provider budgets کو سپورٹ کرتی ہے۔
- بلٹ اِن جائزہ: تربیت ٹیسٹ کی درستگی رپورٹ کرتی ہے، جبکہ استاد کی لیبلنگ کسی لیبل شدہ ٹیسٹ سیٹ پر استاد کی درستگی ناپ سکتی ہے۔
- لاگت کا تجزیہ: break-even اسکرپٹ اندازہ لگاتی ہے کہ لیبلنگ اور تربیت کب API کے ذریعے کلاسیفیکیشن کی ادائیگی سے سستی ہو جاتی ہے۔
- قابلِ دوبارہ استعمال ڈیٹا کی تیاری: یہ منصوبہ ایک ہی مستقل ساخت استعمال کرتے ہوئے دس عوامی کلاسیفیکیشن ڈیٹا سیٹس تیار کر سکتا ہے۔
تربیتی طریقہ کیسے کام کرتا ہے
Ettin-17M Johns Hopkins کا ایک اوپن encoder ہے اور BERT طرز کے ماڈلز سے متعلق ہے۔ ایسے generative ماڈل کے برعکس جو ٹوکن بہ ٹوکن متن تیار کرتا ہے، یہ مکمل input پڑھتا ہے اور ہر دستیاب زمرے کے لیے ایک اسکور مقرر کرتا ہے۔
ریپوزٹری ہر زمرے کے لیے ایک output شامل کرتی ہے اور ماڈل کے ہر وزن کو فائن ٹیون کرتی ہے۔ اس کا طے شدہ طریقہ 32 کا batch size، 1e-4 کی learning rate کے ساتھ AdamW، 0.01 کا weight decay، 5% warm-up کے بعد cosine decay، 1.0 پر gradient clipping، اور cross-entropy loss استعمال کرتا ہے۔
تقریباً 9,500 پیغامات کے لیے تربیت چھ passes تک چلتی ہے۔ صرف 2,000 مثالوں کے ساتھ یہ اتنے ہی optimization steps استعمال کرتی ہے، جو تقریباً 28 passes کے برابر ہیں۔ README واضح کرتی ہے کہ یہ ترتیبات ہر کام کے لیے الگ سے tuned نہیں ہیں۔
انسٹالیشن اور سیٹ اپ
1. uv انسٹال کریں
اسکرپٹس ضروری ماحول بنانے اور پہلی بار چلنے پر dependencies خودکار طور پر انسٹال کرنے کے لیے uv استعمال کرتی ہیں۔ اپنے آپریٹنگ سسٹم کے لیے دی گئی ہدایات کے مطابق uv انسٹال کریں، پھر ریپوزٹری کی root directory میں ٹرمینل کھولیں۔
2. عوامی ڈیٹا سیٹس تیار کریں
تیاری کا اسکرپٹ چلائیں:
uv run recipe/prepare.pyیہ Hugging Face Hub سے Banking77، CLINC150، انگریزی اور فرانسیسی میں MASSIVE، TREC، AG News، SST-5، Financial PhraseBank، LEDGAR، اور ٹویٹس پر مبنی hate-speech ڈیٹا سیٹ ڈاؤن لوڈ کرتا ہے۔
ہر کام کے لیے اسکرپٹ data/tasks/ کے تحت ایک ڈائریکٹری بناتا ہے۔ یہ task definition، 2,000 تربیتی پیغامات، ایک بڑا training split جس میں ہر زمرے سے زیادہ سے زیادہ 150 مثالیں ہوتی ہیں، اور ایک test set تیار کرتا ہے۔
3. لیبلنگ provider کو ترتیب دیں
اگر آپ استاد ماڈل سے لیبلز تیار کروانا چاہتے ہیں، تو ایک یا زیادہ معاون providers کے لیے API key مقرر کریں:
export OPENROUTER_API_KEY=...یہ طریقہ Fireworks، Together، DeepInfra، اور Parasail سے متعلق provider keys کو بھی پہچانتا ہے۔ ڈیٹا بھیجنے یا تیار کردہ جوابات کو تربیت کے لیے استعمال کرنے سے پہلے متعلقہ provider کی موجودہ قیمتوں، استعمال کی پالیسیوں، اور ماڈل کی شرائط کا جائزہ لیں۔
بنیادی ٹیوٹوریل: AG News کلاسیفائر کی تربیت
مرحلہ 1: Kimi K3 کے ذریعے لیبلز تیار کریں
ڈیٹا سیٹس تیار کرنے کے بعد، 2,000 AG News تربیتی پیغامات کو لیبل کریں:
uv run recipe/label.py data/tasks/agnewsرپورٹ کیے گئے run میں Kimi K3 نے 2,000 مثالوں کو تقریباً 20 سیکنڈ میں اور تقریباً $1 میں لیبل کیا۔ اصل وقت اور لاگت provider کے لحاظ سے مختلف ہو سکتی ہے۔ اسکرپٹ دوبارہ شروع کی جا سکتی ہے، اس لیے رکا ہوا لیبلنگ کام ابتدا سے شروع کرنے کی ضرورت نہیں ہوتی۔
مرحلہ 2: استاد کے لیبلز پر Ettin-17M کو فائن ٹیون کریں
تیار کردہ label file کو training script میں دیں اور output directory منتخب کریں:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsاسکرپٹ کلاسیفائر کو فائن ٹیون کرتی ہے، test set پر اس کا جائزہ لیتی ہے، test accuracy پرنٹ کرتی ہے، اور Hugging Face کے ساتھ مطابقت رکھنے والا ماڈل models/agnews کے تحت محفوظ کرتی ہے۔
مرحلہ 3: انسانی لیبلز کا baseline تیار کریں
ڈیٹا سیٹ کے اصل انسانی لیبلز پر تربیت کے لیے وہی training script استاد کے لیبل والے argument کے بغیر چلائیں:
uv run recipe/train.py data/tasks/agnewsیہ موازنہ ظاہر کرنے میں مدد دیتا ہے کہ knowledge distillation کے دوران کتنی کارکردگی ضائع ہوئی۔ ریپوزٹری کے tutorial run میں انسانی لیبلز نے 89.2% درستگی، Kimi K3 کے لیبلز نے 85.1%، اور Qwen3.8-27B کے لیبلز نے 81.8% درستگی حاصل کی۔
مرحلہ 4: نئے متن کی درجہ بندی کریں
Hugging Face پائپ لائن کے ذریعے محفوظ کیا گیا ماڈل لوڈ کریں:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
نتیجہ ایک ایسی فہرست ہے جس میں متوقع لیبل اور اس کا اسکور شامل ہوتا ہے۔ اس مثال کے لیے متوقع زمرہ Sci/Tech ہے۔ رپورٹ کیے گئے AG News ماڈل نے CPU پر ایک پیغام تقریباً 6 ملی سیکنڈ میں پروسیس کیا۔
اپنے ڈیٹا کے ساتھ Tiny Classifiers استعمال کریں
1. ٹاسک ڈائریکٹری بنائیں
data/tasks/agnews/ جیسا ہی لے آؤٹ استعمال کرتے ہوئے ایک فولڈر بنائیں۔ ہر کسٹم ٹاسک کے لیے task.json، train.jsonl، اور test.jsonl فائل درکار ہے۔
2. زمرے متعین کریں
task.json فائل میں نام، ایک ہدایتی جملہ، اور لیبلز کی مکمل فہرست شامل ہونی چاہیے:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}ایسے لیبل نام استعمال کریں جو ایک دوسرے سے مختلف اور بامعنی ہوں۔ ہدایت میں واضح طور پر بیان ہونا چاہیے کہ ماڈل یا ٹیچر کو درجہ بندی کا کون سا فیصلہ کرنا ہے۔
3. تربیتی اور ٹیسٹ ریکارڈز شامل کریں
ہر سطر میں ایک JSON آبجیکٹ محفوظ کریں۔ لیبل شدہ ریکارڈ کی ساخت یہ ہے:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}اگر ٹیچر ماڈل تربیتی ڈیٹا کو لیبل کرے گا تو train.jsonl کے ریکارڈز میں label فیلڈ شامل نہ بھی ہو سکتی ہے:
{"id":"msg-002","text":"The application closes whenever I upload a file."}ٹیسٹ ریکارڈز میں تصدیق شدہ لیبلز ہونے چاہییں تاکہ آپ ٹیچر اور طالب علم، دونوں کی درستگی ناپ سکیں۔ پروجیکٹ تجویز کرتا ہے کہ پروڈکشن میں ماڈل پر اعتماد کرنے سے پہلے چند سو ٹیسٹ پیغامات کو دستی طور پر جانچ لیا جائے۔
4. لیبل کریں، تربیت دیں، اور جائزہ لیں
معیاری کمانڈز میں اپنی ڈائریکٹری شامل کریں:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
آپ --labels حذف کرکے براہِ راست انسانی لیبلز پر بھی تربیت دے سکتے ہیں۔ Ettin-17M کے بجائے کوئی دوسرا انکوڈر استعمال کرنے کے لیے ماڈل کو تربیتی اسکرپٹ کے --model آپشن کے ذریعے فراہم کریں۔
معلوم کریں کہ Fine-Tuning کب فائدہ مند ہے
ٹاسکس تیار کرنے کے بعد بریک ایون تجزیہ چلائیں:
uv run recipe/breakeven.pyیہ اسکرپٹ اندازہ لگاتا ہے کہ لیبلنگ اور تربیت کے ابتدائی اخراجات پورے ہونے سے پہلے کتنے پیغامات کی درجہ بندی ضروری ہے، اور اس میں رقم اور وقت دونوں کو مدنظر رکھا جاتا ہے۔ Jev زیرو شاٹ درجہ بندی API کے مقابلے میں، ریپوزٹری نے ٹاسک کے لحاظ سے تقریباً 50,000 سے 500,000 پیغامات کے بریک ایون پوائنٹس پائے۔
اگر آپ کا حجم کم یا غیر یقینی ہے تو API زیادہ آسان انتخاب ہو سکتی ہے۔ Fine-tuning اس وقت زیادہ پُرکشش بنتی ہے جب ٹاسک مستحکم ہو، جائزے کا ڈیٹا موجود ہو، اور درجہ بندی کا حجم زیادہ ہو۔
اعلیٰ درجے کی تجاویز
لیبل کے معیار کو ترجیح دیں
تجربات سے معلوم ہوا کہ ماڈل کے حجم سے زیادہ اہم لیبلز ہیں۔ مزید لیبل شدہ مثالیں شامل کرنے پر لرننگ کروز میں مسلسل بہتری آتی رہی۔ ٹیچر سے تربیت یافتہ طالب علم عموماً اپنے ٹیچر سے درستگی کے چند پوائنٹس پیچھے رہا، جبکہ انسانی لیبلز اس حد کو توڑ سکتے تھے۔
مبہم زمروں کا جائزہ لیں، منظم لیبلنگ کی غلطیوں کو درست کریں، اور آرکیٹیکچر تبدیل کرنے یا بہت سے ہائپرپیرامیٹرز کو ٹیون کرنے سے پہلے نمائندہ مثالیں شامل کریں۔
ٹیچر کا الگ سے جائزہ لیں
جو ٹیچر ٹاسک پر کمزور کارکردگی دکھاتا ہو، طالب علم قابلِ اعتماد طور پر اس کی تلافی نہیں کر سکتا۔ دس ٹاسکس کے نتائج سے ظاہر ہوا کہ جہاں ٹیچر خود کمزور تھا، وہاں ٹیچر سے لیبل شدہ ماڈلز پیچھے رہ گئے۔ انسانی طور پر جانچے گئے ٹیسٹ سیٹ کو برقرار رکھیں اور بہت بڑے مجموعے کی لیبلنگ پر خرچ کرنے سے پہلے ٹیچر کی درستگی ناپیں۔
تجرباتی فرق کو مدنظر رکھیں
README میں بے ترتیب سیڈز سے تقریباً ±0.5 فیصد پوائنٹس اور ٹیسٹ سیٹ کے حجم سے ±1.5 سے 2 پوائنٹس تک فرق رپورٹ کیا گیا ہے۔ شائع شدہ جدولیں تین رنز کے اوسط کو استعمال کرتی ہیں۔ جب درستگی کے معمولی فرق تعیناتی کے فیصلوں پر اثر انداز ہوں تو متعدد رنز اور مناسب حجم کے ٹیسٹ سیٹس استعمال کریں۔
لائسنس اور فراہم کنندہ کی شرائط کا احترام کریں
تربیت کے لیے تیار کردہ جوابات صرف اسی وقت استعمال کریں جب ٹیچر ماڈل کا لائسنس اور فراہم کنندہ کی شرائط اس کی اجازت دیں۔ ریپوزٹری نے Kimi K3 استعمال کیا، لیکن کچھ ماڈلز اور APIs اپنے آؤٹ پٹس کو کسی دوسرے ماڈل کی تربیت کے لیے استعمال کرنے سے منع کرتے ہیں۔ عوامی ڈیٹاسیٹس کے اپنے لائسنس بھی برقرار رہتے ہیں؛ ریپوزٹری انہیں دوبارہ تقسیم کرنے کے بجائے ڈاؤن لوڈ کرتی ہے۔
متبادل ہارڈویئر آزمائیں
مرکزی تربیتی اسکرپٹ CPU اور GPU پر عمل درآمد کو سپورٹ کرتا ہے۔ ریپوزٹری میں فون کا ایک الگ نفاذ بھی شامل ہے جو WebGPU اور jax-js کے ذریعے Chrome میں تربیت دیتا ہے۔ فون کے ورک فلو کو ایک مخصوص نفاذ سمجھیں اور پروجیکٹ کی phone/ ڈائریکٹری میں دی گئی ہدایات پر عمل کریں۔
دستاویزی NixOS مسئلے کا حل اپنائیں
اگر /sbin/ldconfig نہ ملنے کی وجہ سے NixOS پر تربیت ناکام ہو جائے تو تربیت چلانے سے پہلے CUDA لائبریری پاتھ مقرر کریں:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libنتیجہ
tiny-classifiers لیبل شدہ متن کو تیز رفتار مقامی درجہ بندی ماڈل میں تبدیل کرنے کے لیے ایک مختصر ورک فلو فراہم کرتا ہے: ٹاسک تیار کریں، انسانی یا ٹیچر لیبلز حاصل کریں، Ettin-17M کو fine-tune کریں، تصدیق شدہ مثالوں کے مقابلے میں جائزہ لیں، اور اندازہ لگائیں کہ معاشی اعتبار سے مقامی inference کسی API سے بہتر ہے یا نہیں۔
سب سے اہم سبق قابلِ اعتماد لیبلز اور جائزے کے ڈیٹا میں سرمایہ کاری کرنا ہے۔ جب یہ موجود ہوں تو 17 ملین پیرامیٹرز والا انکوڈر مضبوط درجہ بندی کی درستگی، ملی سیکنڈ کی سطح پر inference، اور قابلِ پیش گوئی مقامی عملی اخراجات فراہم کر سکتا ہے، اور ہر پیغام کے لیے بڑے ماڈل کو کال کرنے کی ضرورت نہیں رہتی۔