

گریجویٹ داخلہ ایجنٹ بینچ مارک کیا کرتا ہے
گریجویٹ داخلہ ایجنٹ بینچ مارک، گریجویٹ داخلوں کے مشورے کے لیے ایجنٹ کی تشکیلوں کا جائزہ لیتا ہے۔ ایجنٹ کی تشکیل میں ایک ایگزیکیوشن سسٹم اور زبان کا ماڈل شامل ہوتا ہے، اور اسے درخواست سے متعلق سفارشات، منصوبہ بندی، فیصلہ سازی، اور طالب علم کی نئی معلومات دستیاب ہونے پر مشورے میں تازہ کاری کے کاموں پر آزمایا جاتا ہے۔
بینچ مارک میں فی الحال چینی زبان کے 70 کام، 23 کیسز، اور جواب کے 83 مراحل شامل ہیں۔ ہر کام کے لیے جائزے کے معیارات اور حوالہ پروگرام موجود ہیں۔ عوامی ڈیٹاسیٹ رسائی کی منظوری کے بغیر دستیاب ہے، لیکن اسکورنگ کا مواد زیرِجائزہ ایجنٹس کے لیے دستیاب نہیں ہونا چاہیے تاکہ نتائج آلودہ نہ ہوں۔
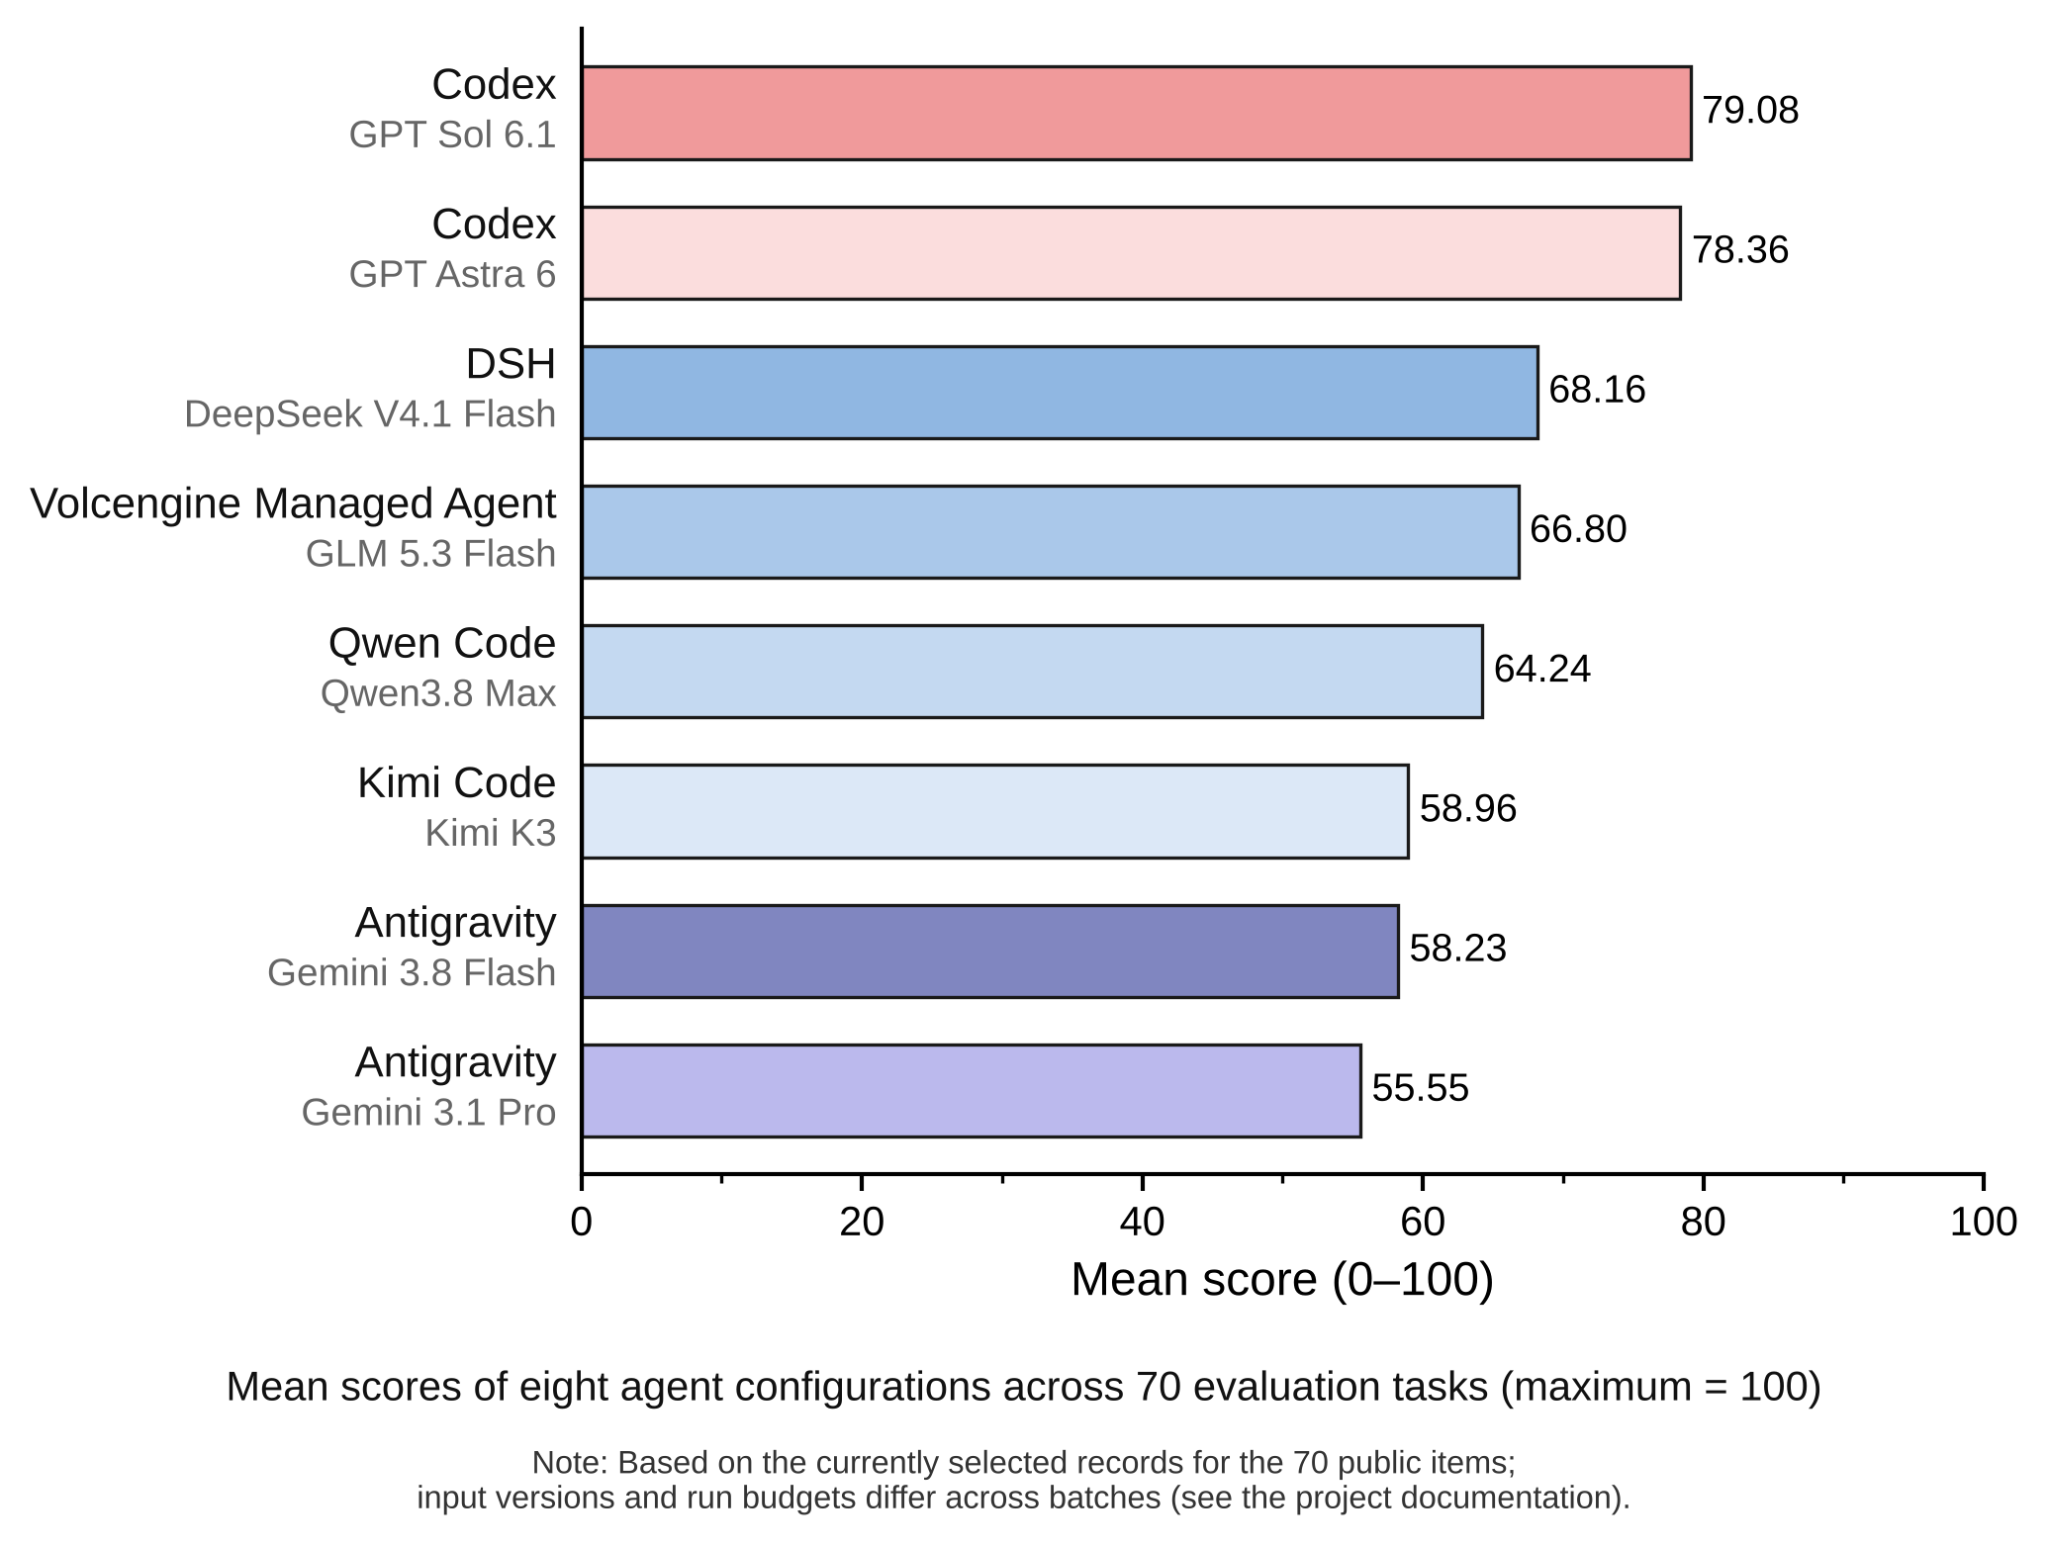
ریپوزٹری آٹھ تشکیلوں کے جائزے کے ریکارڈ بھی شائع کرتی ہے۔ ہر تشکیل نے موجودہ 70 کام مکمل کیے، تاہم پروجیکٹ کے مطابق رنز میں مختلف ان پٹ ورژنز اور بجٹ استعمال ہوئے، اس لیے لیڈر بورڈ کے نتائج کو مکمل طور پر یکساں تجربات نہیں سمجھنا چاہیے۔
جائزے کی ساخت کو سمجھیں
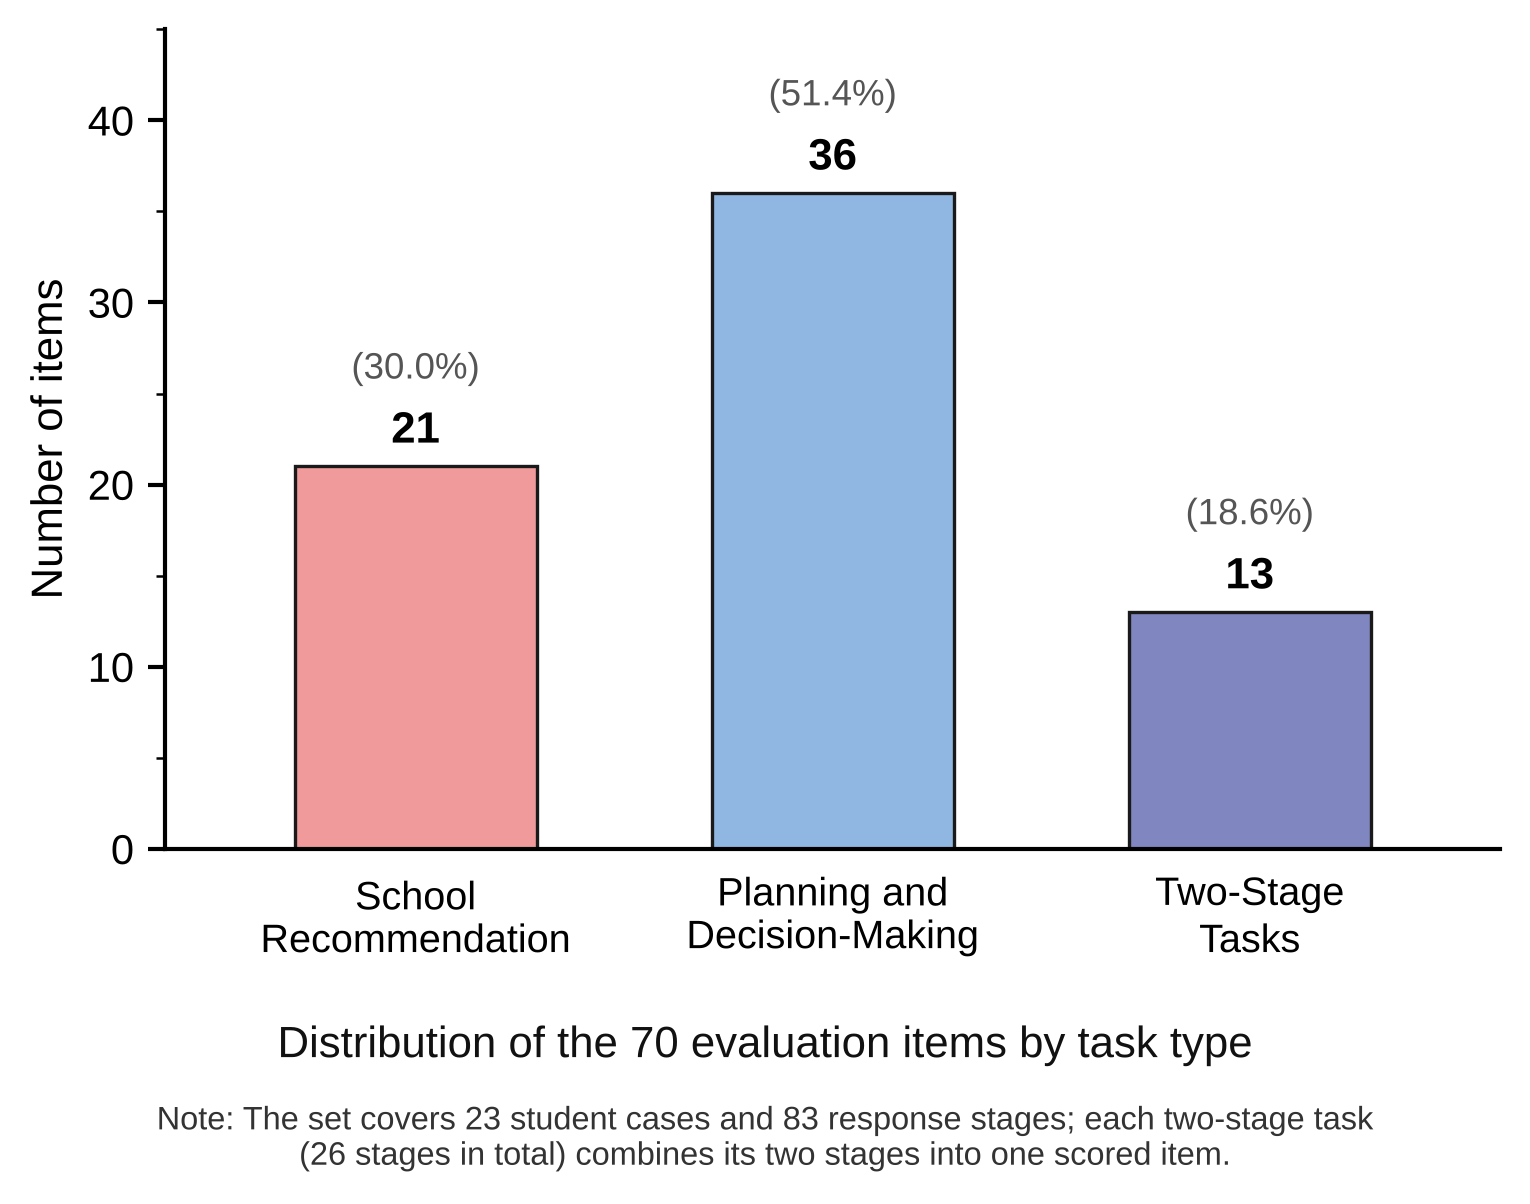
کاموں کا مجموعہ تین زمروں میں تقسیم ہے:
- 21 سفارشاتی کام: یہ جانچتے ہیں کہ تجویز کردہ پروگرام طالب علم کے پس منظر اور پابندیوں سے کتنے مطابقت رکھتے ہیں۔
- 36 منصوبہ بندی اور فیصلہ سازی کے کام: تیاری کے منصوبوں، خطرے کے جائزے، اور قابلِعمل مشورے کا جائزہ لیتے ہیں۔
- 13 دو مرحلہ جاتی کام: اسی سیشن میں نئی معلومات فراہم کرتے ہیں اور جانچتے ہیں کہ آیا ایجنٹ اپنے پہلے مشورے پر نظرثانی کرتا ہے۔
ہر کام کے 100 پوائنٹس ہیں۔ سفارشاتی کاموں میں 70 پوائنٹس حوالہ پروگرام سے مطابقت اور 30 پوائنٹس سفارش کے معیار کے لیے مختص ہیں۔ ایک الگ جائزہ لینے والا مکمل جواب کو اسکور کرتا ہے، جبکہ معیارات جواب دینے کے عمل سے باہر رہتے ہیں۔
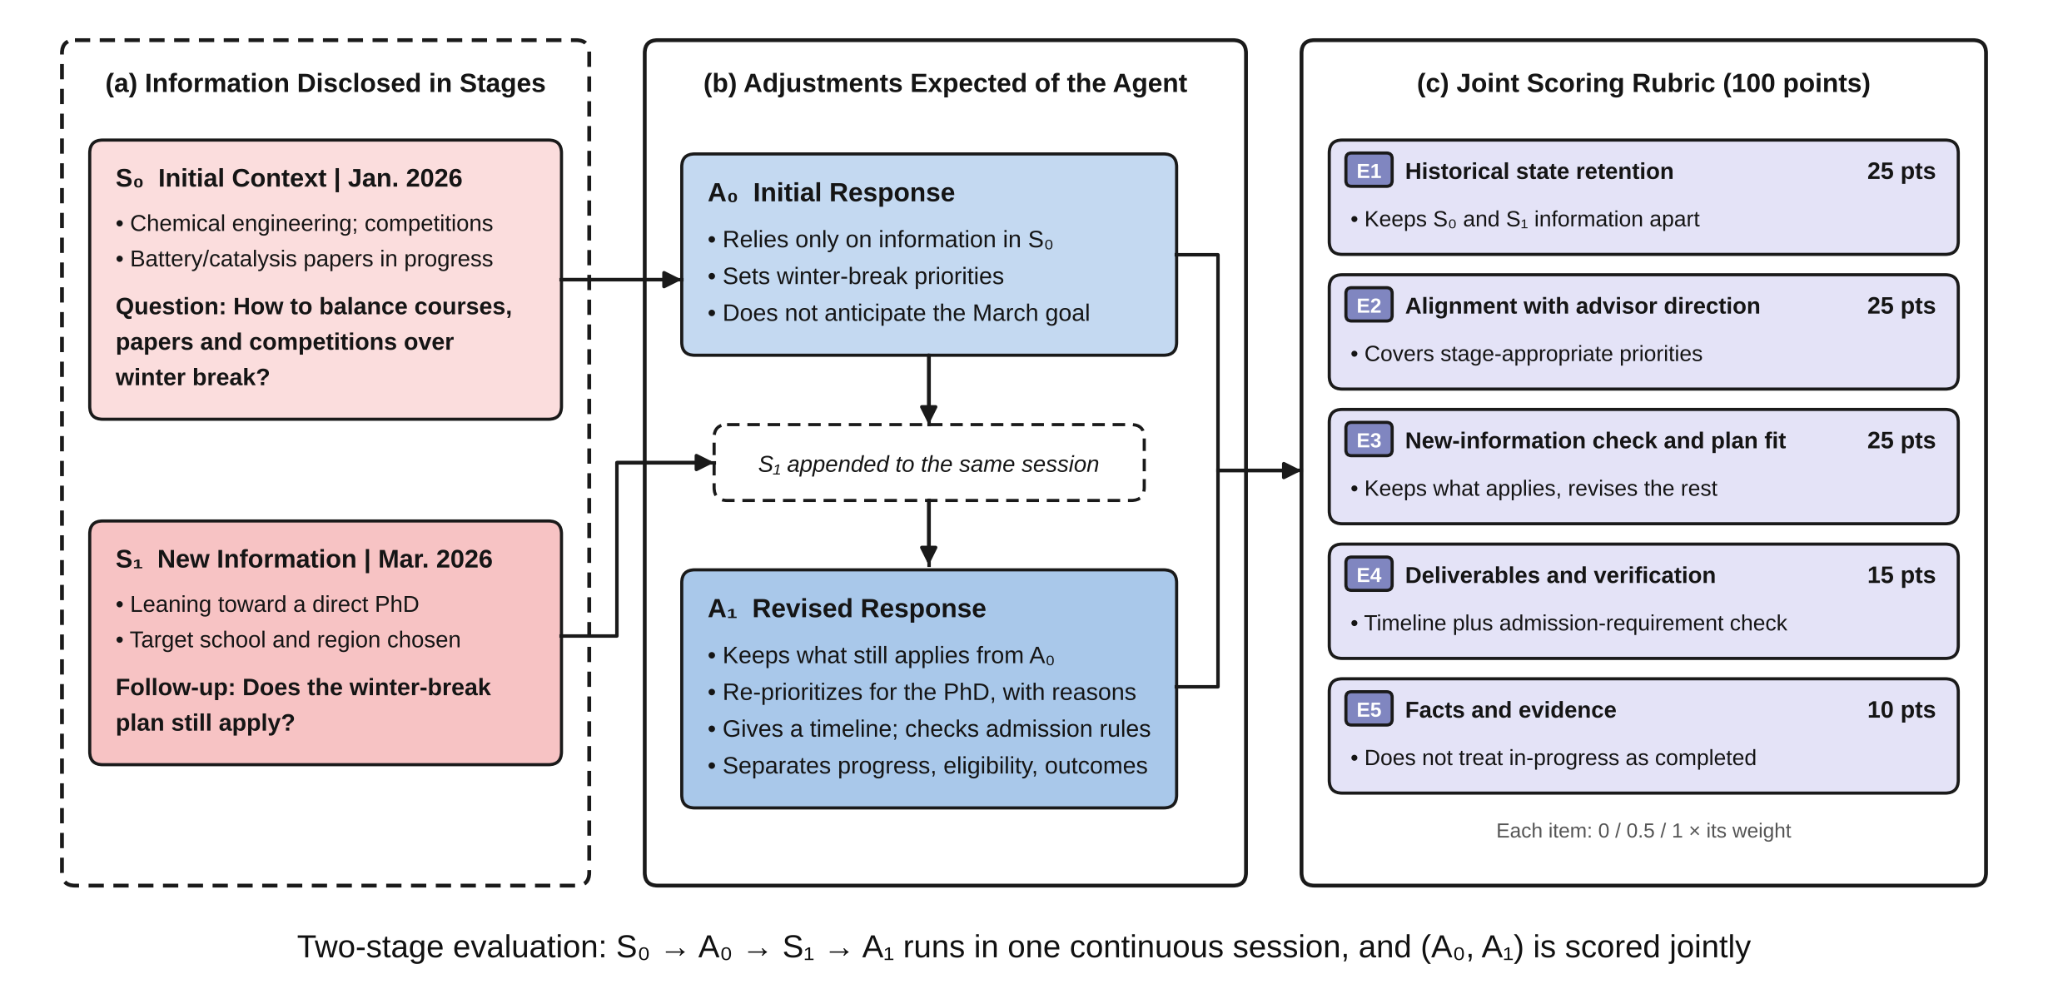
دو مرحلہ جاتی کام ابتدائی سیاق، جسے S₀ کہا جاتا ہے، سے شروع ہوتے ہیں، اور پھر تازہ معلومات فراہم کرتے ہیں، جسے S₁ کہا جاتا ہے۔ ایجنٹ ایک ہی سیشن میں ابتدائی جواب، A₀، اور نظرثانی شدہ جواب، A₁، تیار کرتا ہے۔ دونوں جوابات کا مشترکہ اسکور کیا جاتا ہے۔ عوامی O03-04 مثال جنوری سے مارچ تک کے ایک ایسے منظرنامے کو دکھاتی ہے جس میں طالب علم براہِ راست پی ایچ ڈی درخواستوں کی طرف رخ بدلتا ہے۔
ماحول تیار کریں
کمانڈز ریپوزٹری کی جڑ سے چلائیں۔ خودکار مقامی ایگزیکیوشن کے لیے macOS Seatbelt اور Python 3.10 یا اس کے بعد کا ورژن درکار ہے۔ Kimi سبسکرپشن کی تشکیل کے لیے Python 3.11 یا اس کے بعد کا ورژن درکار ہے۔
فریم ورک صرف Python کی معیاری لائبریری استعمال کرتا ہے، اس لیے ریپوزٹری کو pip install مرحلے کی ضرورت نہیں۔ تاہم، آپ کو مطلوبہ تشکیل کے لیے آفیشل کلائنٹ انسٹال کرنا ہوگا اور اس کا سبسکرپشن لاگ اِن یا API کلید تیار کرنی ہوگی۔
دستیاب کلائنٹس میں Codex، Claude Code، Antigravity، DeepSeek Harness، Qwen Code، اور Kimi Code شامل ہیں۔ تصدیق کا طریقہ کلائنٹ کے لحاظ سے مختلف ہے: کچھ تشکیلیں سبسکرپشنز یا OAuth استعمال کرتی ہیں، جبکہ DeepSeek اور Qwen، پروجیکٹ کی دستاویزات میں بیان کردہ API پر مبنی تصدیق استعمال کرتے ہیں۔
ایجنٹ کی تشکیل منتخب کریں
ایجنٹ IDs ریپوزٹری کی موجودہ رجسٹری config/agents-cli.example.json سے حاصل ہوتی ہیں۔ یہ IDs بینچ مارک تشکیل کے شناخت کنندے ہیں، براہِ راست ماڈل آرگیومنٹس نہیں۔
gpt-6-astra، GPT Astra 6 کے ساتھ Codex کے لیےgpt-6-1-sol، GPT Sol 6.1 کے ساتھ Codex کے لیےclaude-opus-5-5، Claude Opus کے ساتھ Claude Code کے لیےclaude-sonnet-5-5، Claude Sonnet کے ساتھ Claude Code کے لیےantigravity-gemini-3-8-flash-high، Gemini Flash کے ساتھ Antigravity کے لیےdeepseek-v4-1-flash، DeepSeek Flash کے ساتھ DeepSeek Harness کے لیےqwen3-8-max-0902، Qwen Max کے ساتھ Qwen Code کے لیےkimi-k3، Kimi K3 کے ساتھ Kimi Code کے لیے
فوری آغاز کا ورک فلو چلائیں
بینچ مارک ہر تشکیل کے لیے ایک ہی ورک فلو استعمال کرتا ہے۔ پہلے ایک ایجنٹ ID کو AGENT شیل متغیر میں تفویض کریں:
AGENT=gpt-6-1-solاس کے بعد مقامی تشکیل محفوظ کریں:
python3 -m benchmark setup --agent "$AGENT"
جانچیں کہ منتخب کلائنٹ اور تصدیق تیار ہیں:
python3 -m benchmark cli-check --agent "$AGENT"جب چیک ready_for_trial واپس کرے، تو موجودہ کام کے انتخاب کے ساتھ ایک بیچ چلائیں:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT"
پہلے سے، بیچ ایگزیکیوشن 70 کاموں اور 83 مراحل کا پیش نظارہ کرتی ہے، ماڈل کالز کیے بغیر۔ جب آپ اپنے اکاؤنٹ کی الاٹمنٹ استعمال کرنے کے لیے تیار ہوں تو --execute شامل کریں:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
  --execute
cli-check کامیاب ہونے کے بعد ایک آزمائشی کام سے آغاز کریں۔ اس سے مکمل بیچ شروع کرنے سے پہلے یہ تصدیق کرنے میں مدد ملتی ہے کہ کلائنٹ، تصدیقی طریقہ، سینڈ باکس، اور آؤٹ پٹ کی جگہ درست طور پر کام کر رہے ہیں۔
متعدد تشکیلیں چلائیں
ہر کلائنٹ کو الگ الگ ترتیب دیں اور چیک کریں، پھر بیچ کمانڈ کو متعدد --agent آپشنز دیں۔ ایک نئی آؤٹ پٹ ڈائریکٹری استعمال کریں تاکہ مختلف کنفیگریشنز کے نتائج ایک دوسرے پر تحریر نہ ہوں۔
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
ہر کنفیگریشن کا تصدیقی طریقہ رجسٹری میں درج کلائنٹ کے ساتھ یکساں رکھیں۔ سبسکرپشن پر مبنی کنفیگریشن میں اس کے معاون سبسکرپشن لاگ اِن کا استعمال ہونا چاہیے، جبکہ API کنفیگریشن میں مطلوبہ API اسناد استعمال کی جانی چاہییں۔
ٹاسکس اور نتائج کا معائنہ
ٹاسک انڈیکس config/selections/current.json میں دستیاب ہے۔ سوالات، معیار اور اسکورنگ کی تعریفوں کے لیے سوالات اور اسکورنگ، ڈیٹا فارمیٹ گائیڈ اور اسکورنگ کے قواعد سے رجوع کریں۔
شائع شدہ نتائج کئی صورتوں میں دستیاب ہیں:
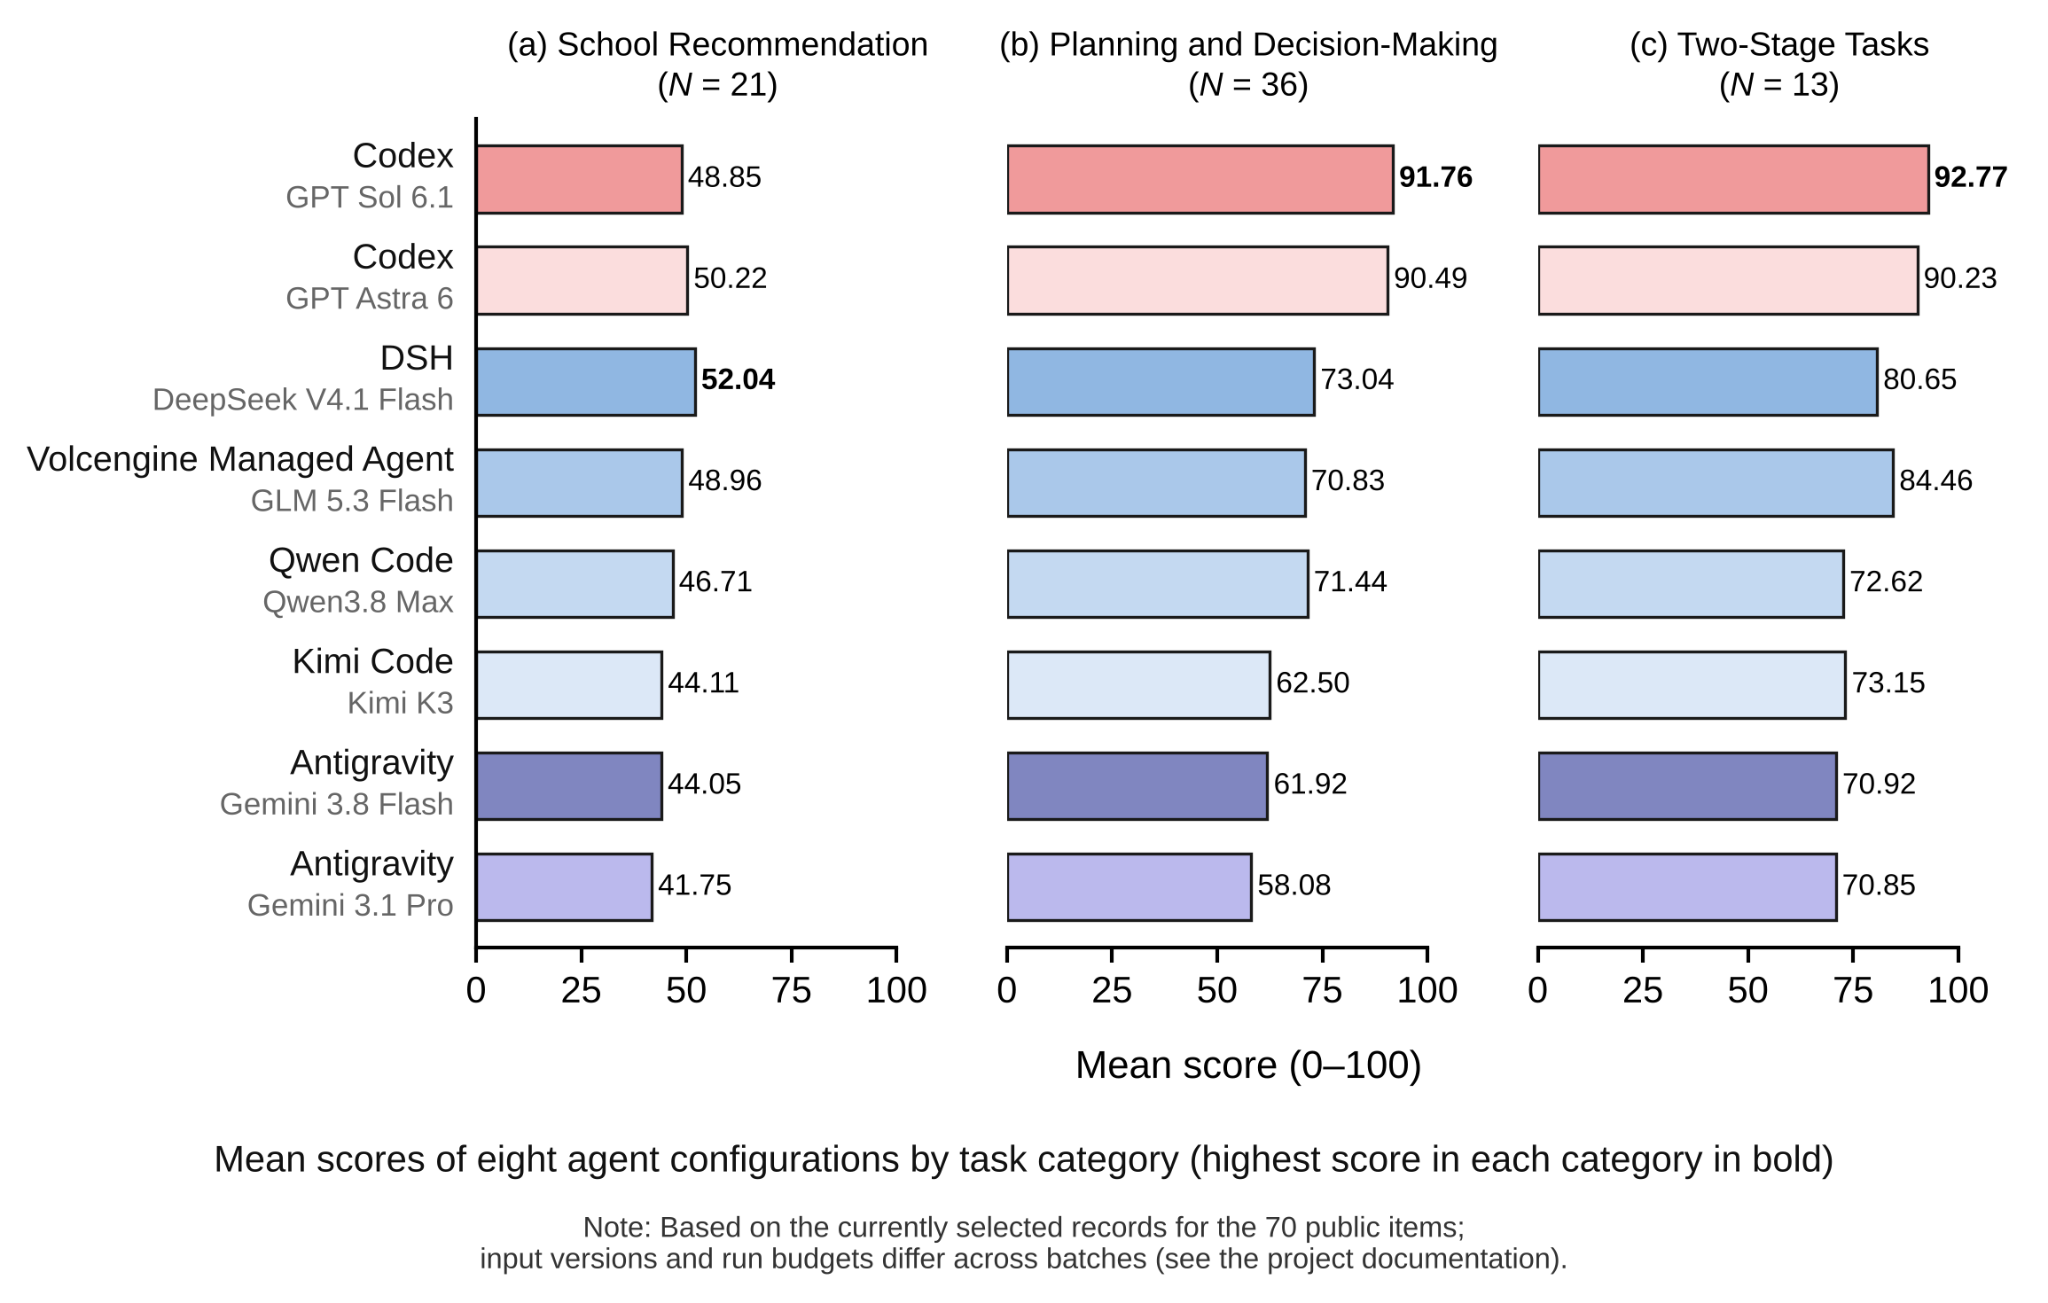
- مجموعی نتائج کے لیے اسکور کا خلاصہ۔
- تفصیلی ٹاسک سطح کے ریکارڈز کے لیے ہر ٹاسک کے نتائج۔
- عوامی جوابی متن اور جائزے کی معلومات کے لیے کنفیگریشن کے لحاظ سے جوابات اور اسکورز۔
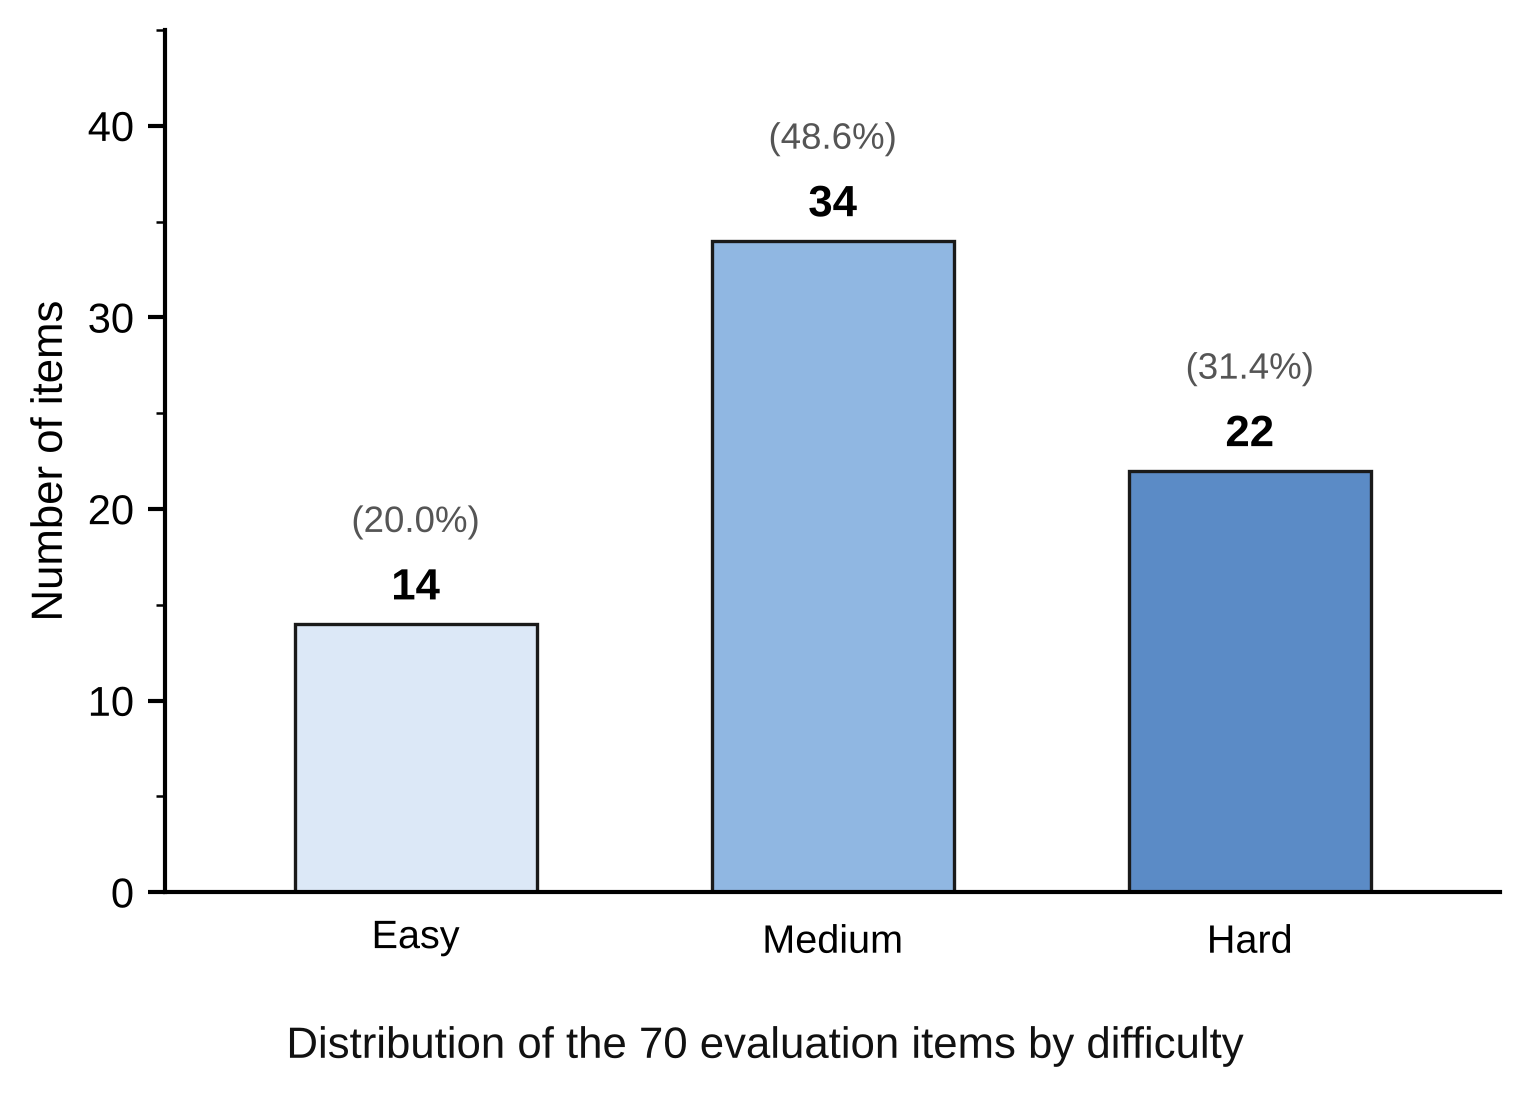
شائع شدہ لیڈر بورڈ آٹھ جانچی گئی کنفیگریشنز کے اوسط اسکورز اور تکمیل کی شرحیں رپورٹ کرتا ہے۔ ریپوزٹری موجودہ ٹاسکس کے لیے مشکل کی درجہ بندیاں بھی درج کرتی ہے: 14 آسان، 34 درمیانے اور 22 مشکل۔ ان درجہ بندیوں کی مالک کی جانب سے استادانہ کیلیبریشن کے ذریعے تصدیق کی گئی ہے، اور انہیں آزادانہ دوہری جانچ کے طور پر پیش نہیں کیا گیا۔
اسکورنگ اور جائزے کے نکات
برآمد شدہ مواد کا جائزہ لینے کے لیے اسکورنگ میں الگ Codex سبسکرپشن سیشن استعمال کیا جا سکتا ہے۔ اختیاری API جانچ کے لیے اضافی کنفیگریشن درکار ہے۔ جوابی عمل کو اسکورنگ کے مواد سے الگ رکھیں، کیونکہ جائزہ لیے جانے والے ایجنٹ کے سامنے روبرکس یا حوالہ پروگرام ظاہر کرنے سے تقابل غیر معتبر ہو سکتا ہے۔
اپنی رنز کا تقابل کرتے وقت ایجنٹ ID، کلائنٹ ورژن، ان پٹ ورژن، عمل درآمد کا بجٹ، آؤٹ پٹ ڈائریکٹری اور متعلقہ مواد کے ہیشز درج کریں۔ پروجیکٹ خبردار کرتا ہے کہ عوامی لیڈر بورڈ کی تمام رنز میں عمل درآمد کی شرائط یکساں نہیں ہوتیں، اس لیے نتائج کا تقابل ان کے طریقۂ کار اور رن ریکارڈز کے ساتھ کریں۔
قابل تکرار تجربات کے لیے تکرار گائیڈ پر عمل کریں، جس میں منجمد ان پٹس، سبمیشنز اور اسکور کی تصدیق شامل ہے۔ طریقۂ کار کی دستاویزات جائزے کی ترتیبات اور حدود واضح کرتی ہیں، جبکہ نیٹو CLI گائیڈ تنصیب، تصدیق اور متعدد مراحل کے بارے میں مزید تفصیل فراہم کرتی ہے۔
نتیجہ
Graduate Admissions Agent Benchmark یہ جانچنے کا ایک منظم طریقہ فراہم کرتا ہے کہ آیا داخلہ ایجنٹس درست سفارشات، مفید منصوبہ بندی کا مشورہ اور طالب علم کے حالات بدلنے پر مناسب تازہ کاریاں فراہم کرتے ہیں۔ معاون کلائنٹ ترتیب دیں، رجسٹری سے ایجنٹ ID منتخب کریں، cli-check کے ذریعے اس کی تصدیق کریں، بیچ کا پیش منظر دیکھیں، پھر آزمائشی یا مکمل جائزے چلائیں۔ اسکورز کی ذمہ دارانہ تشریح اور تقابل کو دہرانے کے لیے شائع شدہ ٹاسک تعریفوں، نتائج اور طریقۂ کار کی دستاویزات استعمال کریں۔