

Alibaba Tongyi Qianwen jamoasi bugun kechqurun Qwen3.8-Flash modelini rasman e’lon qildi. Tongyi jamoasi ayni paytda Qwen3.8-Flash-Next modelining ochiq koddagi og‘irliklarini ham chiqardi. Next yangi arxitekturasi butunlay yangi avlod Qwen4 seriyasi modellarining boshlang‘ich shakli bo‘ladi.
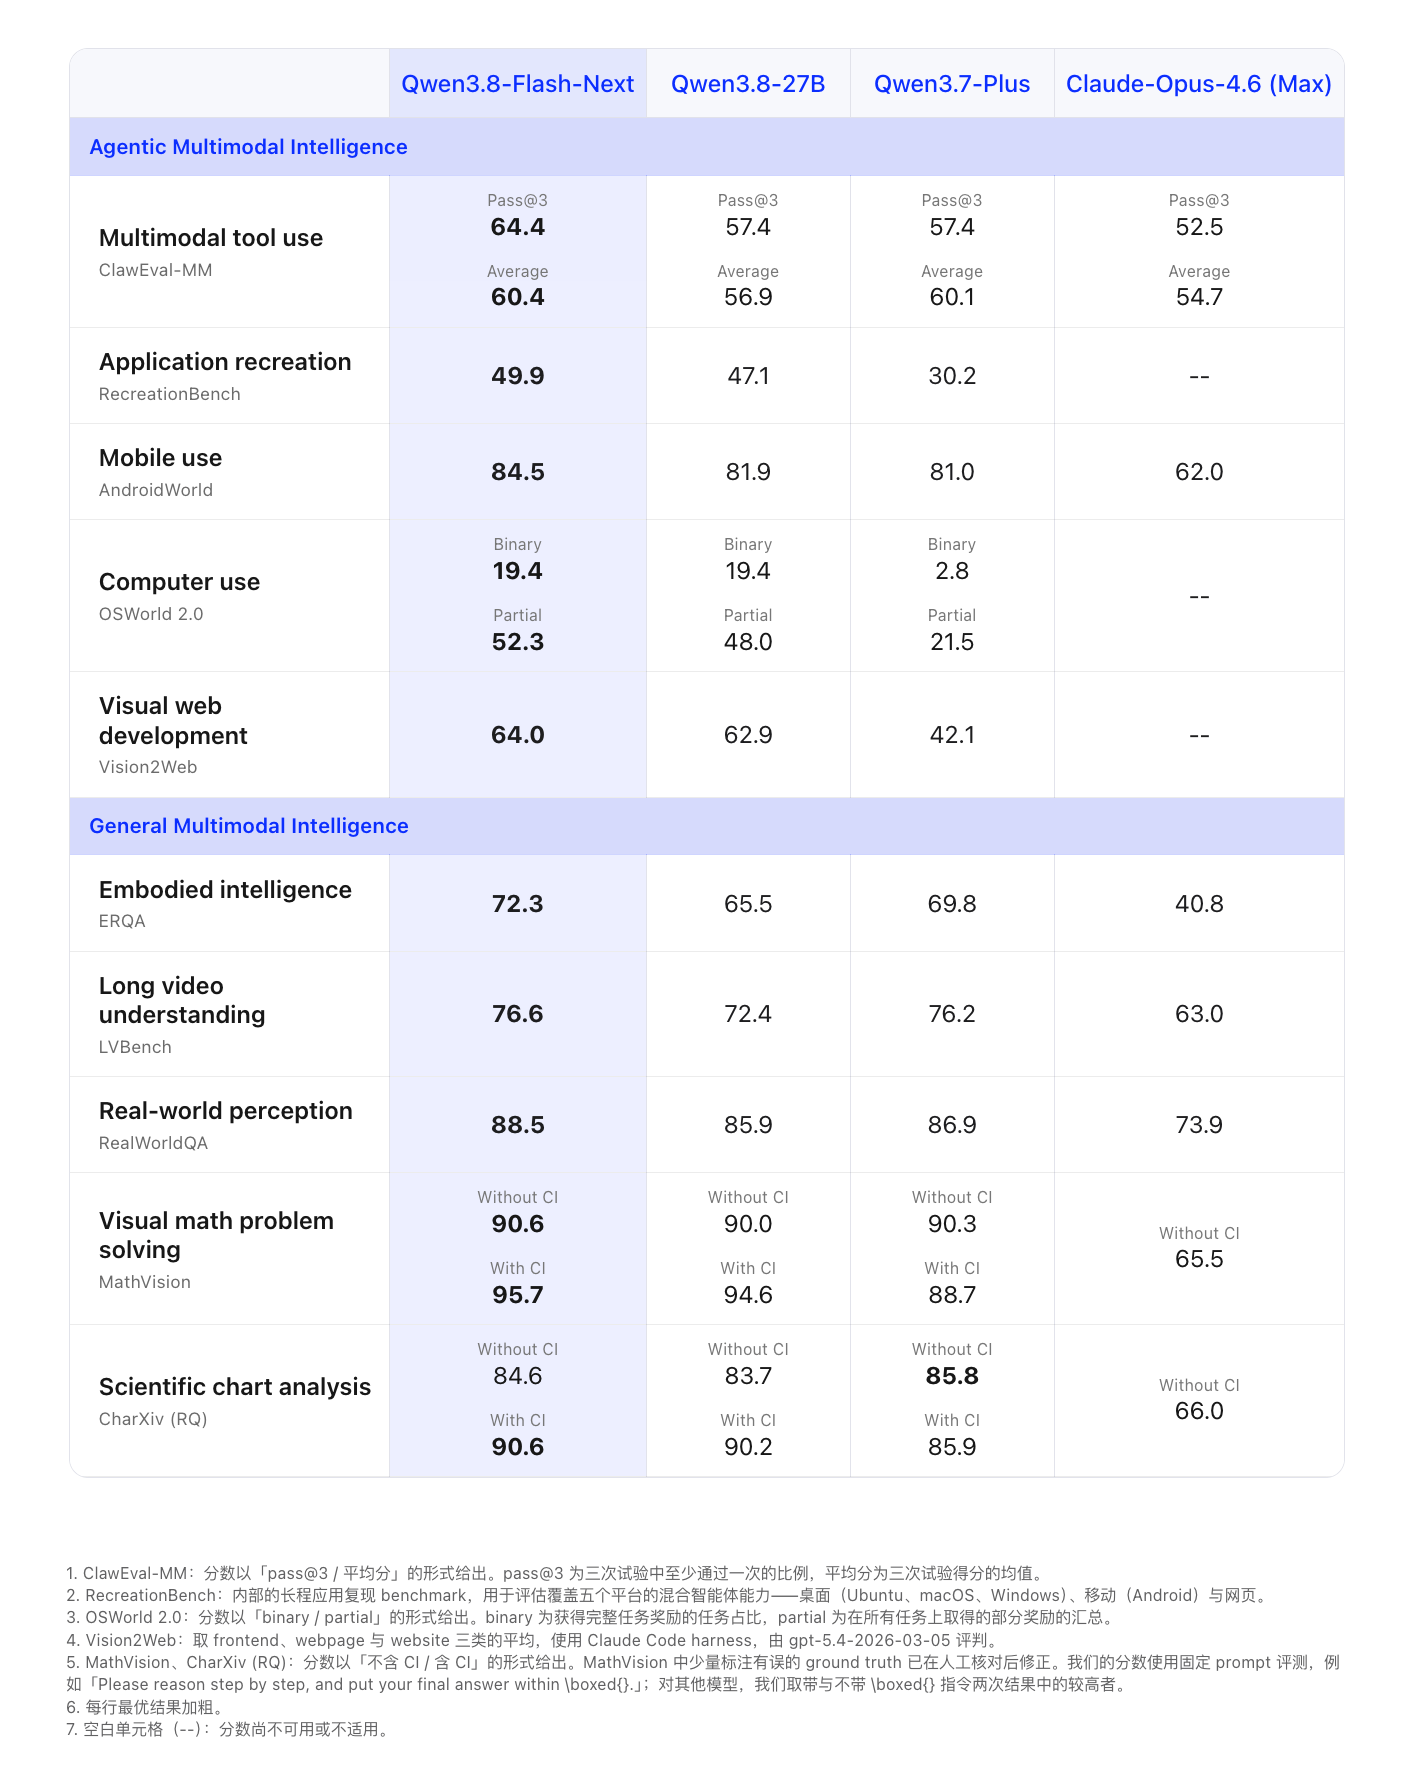
Bu multimodal MoE modeli bo‘lib, asosiy model 125B parametrga ega, qo‘shimcha ravishda 51B hajmdagi N-gram Embedding bilan jihozlangan va har bir token uchun 6B parametr faollashadi. U tabiiy ravishda 262,144 token kontekstni qo‘llab-quvvatlaydi hamda YaRN orqali 1M token gacha kengaytirilishi mumkin.
Ma’lumotlarga ko‘ra, Qwen3.8-Flash to‘rtta yo‘nalishda tizimli yangilandi:
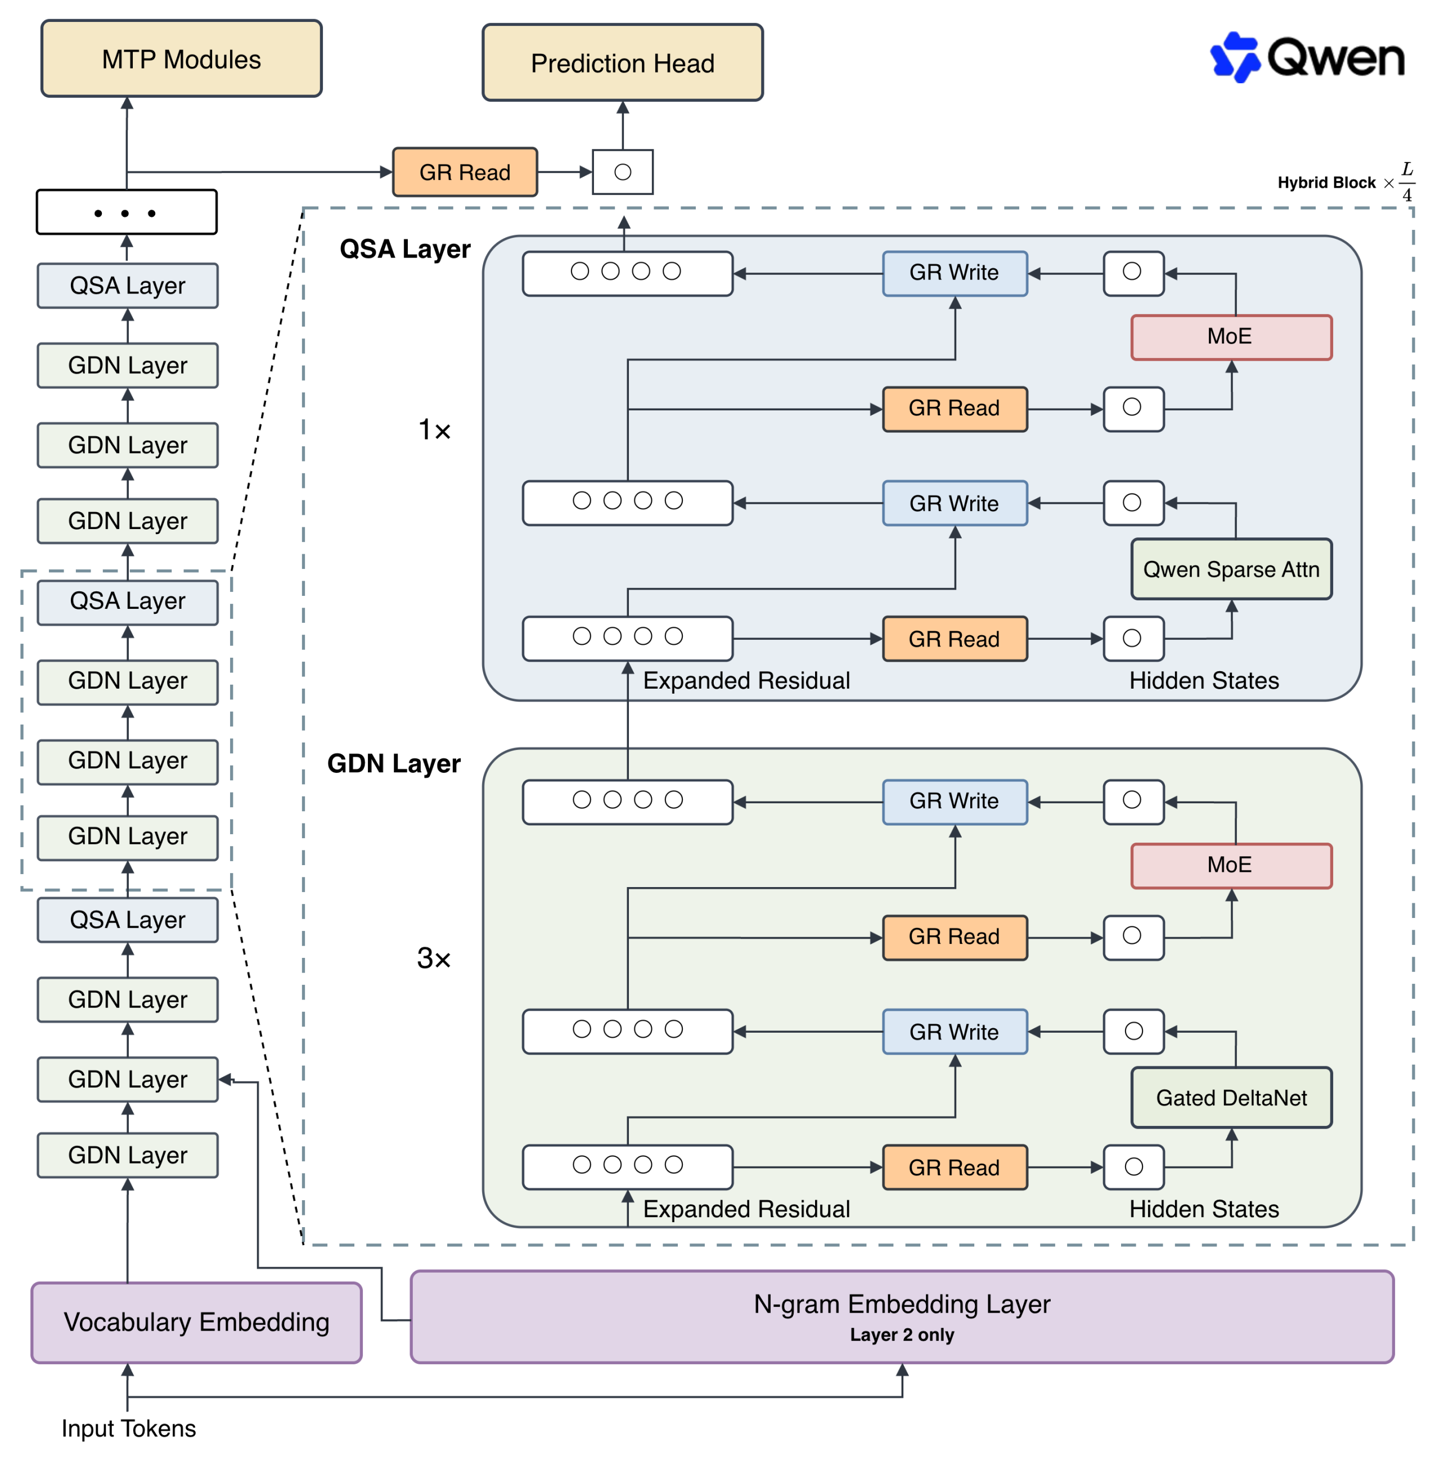
Attention yo‘nalishida GDN (Gated DeltaNet) + QSA (Qwen Sparse Attention) gibrid arxitekturasi qo‘llanadi. GDN tarixiy ma’lumotlarni samarali siqish uchun, QSA esa yengil Indexer yordamida micro-block darajasida muhim kontekstni saralash uchun xizmat qiladi. Bu uzun ketma-ketliklarda Attention xarajatlarini sezilarli kamaytiradi. 1M tokenli o‘ta uzun kontekstda QSA Attention Kernel’i Prefill va Decode bosqichlarida mos ravishda eng yuqori 7.6 va 4.9 baravar tezlashuvni ta’minlaydi.
Residual yo‘nalishida Gated Residual (GR) mexanizmi joriy etildi. U residual oqimini 4 ta parallel tarmoqqa kengaytiradi va ma’lumotlarni o‘qish-yozishni dinamik Gate orqali boshqaradi. Residual holat FP8 formatida saqlanishi mumkin, bu xotiraga murojaat xarajatlarini sezilarli kamaytiradi.
Embedding yo‘nalishida 51B parametrli N-gram Embedding joriy etilib, model sig‘imini kengaytirish uchun mahalliy kontekstdan foydalanib jadval orqali qidirish amalga oshiriladi. Bu parametrlar Host Memory’ga chiqarilishi va asinxron Prefetch orqali model hisob-kitoblari bilan parallel bajarilishi mumkin, shu tariqa GPU videoxotirasini uzoq vaqt egallamaydi.
Optimization yo‘nalishida Muon Optimizer qo‘llanadi hamda ortogonallashtirish aniqligi, parametrlar taqsimoti va birlashtirilgan matritsalarni ajratish kabi strategiyalar optimallashtirildi. Yangi arxitektura uchun Scaling Law qayta moslashtirildi.
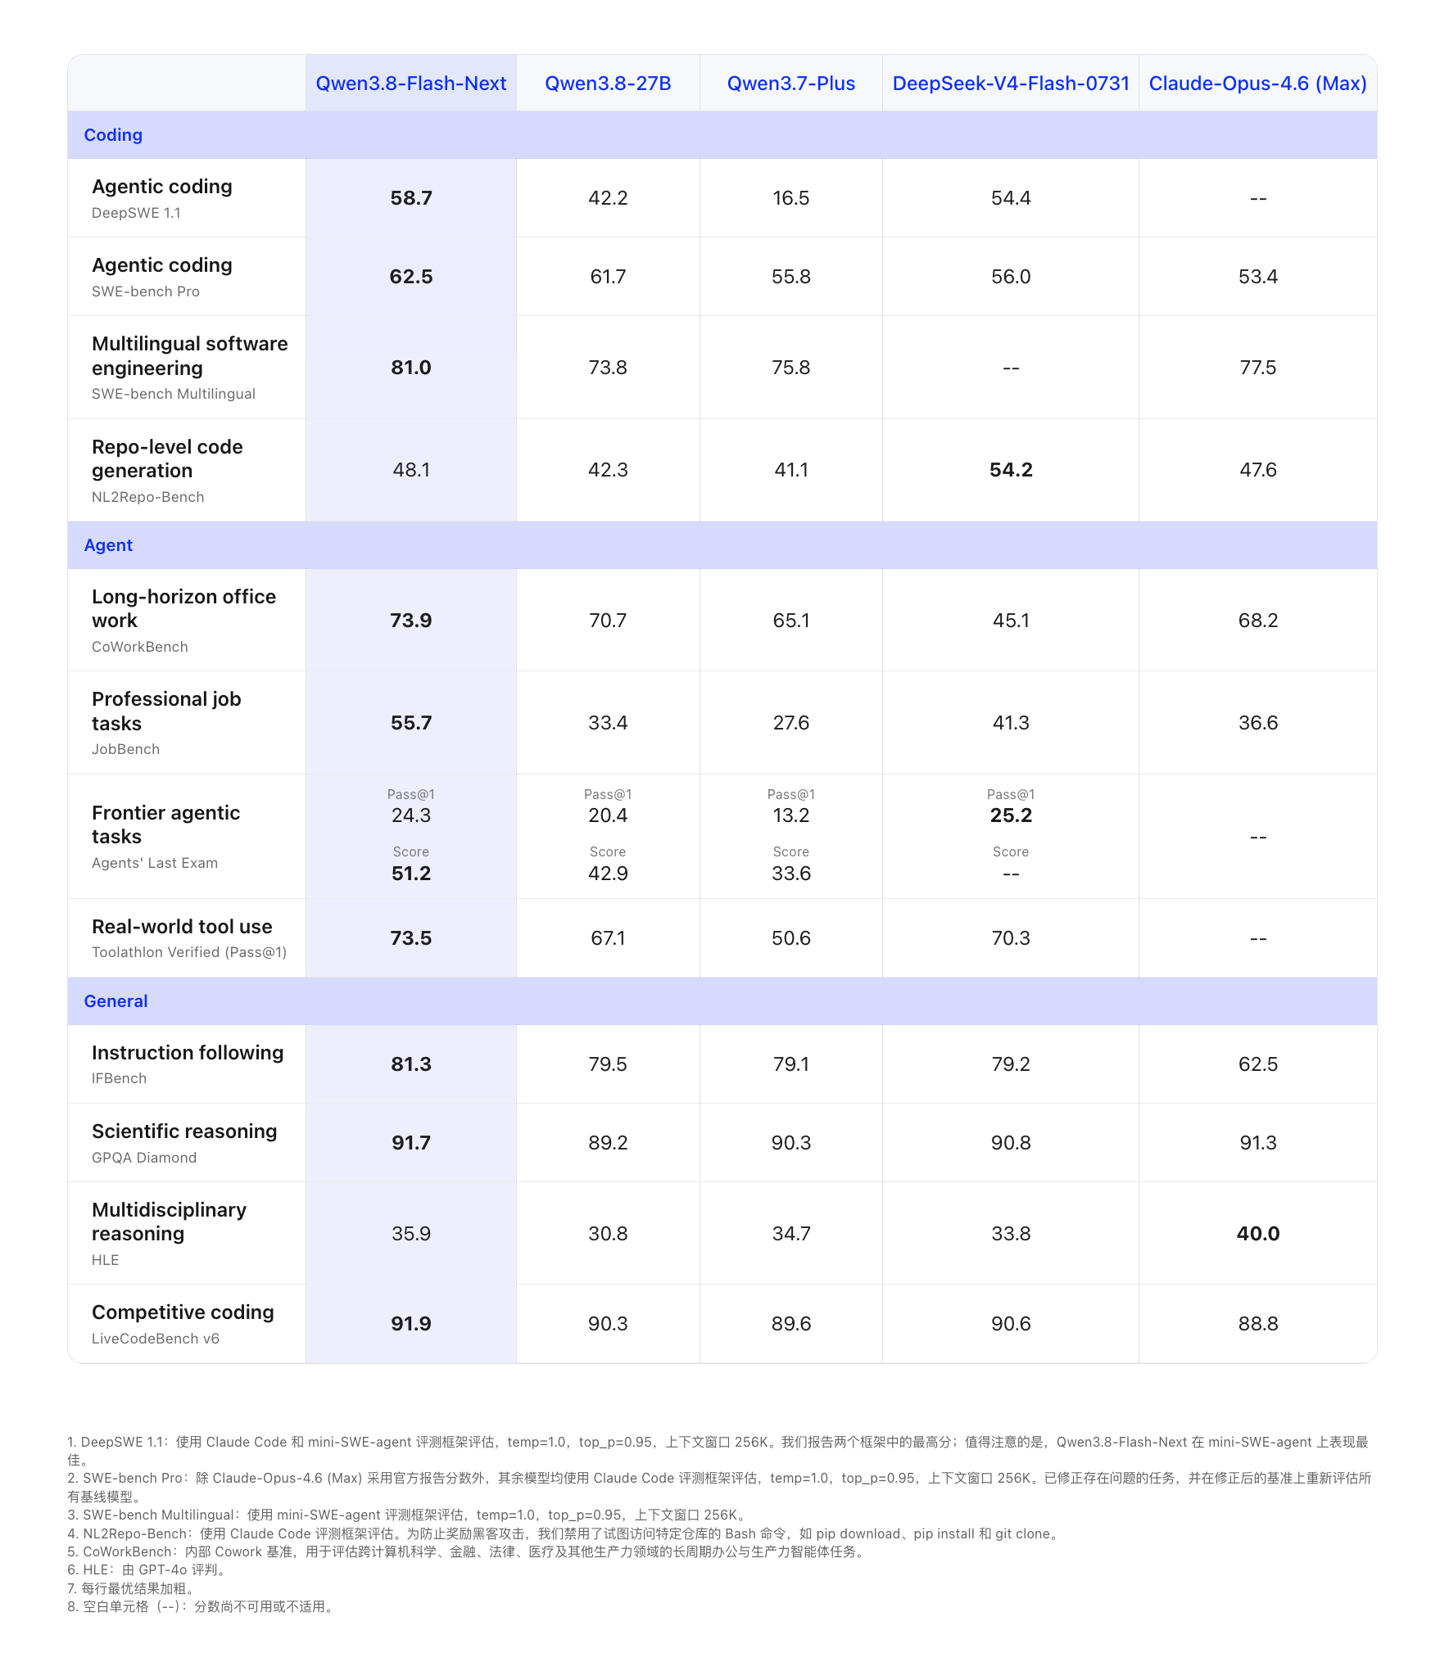
Qwen3.7-Plus bilan taqqoslaganda, Qwen3.8-Flash’ni o‘qitish xarajati avvalgi modelnikining atigi taxminan to‘qqizdan bir qismiga teng, biroq kodlash va ofis vazifalarida kuchliroq imkoniyatlarga ega.
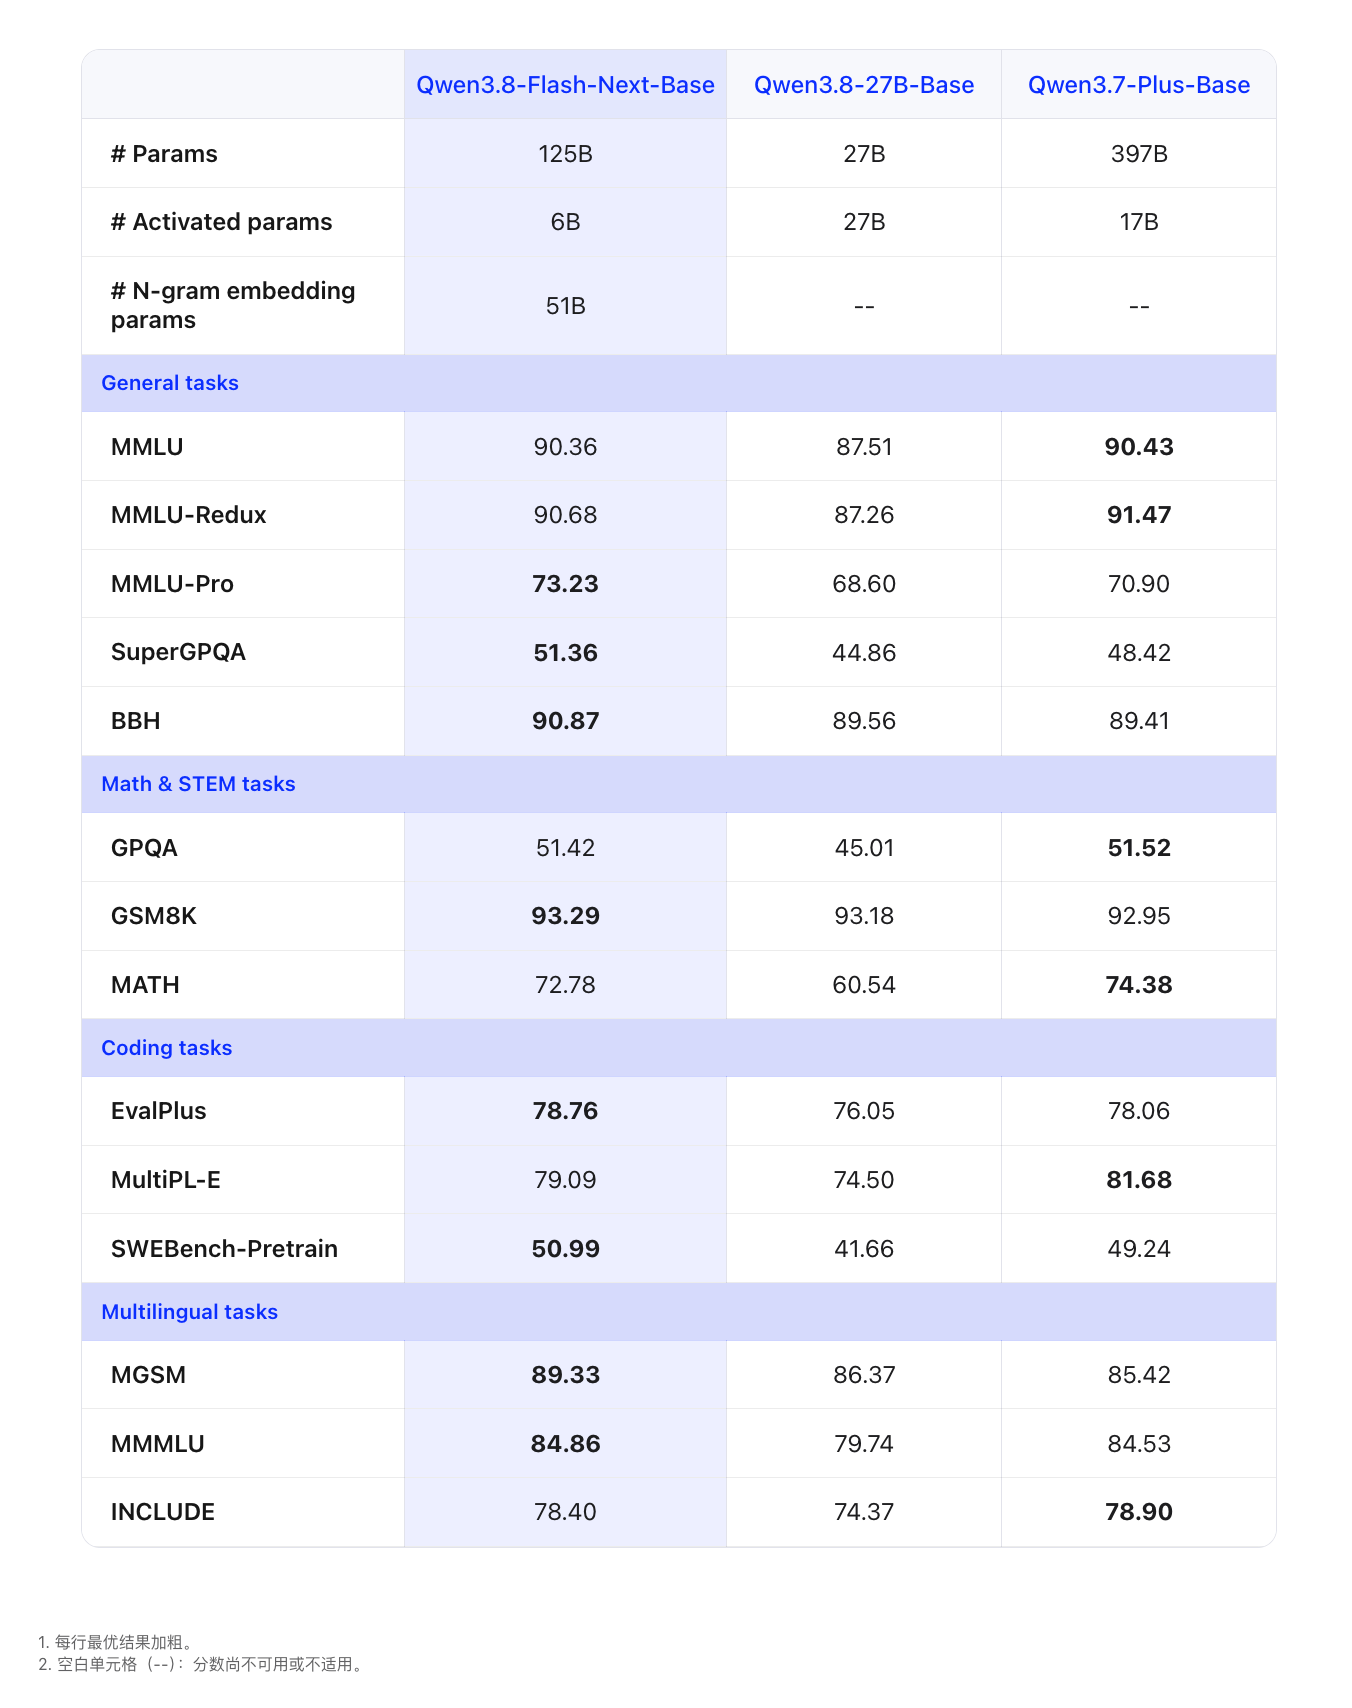
6B faollashuvchi parametr sharoitida Qwen3.8-Flash-Next-Base 14 ta benchmarkning 8 tasida eng yaxshi natijani qayd etdi. Ular qatoriga MMLU-Pro, SuperGPQA, BBH, SWEBench-Pretrain, MGSM va MMMU kiradi.
Sof matn:
Multimodal:
Model tuzilmasi:
Base modelining natijalari:
Qwen3.8-Flash tez orada Qianwen AI platformasida ishga tushadi va tashqi foydalanuvchilarga API xizmatini taqdim etadi. Narx har bir million Tokens uchun kirishda 1 yuan, chiqishda 3 yuan etib belgilangan.
Model og‘irliklari Pekin vaqti bilan 26-avgust kuni 23:00 da Hugging Face va ModelScope platformalarida ochiq kodda e’lon qilindi, shu bilan birga FP8 kvantlash versiyasi ham chiqarildi. Qwen3.8-Flash-Next sukut bo‘yicha 1M kontekstni qo‘llab-quvvatlaydi va rasmiy vositalar ichiga o‘rnatilgan.
Manbalar:
Texnik hisobot: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
Texnik blog: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next