

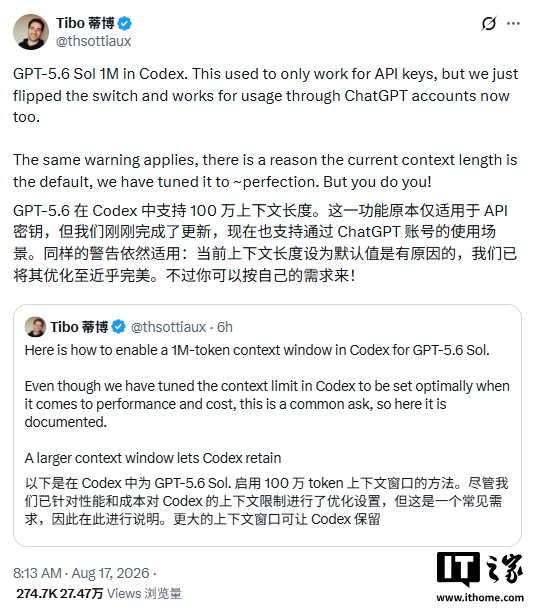
Bugun OpenAI’ning Codex va ChatGPT uchun mas’ul muhandisi Tibo (@thsottiaux) X platformasida Codex’dagi GPT-5.6 Sol modeli uchun 1 million tokenlik kontekst oynasi funksiyasi avval faqat API kalitlariga tegishli bo‘lganini, endi esa ChatGPT akkauntlari orqali foydalanishni ham qo‘llab-quvvatlashini e’lon qildi.
Tibo postida aniq shunday dedi: “GPT-5.6 Sol Codex’da 1 million tokenlik kontekst uzunligini qo‘llab-quvvatlaydi. Avval bu faqat API kalitlari uchun mavjud edi, biz hozirgina funksiyani yoqdik va endi ChatGPT akkauntlari orqali foydalanish ham ishlayapti.”
Bu o‘zgarish ChatGPT Plus, Pro va boshqa obuna rejalariga ega foydalanuvchilar Codex’dan, ya’ni OpenAI’ning AI dasturlash agenti vositasidan foydalanganda, qo‘lda sozlash orqali qariyb 1,05 million tokenlik to‘liq kontekst oynasini yoqishi mumkinligini anglatadi. GPT-5.6 Sol modelining rasmiy hujjatlarida u taxminan 1 050 000 tokenlik kontekst uzunligini qo‘llab-quvvatlashi ko‘rsatilgan.
Kattaroq kontekst oynasi Codex’ga tarixiy ma’lumotlarni avtomatik siqishdan oldin ko‘proq kod, vositalar chiqishi va suhbat yozuvlarini saqlab qolish imkonini beradi. Bu, ayniqsa, katta kod bazalarini qayta tuzish, murakkab nosozliklarni tuzatish va uzoq davom etadigan sessiyalar kabi professional vazifalar uchun mos.
Tibo, shuningdek, Codex’dagi joriy standart kontekst uzunligi unumdorlik va xarajatlar o‘rtasidagi muvozanat asosida optimallashtirilganini, u tasodifiy belgilanmaganini ta’kidladi. U foydalanuvchilarni shunday ogohlantirdi: “Joriy standart uzunlikning o‘z sababi bor, biz uni deyarli mukammal darajaga sozladik. Ammo qarorni o‘zingiz qabul qilishingiz mumkin.”
Ko‘plab foydalanuvchilar bu o‘zgarish avval obunachilar katta loyihalar bilan ishlaganda duch kelgan kontekst yetishmasligi muammosini, ayniqsa ishlab chiqarish darajasidagi kod omborlarini saqlash va qayta tuzish ehtiyojlarini hal qilganini bildirdi. Ayrim dasturchilar esa Codex’ning server tomonidagi siqish mexanizmi bilan birga, standart sozlama kundalik vazifalarning aksariyati uchun allaqachon yetarlicha samarali ekanini eslatdi.
Ayrim foydalanuvchilar 1 million tokenlik kontekstni yoqqandan so‘ng obuna limiti ancha tez sarflanishini aytdi. Ba’zi foydalanuvchilarning fikricha, bir martalik yuqori intensivlikdagi foydalanishning o‘zi haftalik limitning katta qismini sarflashi mumkin. Shu sababli funksiyani kundalik standart sozlama sifatida emas, faqat zarur bo‘lganda yoqish tavsiya etiladi.