

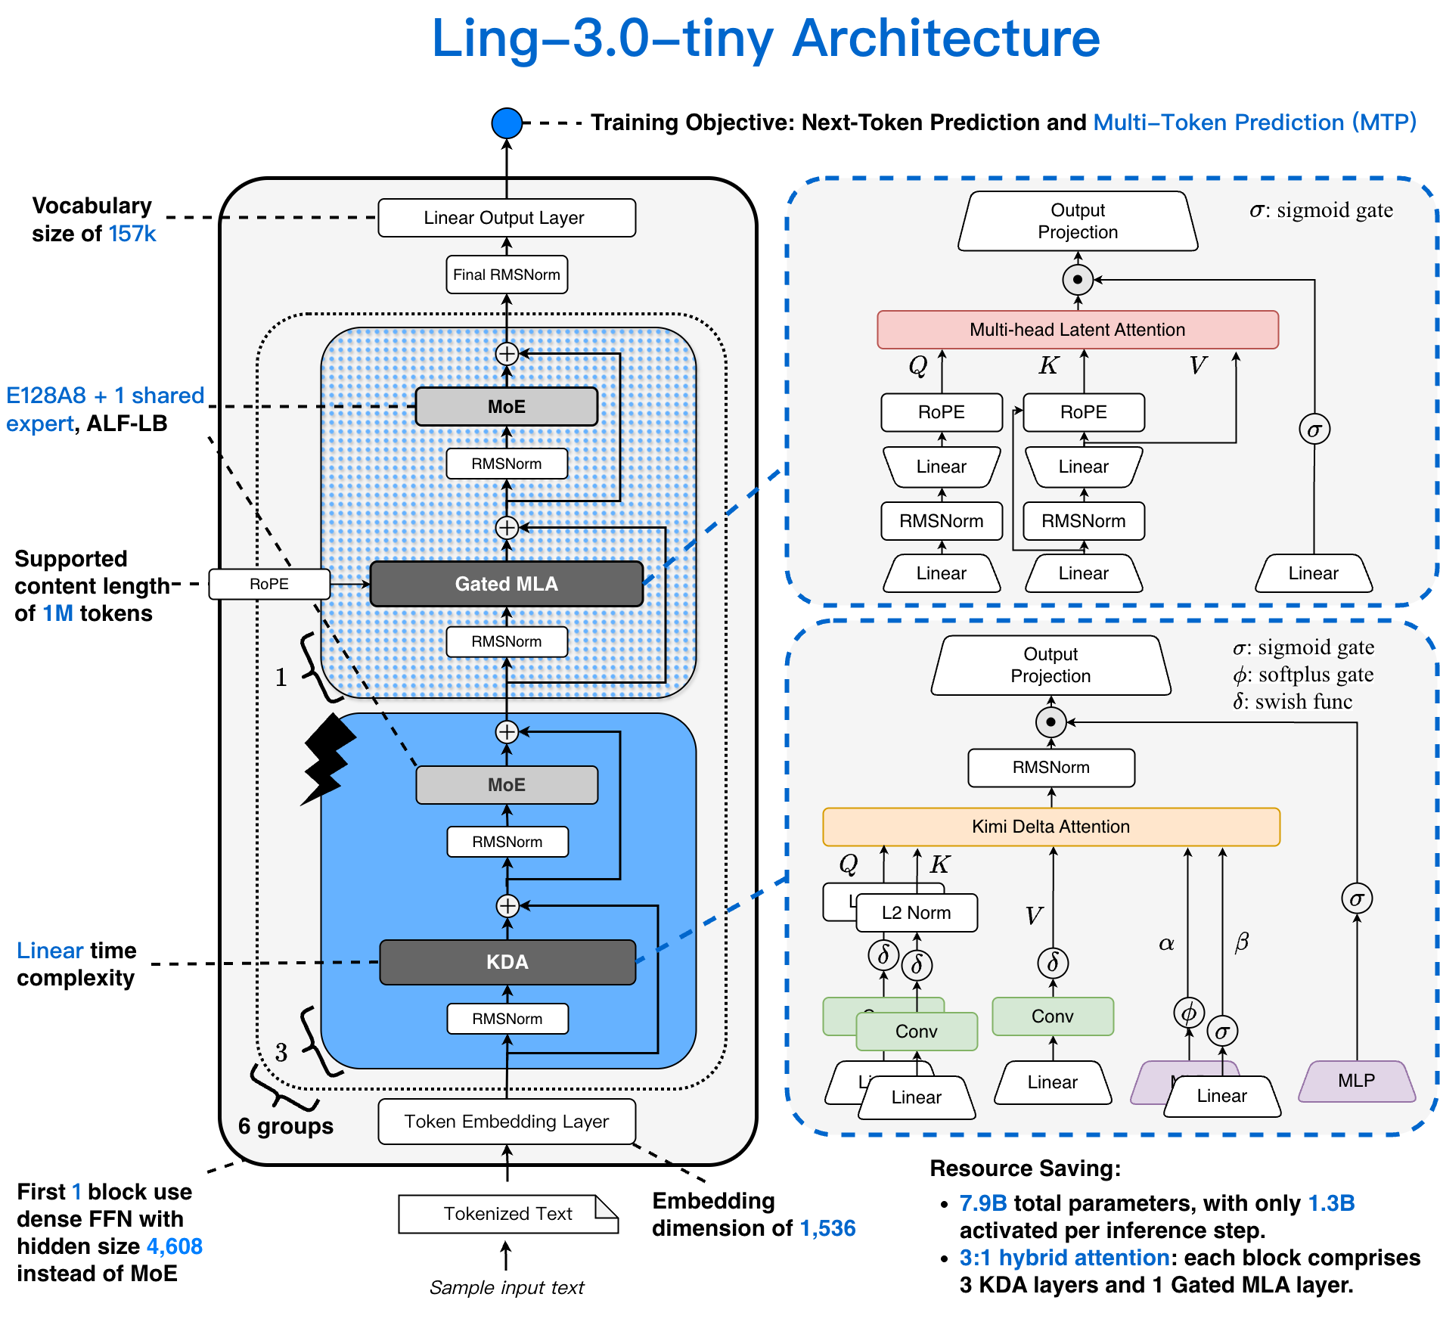
Ant Ling bugun Hugging Face platformasida Ling-3.0-tiny modelini ochiq kodli qildi. Model yengil gibrid xulosa chiqarish MoE arxitekturasiga ega bo‘lib, jami parametrlar soni 7.9B, har bir token uchun esa 1.3B parametr faollashadi. Rasmiy jamoa turli platformalardagi joylashtirish ehtiyojlariga mos BF16, FP8 va INT4 og‘irlik versiyalarini taqdim etdi.
Ma’lumotlarga ko‘ra, Ling-3.0-tiny arzon xulosa chiqarishga yo‘naltirilgan. Unda samarali gibrid chiziqli arxitektura qo‘llanib, KDA (Kimi Delta Attention) va MLA (Multi-Head Latent Attention, ko‘p boshli latent diqqat) 3:1 nisbatda navbatma-navbat joylashtirilgan. Model 128 ta yo‘naltiriladigan ekspertni (routed experts) o‘z ichiga olgan siyrak MoE oldinga uzatish tarmog‘idan (FFN) foydalanadi va kontekstni qayta ishlash qobiliyati bilan hisoblash xarajatlari o‘rtasida muvozanatni ta’minlaydi.
Model tezkor javob rejimi va ko‘p bosqichli xulosa chiqarish rejimini qo‘llab-quvvatlaydi hamda mahalliy joylashtirish uchun maxsus ishlab chiqilgan. Rasmiy jamoa uni NVIDIA DGX Spark, Apple Silicon MacBook va Mac mini kabi kompyuterlarda sinovdan o‘tkazgan. M4 Pro chipli MacBook’da xulosa chiqarish tezligi taxminan 86-90 Token/s ga yetadi, 8K kontekst uzunligida esa maksimal xotira sarfi taxminan 8.34 GiB ni tashkil etadi.
Manba:
inclusionAI/Ling-3.0-tiny · Hugging Face