

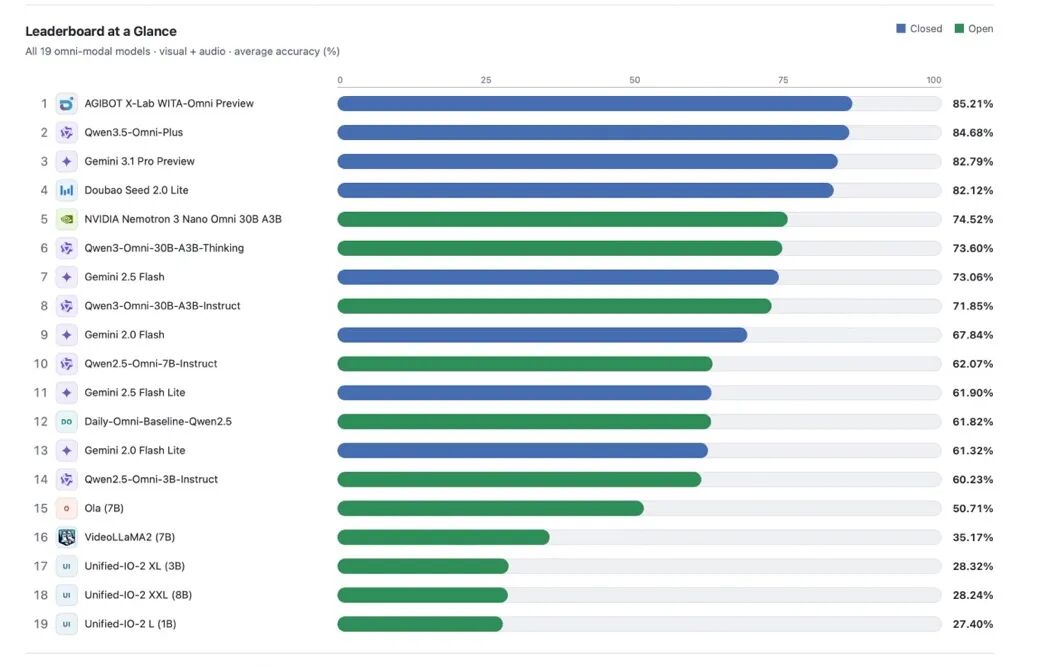
Zhiyuan AGIBOT WeChat rasmiy akkaunti xabariga ko‘ra, yaqinda embodied multimodal tushunish bo‘yicha nufuzli DailyOmni reytingining eng so‘nggi baholash natijalari e’lon qilindi. Zhiyuan tomonidan mustaqil ishlab chiqilgan embodied-native multimodal katta model WITA-Omni Preview audio-video birgalikdagi tushunish va vaqtli xulosa chiqarishdagi yetakchi qobiliyatlari tufayli 85.21 ballik umumiy natija bilan birinchi o‘rinni egalladi. U Qianwen, Gemini, Doubao, NVIDIA kabi Xitoy va xorijdagi yetakchi modellardan o‘zib ketdi hamda sakkizta kichik ko‘rsatkichning oltitasida birinchi bo‘ldi.
IT之家 ma’lumotlariga ko‘ra, DailyOmni audio-video vaqtli muvofiqligi va multimodallararo birgalikdagi xulosa chiqarish qobiliyatini sinovdan o‘tkazuvchi, sohada umumiy e’tirof etilgan nufuzli uchinchi tomon reytingidir. Matn-rasm va qisqa videolarga yo‘naltirilgan odatiy baholash vazifalaridan farqli ravishda, ushbu reytingda haqiqiy ochiq muhitdan olingan audio-video materiallardan keng foydalaniladi. Unda modelning vizual tasvirlar va atrof-muhit audio ma’lumotlarini birlashtirishi, tovush va tasvir o‘rtasidagi moslikni, voqealarning ketma-ketligini hamda multimodallararo semantikani aniq aniqlashi kabi kompleks qobiliyatlari sinovdan o‘tkaziladi. Bu qobiliyatlar gumanoid robotlarning haqiqiy fizik makonda inson-mashina o‘zaro ta’sirini amalga oshirishi uchun zarur bo‘lgan asosiy idrok qobiliyatlariga juda mos keladi.
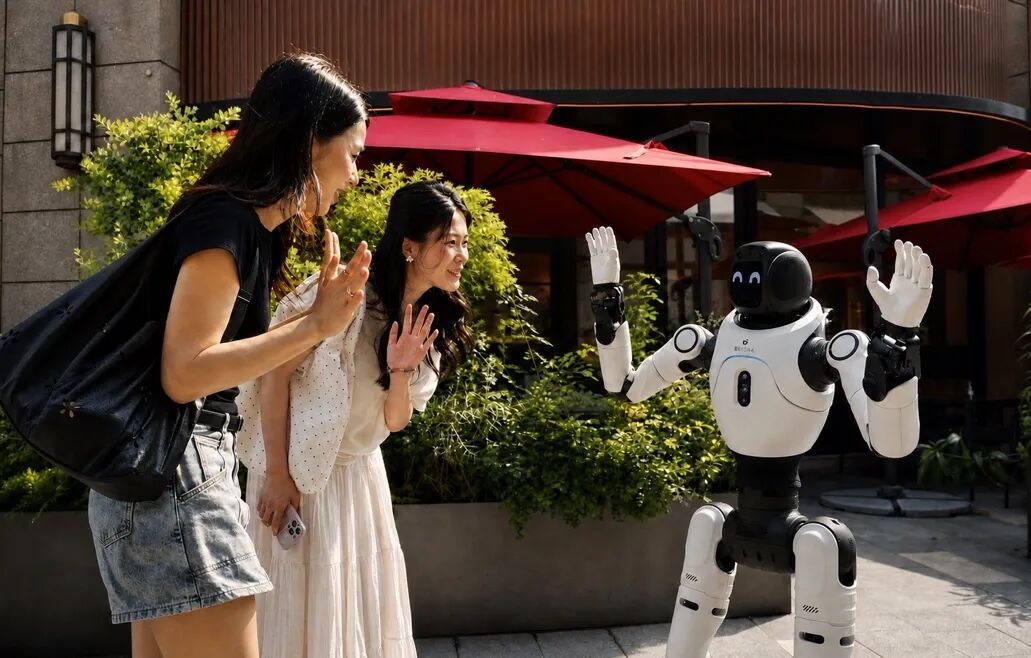
Rasmiy ma’lumotga ko‘ra, WITA-Omni’ning yetakchiligidagi asosiy omil shundaki, u chat modelini shunchaki robotga “o‘rnatmaydi”. Aksincha, jismoniy harakatlar va mimikani ovoz bilan teng darajadagi asosiy chiqishlarga aylantiradi hamda idrok, qaror qabul qilish va ifodalashni yagona original end-to-end model orqali boshqaradi. Shu tariqa Thinker–Talker paradigmasi embodied chiqishlarga yo‘naltirilgan Thinker–Talker–Actor arxitekturasigacha kengaytirilgan.
WITA-Omni’ning yetakchiligi faqat model hajmiga bog‘liq emas, balki embodied multimodal o‘zaro ta’sir atrofida qurilgan qatlamli ma’lumotlar tizimi va maqsadli o‘qitish usullaridan kelib chiqadi. O‘qitishning o‘rta bosqichida WITA-Omni jami o‘n millionlab soatlik ochiq manbali va o‘ziga tegishli multimodal ma’lumotlardan foydalanib, kuchli matn va vizual bazani “eshita oladigan, ko‘ra oladigan va audio-tasvirni birgalikda tahlil qila oladigan” multimodal modelga aylantiradi.
Bundan tashqari, ochiq audio-video ma’lumotlarda odatda haqiqiy o‘zaro ta’sirdagi navbat almashinuvi, javob berish vaqti, harakatlar va mimika haqidagi ma’lumotlar yetishmaydi. Shu sababli end-to-end embodied o‘zaro ta’sir modelini bevosita o‘qitish qiyin. Buning uchun Zhiyuan insonga markazlangan va haqiqiy o‘zaro ta’sir stsenariylariga yo‘naltirilgan, yuqori sifatli keng ko‘lamli multimodal ma’lumotlar to‘plamini yaratdi. Unda tovush, tasvir, til, harakat va mimika o‘rtasidagi tabiiy vaqtli munosabatlar to‘liq saqlab qolingan.