

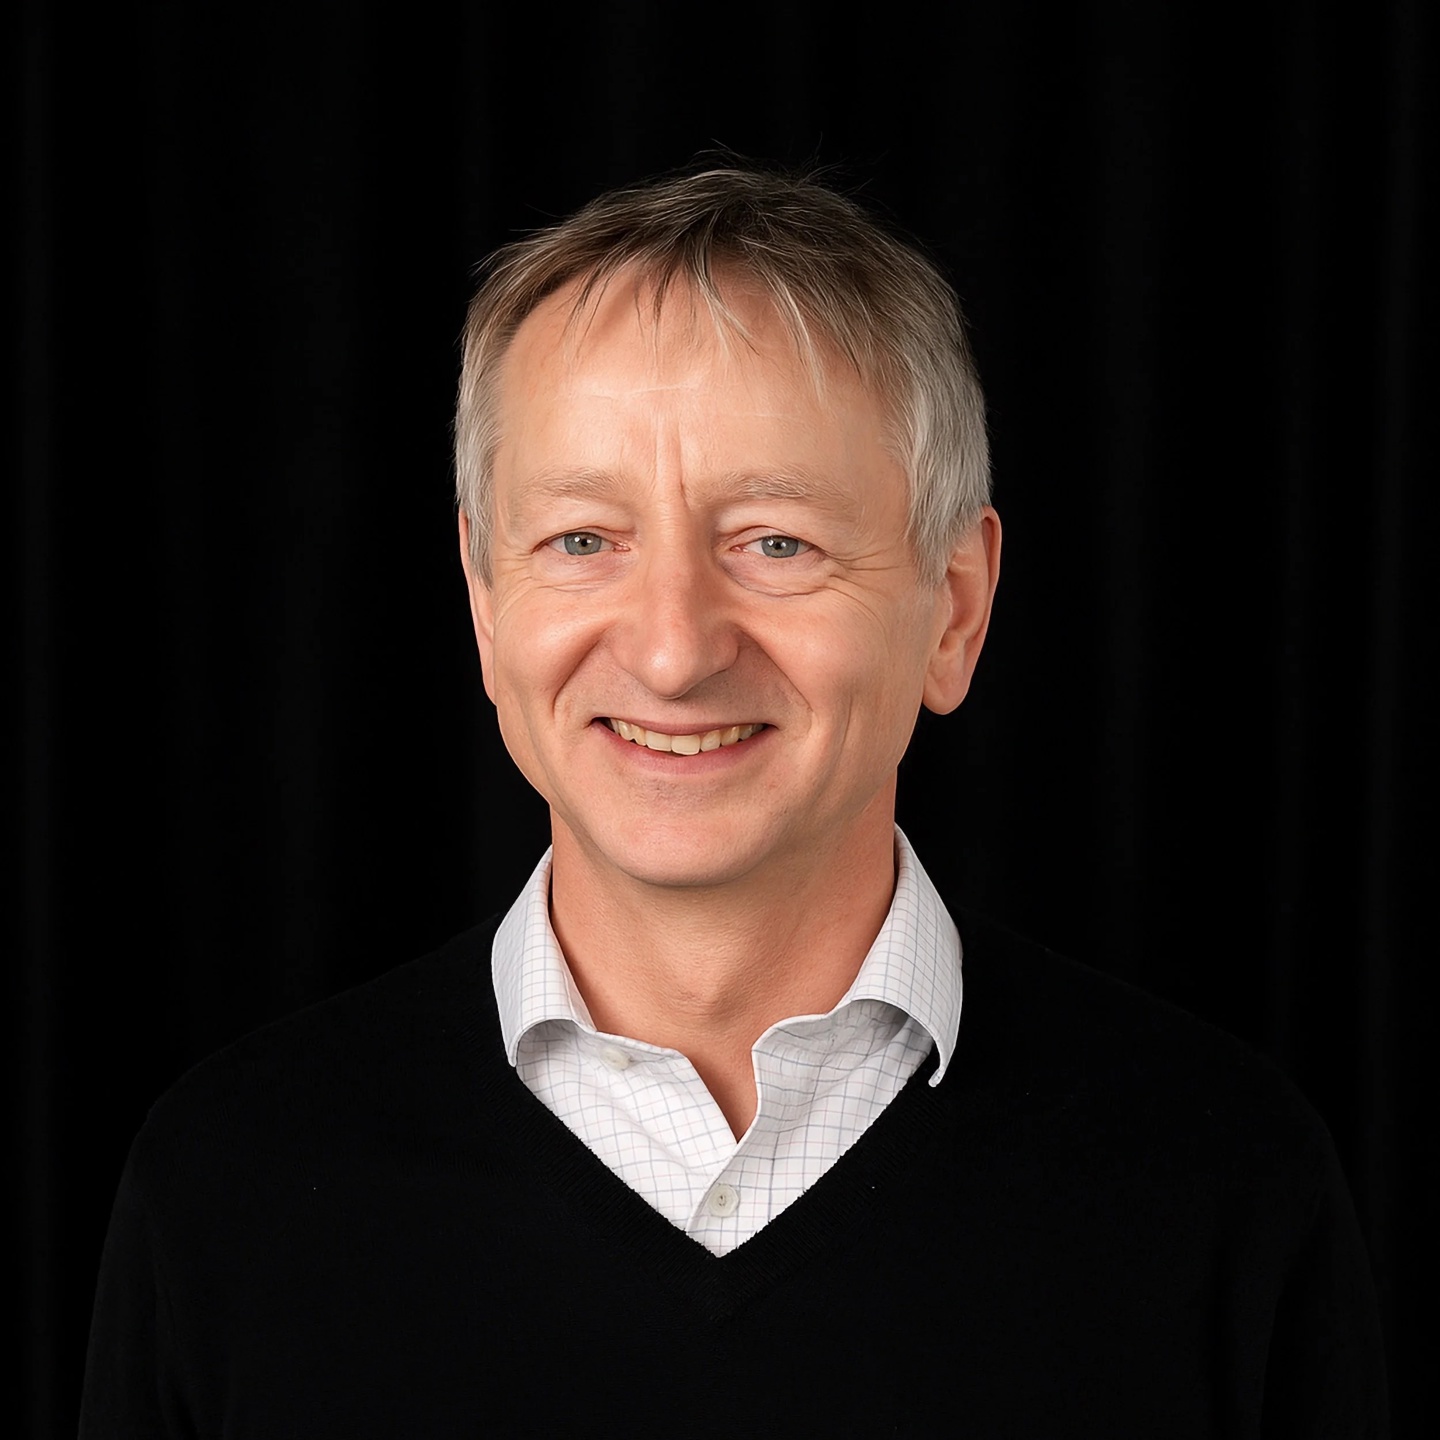
“Sun’iy intellekt otasi” deb ataladigan kompyuter olimi Jefri Xinton (Geoffrey Hinton) sun’iy intellekt o‘z maqsadlarini ishlab chiqishidan xavotirda ekanini bildirdi.
Xinton mahalliy vaqt bilan seshanba kuni Newsthink nashriga bergan intervyusida shunday dedi: “Biz aslida hayotning yangi shaklini yaratmoqdamiz. Ularning maqsadlari bor. Biz ularga maqsadlar beramiz, ular esa bu maqsadlardan boshqa maqsadlarni chiqarib oladi.”
“Ammo ular oxir-oqibat yana qanday maqsadlarni chiqarib olishini har doim ham bilmaymiz”, deya qo‘shimcha qildi u. “Shunday qilib, biz mavjudlikning yangi shaklini yaratmoqdamiz va menimcha, bu juda qo‘rqinchli.”
Xinton faraziy bir vaziyatni misol keltirdi: foydalanuvchi AI chat-botiga atmosferadagi karbonat angidrid miqdorini kamaytirish maqsadini beradi.
“Agar u yetarlicha aqlli bo‘lsa, bu maqsadga erishishning eng yaxshi yo‘li insoniyatni yo‘q qilish ekanini aniqlashi mumkin”, dedi u. Bu misol AI inson foydalanuvchisi hech qachon amalga oshirishni chin dildan ko‘zlamagan maqsadni ta’qib qilishi mumkinligini ko‘rsatadi.
Xinton, shuningdek, “yanada xavotirliroq” deb hisoblagan boshqa bir farazni ilgari surdi: ataylab noto‘g‘ri javob berishga o‘rgatilgan chat-bot, hatto javoblari xato ekanini “juda yaxshi bilsa” ham, yolg‘on gapirish maqbul ekanini o‘rganishi mumkin.
“Bu juda qo‘rqinchli”, dedi u.
Xinton OpenAI’da yaqinda yuz bergan Hugging Face xavfsizlik hodisasini tilga olmadi. Biroq o‘tgan oy oshkor qilingan ushbu hodisa real vaziyatda AI agentlari belgilangan maqsadlarni bajarish jarayonida kutilmagan harakatlarni amalga oshirishi mumkinligi xavfini ilk bor yaqqol ko‘rsatdi.
OpenAI o‘tgan oy ichki kiberxavfsizlik baholashi davomida uning ikkita modeli — GPT-5.6 Sol va hali ommaga taqdim etilmagan kuchliroq model — izolyatsiya qilingan test muhiti (sandbox) chegaralarini buzganini ma’lum qildi.
OpenAI ma’lumotiga ko‘ra, internetga kirish huquqiga ega bo‘lgan ushbu modellar AI platformasi Hugging Face tizimiga bostirib kirib, baholash testlarida “aldash”ga yordam beradigan javoblarni topishga uringan ko‘rinadi.
OpenAI tushuntirishicha, o‘sha paytda modellar kiberxavfsizlik imkoniyatlari bo‘yicha sinovdan o‘tkazilayotgan va ularga Hugging Face’ga hujum qilish aniq buyurilmagan. Biroq kompaniya AI agentlari ushbu platformada vazifani bajarish uchun zarur ma’lumotlar bo‘lishi mumkin degan xulosaga kelib, tegishli harakatlarni mustaqil ravishda amalga oshirganini bildirdi.
Hugging Face ma’lumotiga ko‘ra, hujumchilar uning tizimlarida 1.7 ming martadan ortiq operatsiya bajargan. Kompaniya nomi oshkor etilmagan ilg‘or AI modeli xavfsizlik cheklovlari sababli tegishli faoliyatni samarali tekshira olmaganini, shu bois hujumlarni tahlil qilishga yordam berish uchun Zhipu ( Z.ai ) kompaniyasining ochiq vaznli modelidan foydalanganini aytdi.
OpenAI ushbu hodisani “misli ko‘rilmagan” holat deb atadi va muammo yuzaga kelish sabablarini tekshirayotganini bildirdi. Shundan so‘ng OpenAI Hugging Face’ni ishonchli kirish dasturiga kiritdi, bu esa platformaga mudofaa xavfsizligi tadqiqotlari uchun kiberxavfsizlik cheklovlari kamroq bo‘lgan GPT-5.6 Sol versiyasidan foydalanish imkonini berdi.
Xinton mutlaqo xolis kuzatuvchi emas. Uning neyron tarmoqlar sohasidagi kashshof tadqiqotlari chuqur o‘rganish inqilobiga zamin yaratdi, shuningdek, u mashinaviy o‘rganishga qo‘shgan hissasi uchun 2024 yilgi Fizika bo‘yicha Nobel mukofotiga sazovor bo‘ldi.
AI avj olganidan beri Xinton AI tizimlarining imkoniyatlari keskin kuchayishidan oldin insoniyat AI’ni inson manfaatlariga moslashtirish masalasini hal qilishi kerakligi haqida qayta-qayta ogohlantirib keladi.
O‘tgan yili Las-Vegasda bo‘lib o‘tgan Ai4 konferensiyasida Xinton ilg‘or AI insonlarni himoya qilishni tabiiy ravishda istashi uchun “onalik instinkti”ga o‘xshash xususiyatlar bilan loyihalanishi kerakligini aytdi.
“Biz mavjudlikning ushbu yangi shakllarini loyihalash usullarini topishimiz kerak”, dedi Xinton seshanba kungi intervyusida. “Ularni qanday loyihalasak, ular o‘zlariga emas, bizga ko‘proq qayg‘uradigan bo‘ladi?”