

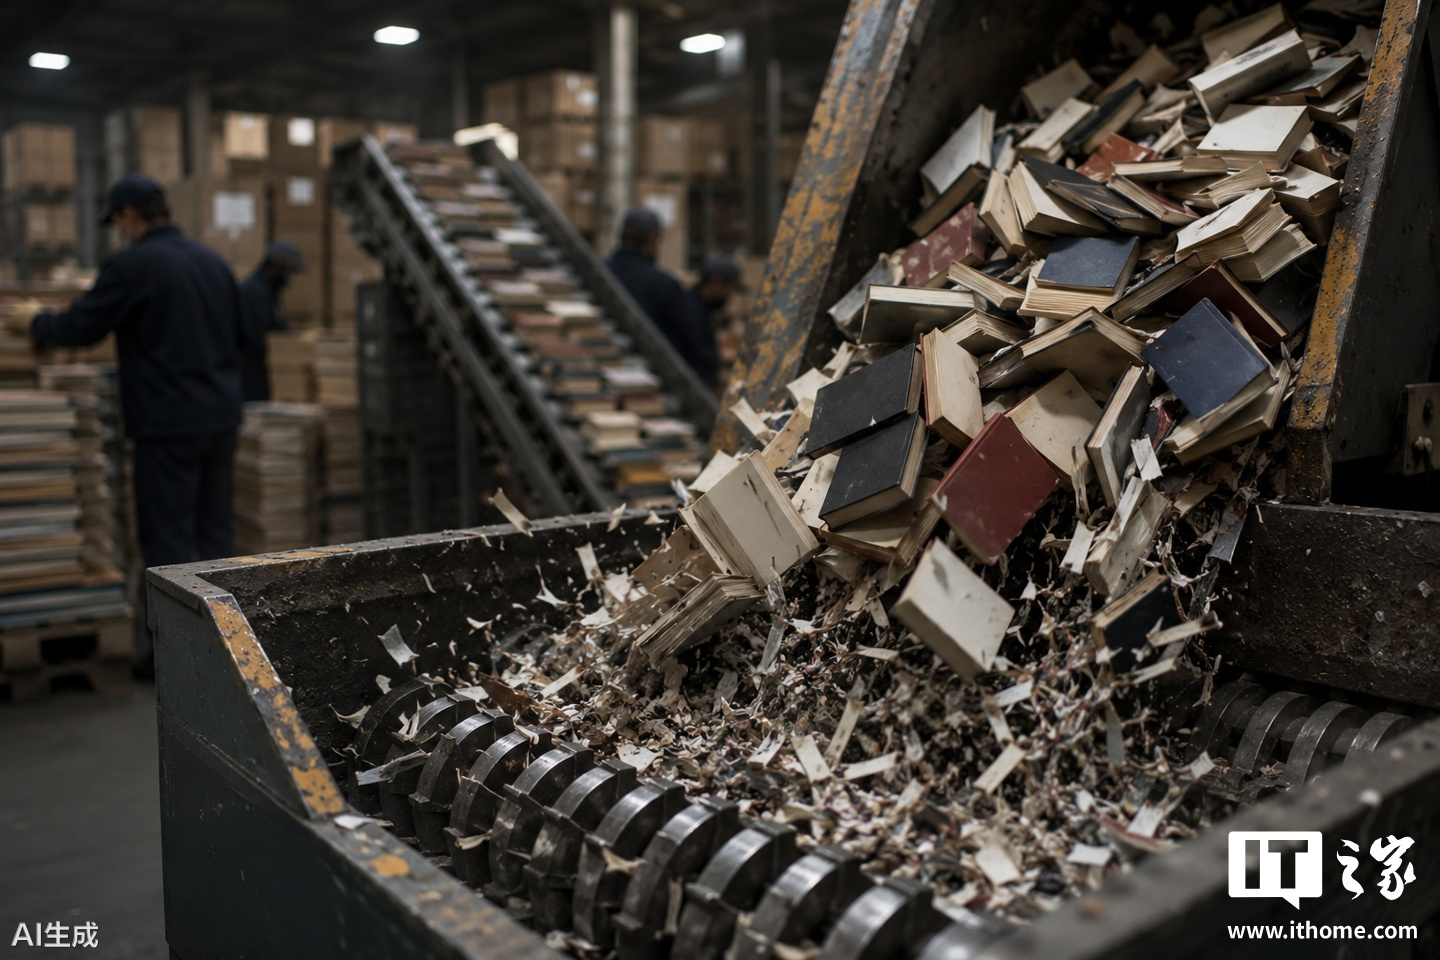
AI kompaniyalari xotira va saqlash resurslari taqchilligini tobora kuchaytirganidan so‘ng, endi insoniyatning adabiy merosiga ham ko‘z tikayotganga o‘xshaydi. Tergov nashri 404 Media’ning so‘nggi xabariga ko‘ra, bir nechta AI kompaniyasi jamoatchilik noroziligini keltirib chiqarmasdan, AI modellarini o‘qitish uchun yuqori sifatli trening ma’lumotlarini olish maqsadida vositachilar orqali ikkinchi qo‘l kitoblarni katta miqyosda sotib olmoqda.
AI rivoji ulkan hajmdagi ma’lumotlarsiz mumkin emas, biroq barcha ma’lumotlar ham qadrli emas, bunda asosiy omil ma’lumot sifati hisoblanadi. So‘nggi yillarda AI tomonidan yaratilgan ko‘plab sifatsiz materiallar (odatda “AI chiqindilari” deb ataladi) internetni to‘ldirib, nafaqat ma’lumotlar muhitini ifloslantirdi, balki AI’ning keyingi o‘rganish samaradorligini ham pasaytirdi. Shu sababli yetakchi AI kompaniyalari insonlar yaratgan kontentni, ayniqsa 2022-yilgacha nashr etilgan bosma kitoblarni qayta izlay boshladi, chunki bunday materiallar original asarlar bo‘lishi va hali AI yaratgan kontent bilan ifloslanmagan bo‘lishi ehtimoli yuqori.
Aslida, AI modellarini bosma kitoblar yordamida o‘qitish holatlari avval ham bo‘lgan. Hozirda mualliflik huquqi bo‘yicha sud jarayonlariga tortilgan asosiy AI kompaniyalaridan biri Anthropic Claude AI modelini o‘qitish uchun kontentni ajratib olish maqsadida millionlab dollar sarflab, katta miqdorda bosma kitoblar sotib olgan va keyin bu kitoblarni yo‘q qilgan. Ma’lum bo‘lishicha, kompaniya kitoblarni Better World Books’dan katta hajmda xarid qilgan. Sud qonuniy xarid qilingan kitoblardan AI treningida foydalanishni mualliflik huquqi to‘g‘risidagi qonun doirasidagi “halol foydalanish” deb topgan bo‘lsa-da, Anthropic 7 millionta pirat kitobni o‘z ichiga olgan ma’lumotlar bazasini uzoq vaqt saqlagani sababli mualliflar va nashriyotlar huquqlarini buzgan. Oxir-oqibat kompaniyaga 1,5 milliard dollar (izoh: joriy kurs bo‘yicha taxminan 10,162 milliard yuan) miqdorida tovon to‘lash jazosi berilgan.
Shunga o‘xshash bahs Google bilan bog‘liq holda ham yuzaga kelgan. Yaqinda nashriyotlar alyansi Google’ni sudga berib, uni mualliflik huquqi bilan himoyalangan millionlab kitoblardan Gemini AI modelini o‘qitishda ruxsatsiz foydalanganlikda aybladi.
1,11 milliarddan ortiq kitob katalogi haqidagi ma’lumotlarga ega ISBNdb onlayn ma’lumotlar bazasi uzoq vaqt davomida kitob sotuvchilari, kutubxonalar va distribyutorlar uchun muhim platforma bo‘lib kelgan. AI sanoatining jadal rivojlanishi bilan ISBNdb ham biznes yo‘nalishini o‘zgartirib, AI korxonalariga mo‘ljallangan keng ko‘lamli kitob xaridi xizmatini yo‘lga qo‘ydi.
404 Media xabariga ko‘ra, buyurtmalar hajmi bir martalik 1000 ta kitob xarididan 1 millionta kitob xaridigacha bo‘ladi.
Ismini oshkor qilishni istamagan professional kitob sotuvchilardan biri joriy yilning aprel oyidan beri kitob savdosida misli ko‘rilmagan o‘sish kuzatilganini aytdi. Ilgari savdo yaxshi bo‘lgan paytlarda haftasiga atigi 20 ga yaqin kitob sotilgan bo‘lsa, so‘nggi oylarda haftalik savdo yuzlab nusxalargacha oshib, odatdagi ko‘rsatkichdan taxminan besh baravar yuqori bo‘lgan.
Alibris, Biblio kabi ikkinchi qo‘l kitob savdo platformalaridagi boshqa sotuvchilar ham shunga o‘xshash yirik xaridlar kuzatilganini bildirgan.
Hozircha bu xaridlar ISBNdb yoki biror AI kompaniyasidan kelib chiqqanini tasdiqlovchi aniq dalillar yo‘q, biroq bu jarayonda ko‘plab g‘ayrioddiy holatlar mavjud. Masalan, ommaviy xarid qilinayotgan kitoblarning deyarli barchasida xalqaro standart kitob raqami (ISBN) bor. 13 ta raqamdan iborat ushbu kod butun dunyoda kitoblarning yagona identifikatori hisoblanadi.
Bundan tashqari, xaridlarda mavzu, janr yoki muallif bo‘yicha deyarli hech qanday tanlov yo‘q: romanlar, darsliklar va maxsus kitoblarning barchasi xarid doirasiga kiradi. Bundan ham ajablanarlisi, xaridorlar narxga umuman e’tibor bermayotganga o‘xshaydi: ayrim kitoblar bozor narxidan ancha qimmat bo‘lsa ham, ularni to‘g‘ridan-to‘g‘ri sotib olishadi.
Anthropic’ning mualliflik huquqi bo‘yicha sud jarayoni davomida Google Books loyihasida ishtirok etgan va keyinchalik Anthropic’ning “Panama loyihasi (Project Panama)” raqamlashtirish loyihasiga rahbarlik qilgan Tom Xarvi (Tom Harvey) Anthropic bosma kitoblarni raqamlashtirish uchun bir nechta professional hujjatlarni skanerlash kompaniyasini yollaganini tasdiqladi.
Hamkor kompaniyalardan biri Datamation Information Services bo‘lib, u kitoblarni raqamlashtirish uchun buzmasdan skanerlash va buzib skanerlash xizmatlarini taqdim etadi.
Buzmasdan skanerlash odatda yuqoridan suratga oluvchi skaner, planshetli skaner yoki V shaklidagi skanerlash qurilmasi yordamida kitobni qismlarga ajratmagan holda amalga oshiriladi. Buzib skanerlashda esa kitob to‘g‘ridan-to‘g‘ri qismlarga ajratilib, har bir sahifa yuqori tezlikdagi sanoat skaneriga yuboriladi.
Buzib skanerlash samaraliroq va arzonroq bo‘lgani sababli, AI kompaniyalari odatda ushbu usulni tanlaydi. Natijada millionlab bosma kitoblar qismlarga ajratib yo‘q qilingan.
Shubhasiz, bosma kitoblar AI uchun ulkan bilim xazinasidir. Biroq bu yondashuv tobora ko‘proq axloqiy bahslarni ham keltirib chiqarmoqda.
Tanqidchilarning fikricha, AI kompaniyalari raqamlashtirish jarayonida oddiy kitoblar bilan qimmatli yoki nashrdan chiqarilgan kitoblarni ajratadimi-yo‘qmi, hozircha noma’lum. Agar bunday noyob kitoblar qismlarga ajratib yo‘q qilinsa, ular muomaladan butunlay chiqib ketishi mumkin.
Yana bir jiddiy muammo shundaki, skanerlangan kontent oxir-oqibat AI kompaniyalarining xususiy ma’lumotlar bazalariga kiritiladi va faqat AI’ni o‘qitish uchun ishlatiladi, oddiy jamoatchilik esa undan foydalana olmaydi.
Bu shuni anglatadiki, odamlar yanada aqlli AI’ga ega bo‘lishi mumkin, biroq buning evaziga insoniyat to‘plagan ulkan bilim resurslari kelajak avlodlarga ochiq va foydalanish mumkin bo‘lgan shaklda qolmasligi ehtimoli bor.