

Alibaba Cloud’ning “ModelScope hamjamiyati” rasmiy akkaunti kecha (12-kuni) yarim tundan keyin Alibaba Qwen jamoasi Qwen3.8-2.4T-A95B modeli og‘irliklarini rasman ochganini e’lon qildi.
Bu Qwen-Max darajasidagi model og‘irliklarining ilk bor ochiq taqdim etilishidir: modelning jami parametrlari 2.4T, har bir Token uchun 95B parametr faollashtiriladi, mahalliy ravishda 262,144 Token kontekstini qo‘llab-quvvatlaydi va 1,010,000 Token gacha kengaytirilishi mumkin.
Qwen3.8 Qwen3.5 ning gibrid arxitekturasini davom ettirib, dasturlash, ofis ishlari, ilmiy tadqiqotlar va uzoq muddatli Agent vazifalarini boshidan oxirigacha bajarish qobiliyatini yaxshilashga e’tibor qaratadi. Rasmiy bulut versiyasi Qwen3.8-Max ushbu ochiq model og‘irliklari asosida yaratilgan va ishlab chiqarish muhiti uchun qo‘shimcha imkoniyatlarni o‘z ichiga oladi.
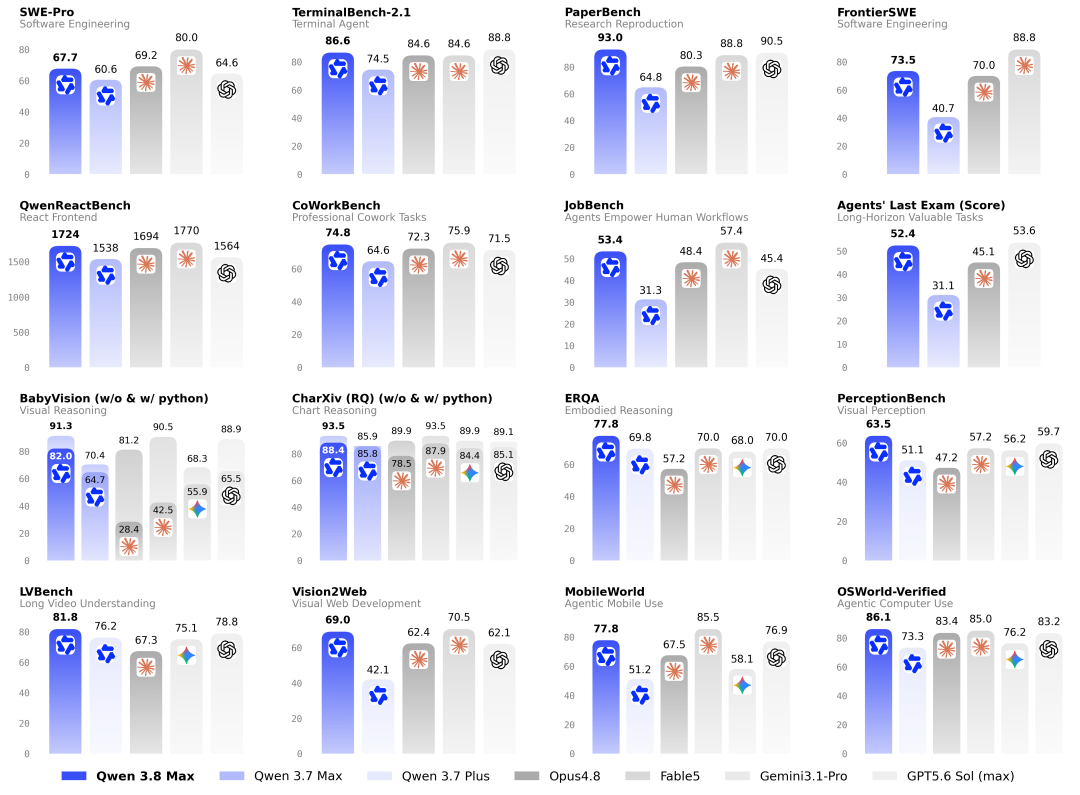
Rasmiy e’lon qilingan baholashlar dasturlash agenti, universal agent, professional ish va uzun kontekst kabi yo‘nalishlarni qamrab oladi; Opus 4.8, Fable 5, GPT 5.6 Sol kabi modellar bilan taqqoslaganda, natijalar yo‘nalishlarga qarab farq qiladi va PaperBench, IFBench kabi Benchmarklarda ro‘yxatdagi modellar orasida yuqori natijalarga erishilgan.
Tegishli havolalar:
Model: https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
blog: https://qwen.ai/blog?id=qwen3.8
Qwen Studio: https://chat.qwen.ai
Qwen3.8-2.4T-A95B — sababiy til modeli bo‘lib, jami parametrlari 2.4T, har bir Token uchun 95B parametr faollashtiriladi. Modelning har bir MoE qatlami 512 ta ekspertni o‘z ichiga oladi; har bir Token 10 ta yo‘naltiruvchi ekspertni tanlaydi va bir vaqtning o‘zida 1 ta umumiy ekspertni faollashtiradi.
Model, shuningdek, ko‘p bosqichli MTP (Multi-Token Prediction) treningidan o‘tkazilgan bo‘lib, tegishli mexanizmni qo‘llab-quvvatlaydigan inferens dvigatellariga bir nechta keyingi Tokenlarni bashorat qilish imkonini beradi.
Ma’lumotga ko‘ra, Qwen3.8-Max’ning ofis ishlari va Agent uchun keyingi treningi uch bosqichdan iborat:
Haqiqiy muhitni uzluksiz kengaytirish va ushbu mustaqil o‘lchamlarni ajratish: vazifa (Task) (bitta vazifa → ko‘p vazifa → kunlar davom etadigan vazifa), ish maydoni (Workspace) (ko‘p fayl → ierarxik katalog → murakkab geterogen katalog), Harness (turli toifalar, versiyalar, ko‘nikmalar). Bu muhitlar sonining har birini alohida moslashtirilgan integratsiyaga tayanmasdan, kombinatsiya asosida tabiiy ravishda o‘sishiga imkon beradi.
Haqiqiy vazifalardagi turlicha tekshirish usullarini o‘z ichiga oladigan yagona mukofot tizimini yaratish. Ushbu tizim bajarilishga asoslangan tekshiruv, matn va render qilingan vizual chiqishlarni rubric asosida baholash, shuningdek agentic tekshiruvni qamrab oladi. Turli shakl va modalliklarni yagona mukofot tizimida birlashtirish orqali barcha muhitlar uchun izchil va ishonchli mukofot signali ta’minlanadi hamda vazifaga xos verifier’larni qo‘llab-quvvatlashga xos nomuvofiqliklar bartaraf etiladi.
Onlayn ma’lumotlar muvozanatlashtirgichini yaratish va har bir batch’ni qayta tuzish: unda vazifa, qiyinchilik, ish maydoni va harness bo‘yicha taqsimot yuqori darajada muvozanatlangan bo‘ladi. Bu batch’lar orasidagi gradient dispersiyasini kamaytirib, reinforcement learning treningi uchun hisoblash quvvatini barqaror va uzluksiz kengaytirishni qo‘llab-quvvatlaydi.