
Model baholash
AIEZZ vosita tegi
“Model baholash” tegi bilan belgilangan AI mahsulotlari ko‘rilmoqda; 5 ta mos natija mavjud.
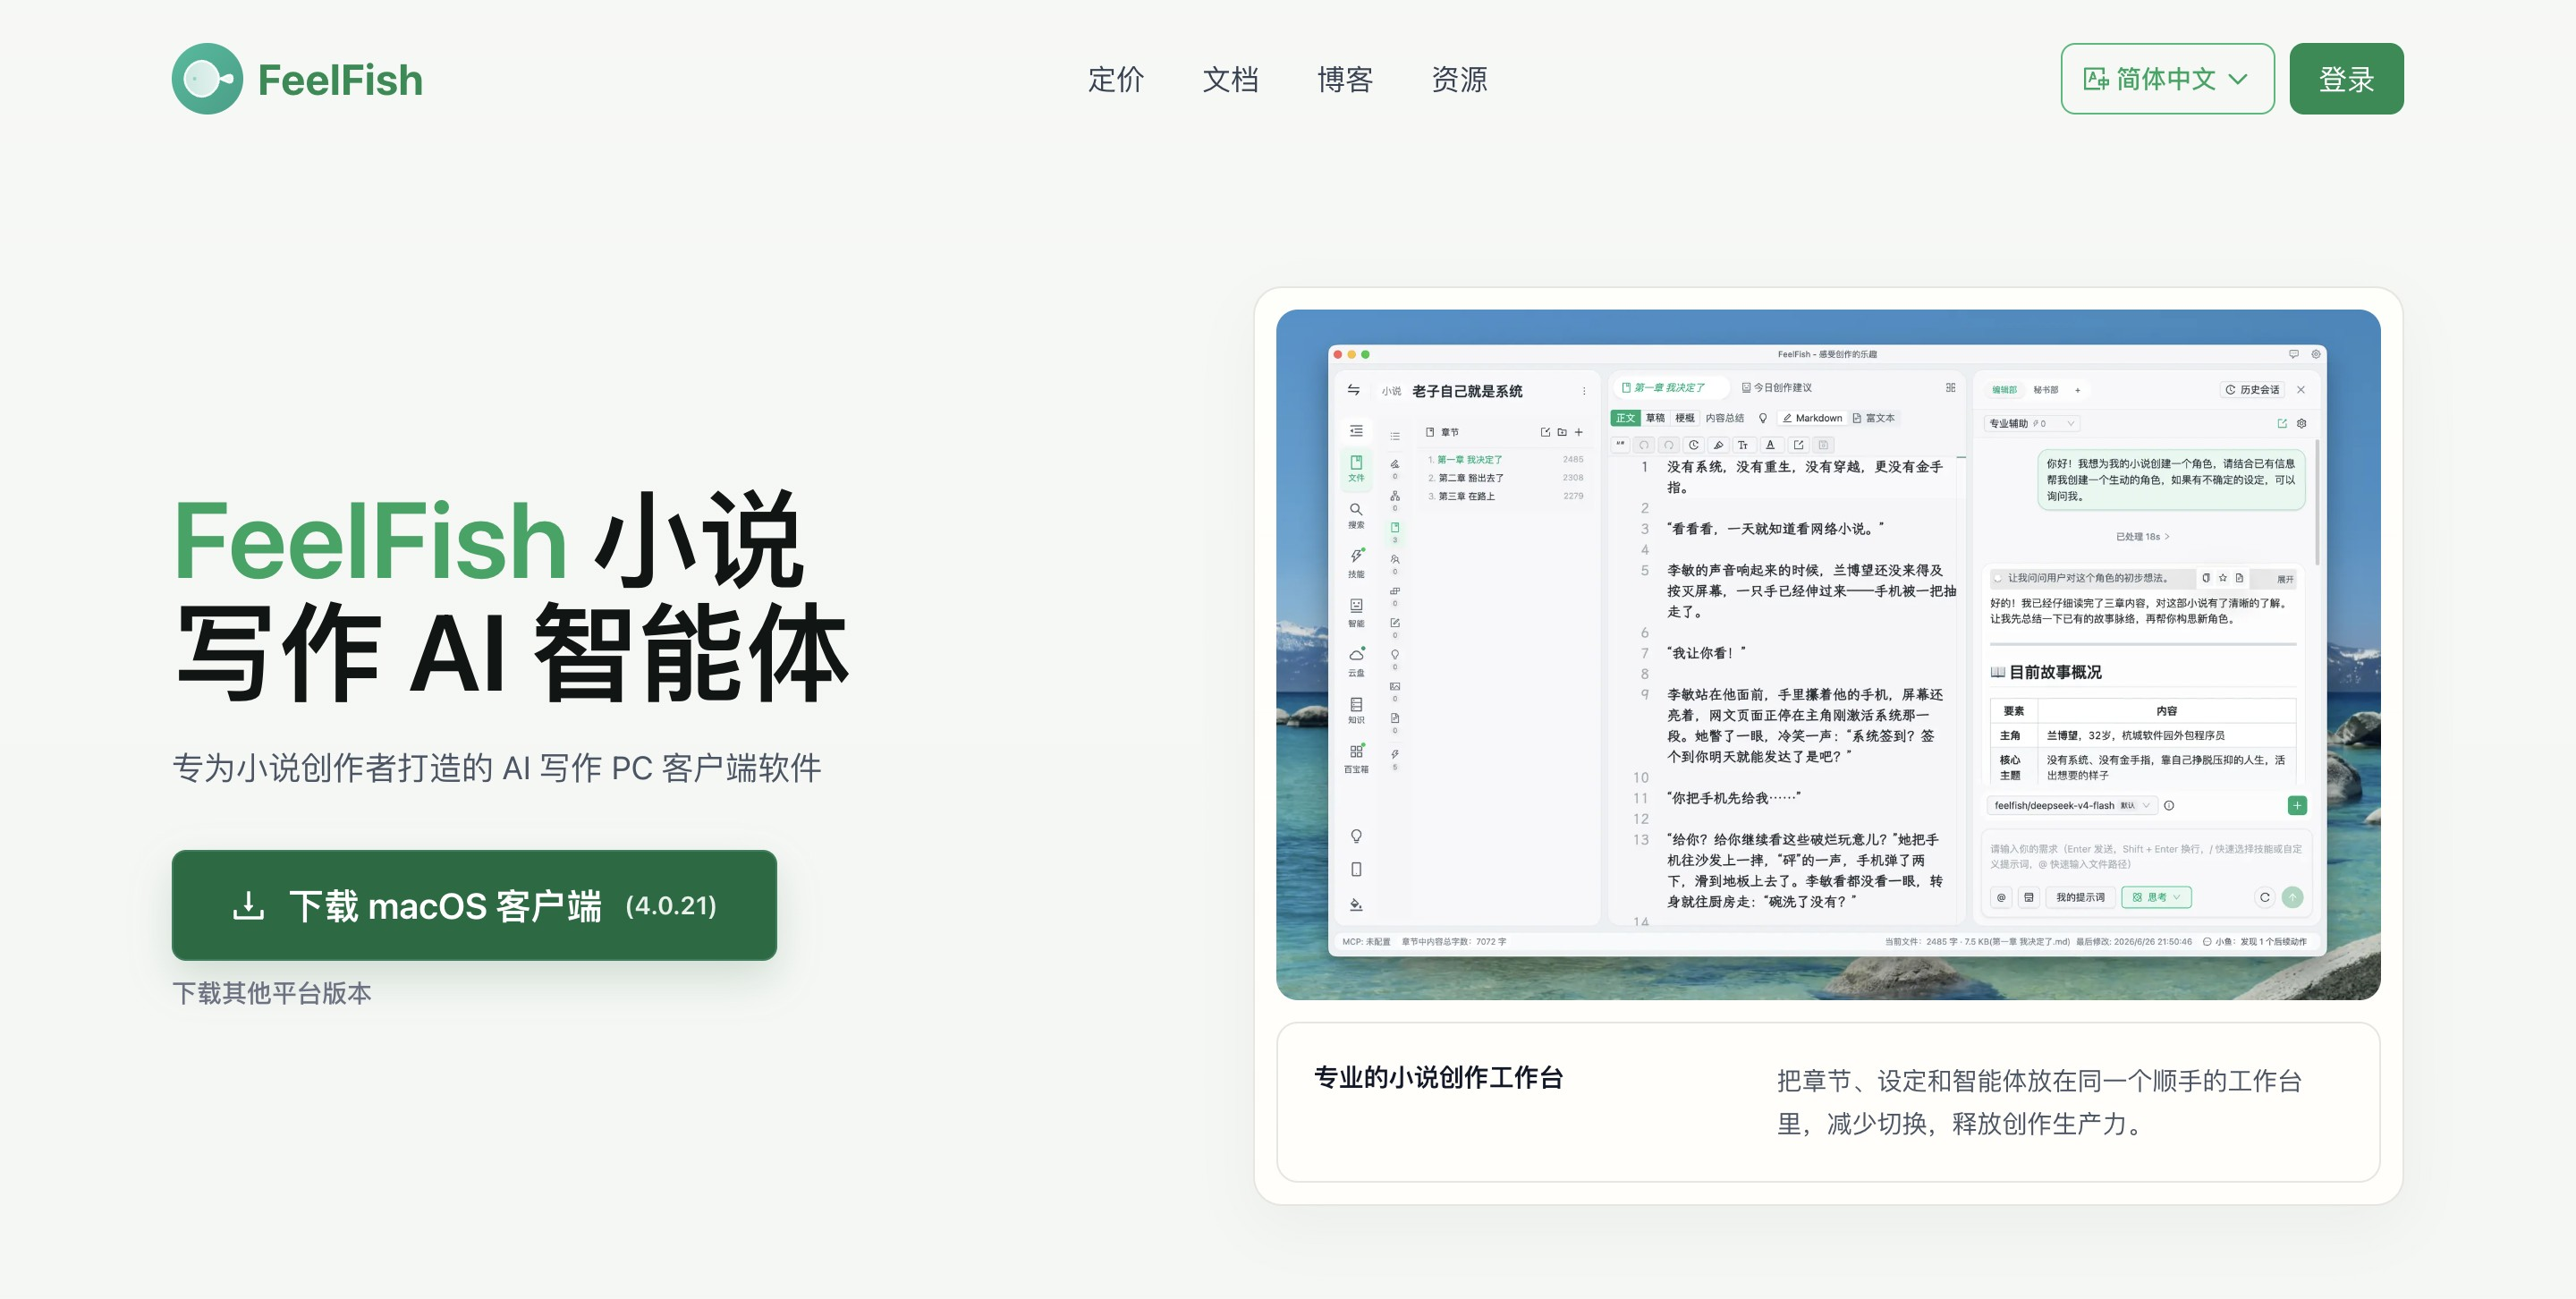 2026-yilgi AI roman yozish dasturlarining so‘nggi sharhi: FeelFish 4.0AI dasturlashFeelFish 4.0 — professional roman yozish dasturi bo‘lib, katta AI modellarini loyihangizni tushunadigan yozuvchilar jamoasiga aylantiradi. U boblar, reja, qahramonlar va sozlamalarni qamrab oluvchi tizimli loyiha boshqaruvini taqdim etadi hamda katta hajmli asarlarda mantiqiy izchillikni saqlash uchun aqlli kontekstni qo‘llab-quvvatlaydi. Ushbu vosita bir nechta agentlarning hamkorligini sozlash, kompyuter va mobil qurilmalardan masofadan boshqarish imkonini beradi. Shuningdek, qo‘lyozmalar xavfsizligini ta’minlash uchun bulutli disk sinxronizatsiyasi va mahalliy vaqt mashinasi bilan jihozlangan. U internet romanlari, ssenariylar va boshqa katta hajmli asar yaratuvchilariga inson va AI hamkorligining to‘liq ish jarayonini taqdim etishga mo‘ljallangan.00
 LMArenaAI vositalar qutisiLMArena — Kaliforniya universiteti, Berkli akademik jamoasi boshchiligidagi, hamjamiyat asosida ishlaydigan sun’iy intellekt modellarini baholash platformasi. Uning asosiy jarayonida ikki modeli yashirin holda bir xil savolga javob beradi, foydalanuvchilar esa javoblar sifatiga qarab ovoz beradi; ovoz berilgach, modellar kimligi ko‘rsatiladi. Platforma ovoz berish natijalari va shaxmatdagiga o‘xshash Elo reytingi mexanizmi asosida dinamik reytinglar tuzadi hamda matn, tasvir kabi vazifalarni qamrab oladi. U sun’iy intellekt tadqiqotchilari, dasturchilar, texnologiya ishqibozlari va modellarni yonma-yon taqqoslamoqchi bo‘lgan oddiy foydalanuvchilar uchun mos. Shuningdek, tadqiqotlarda foydalanish uchun ochiq ma’lumotlar to‘plamlarini taqdim etadi. Shuni yodda tutish kerakki, reytinglar haqiqiy foydalanuvchi afzalliklari va muayyan vazifalardagi natijalarni aks ettiradi; ular biznes ehtiyojlari, xarajat yoki barqarorlik bo‘yicha maxsus testlarning o‘rnini bosa olmaydi.048
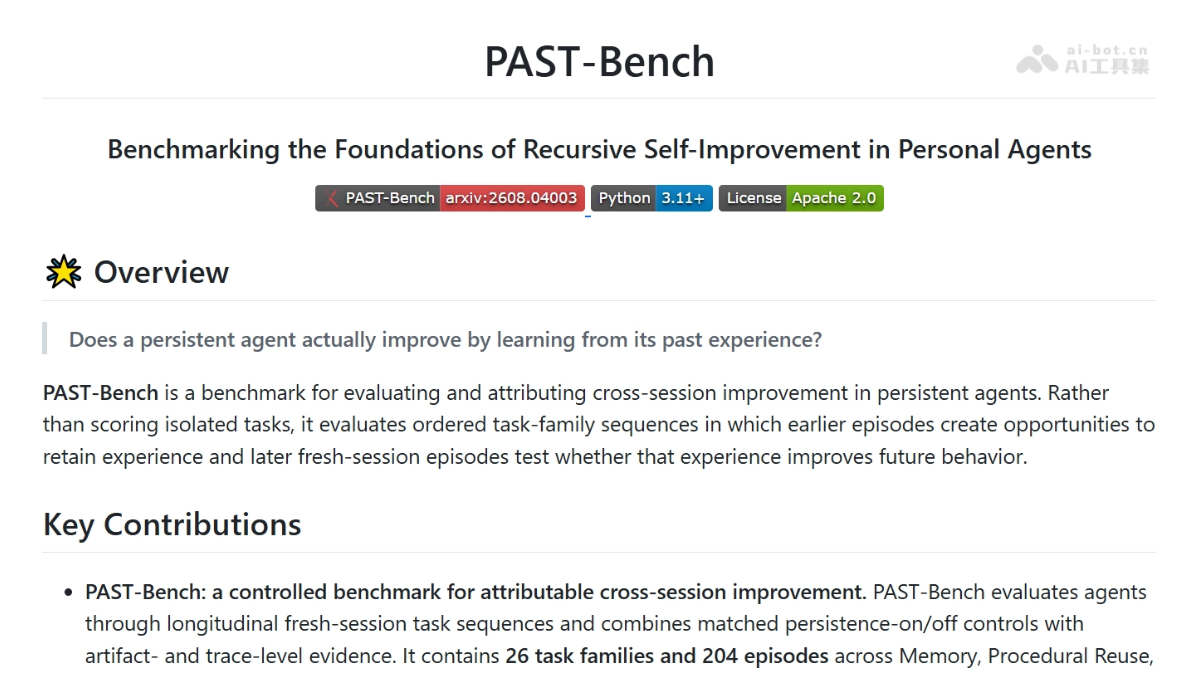 PAST-BenchAI agentiPAST-Bench — Prinston universitetidagi Van Men-di jamoasi tomonidan ishlab chiqilgan benchmark bo‘lib, shaxsiy AI Agent’larning rekursiv o‘z-o‘zini takomillashtirish qobiliyatini sinash uchun mo‘ljallangan. PAST-Bench xotirali va xotirasiz sharoitlardagi vazifalar natijalarini taqqoslash orqali...00
 E-Bench – Tencent Hunyuan va boshqalar tomonidan ishlab chiqilgan agentlarni baholash mezoniAI modellarini baholashE-Bench — Tencent Hunyuan jamoasi, Tsinghua universiteti AIR laboratoriyasi va Janubi-sharqiy universitet tomonidan birgalikda ishlab chiqilgan ko‘p bosqichli vositalardan foydalanishni baholash mezonidir. U «Honor of Kings», QQ Music va Tencent Meeting asosida to‘liq sintetik virtual muhit yaratadi hamda 323 ta holatni o‘zgartirish vazifasi va 7.6万 dan ortiq ma’lumot yozuvlarini o‘z ichiga oladi. Axborot bo‘shlig‘i va vositalar bo‘shlig‘iga asoslangan ikki tomonlama nomutanosib dizayn orqali modellarni ma’lumotni faol izlash va ko‘p bosqichli vosita chaqiruvlarini rejalashtirishga undaydi. Baholashda ma’lumotlar bazasi holatidagi diff deterministik tarzda hisoblanadi, natijalar barqaror va qayta tiklanadigan bo‘ladi. Ushbu mezon AI agentlari tadqiqotchilari va model ishlab chiquvchilariga mo‘ljallangan bo‘lib, yuqori narx-samaradorlikka ega modellarni aniqlash hamda umumiy agentlarni baholash standartlarini rivojlantirishga yordam beradi.00
 Gemini 3.7 FlashAI dasturlashGemini 3.7 Flash — Google DeepMind tomonidan taqdim etilgan yangi avlod asosiy AI modeli. Model Coding va Agent ish jarayonlari uchun maxsus ishlab chiqilgan bo‘lib, dasturiy ta’minot muhandisligi, veb-ishlab chiqish va korporativ avtomatlashtirish mezonlarida keskin yuqori natijalarni ko‘rsatadi...00
Bu tegdagi barcha vositalar ko‘rsatilgan.