
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-09-10
01AuK nima?
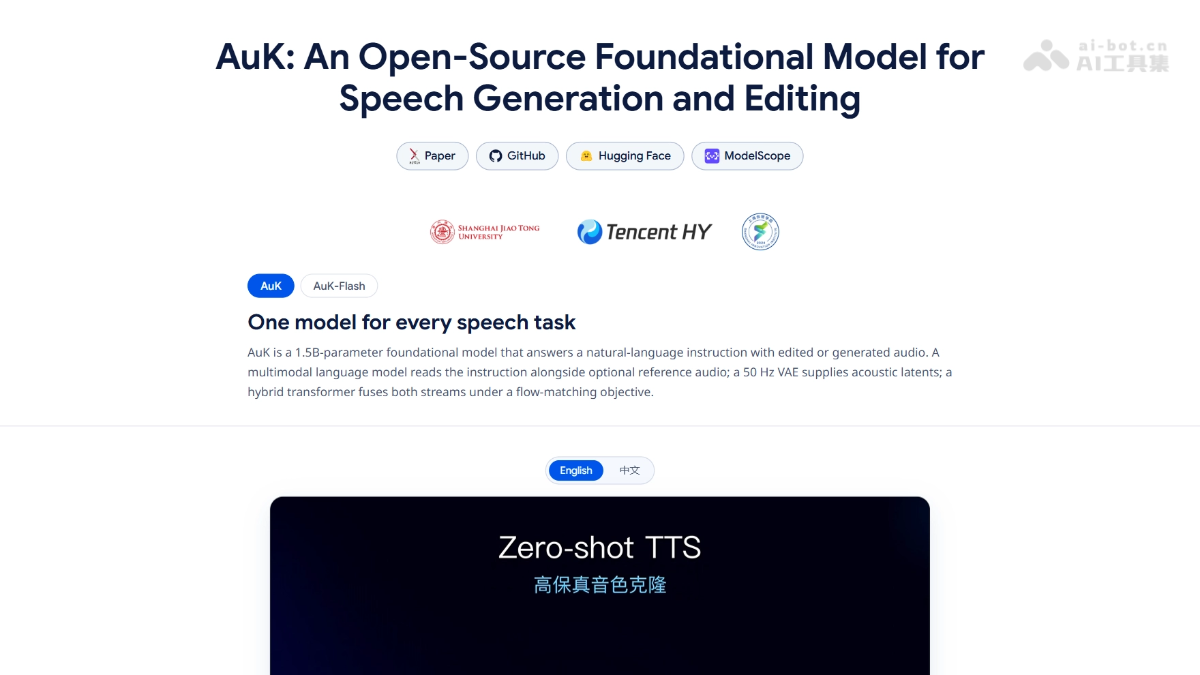
AuK — Tencent Hunyun tomonidan ochiq manba sifatida taqdim etilgan, 15亿 parametrli nutq generatsiyasi va tahrirlash asosiy modeli bo‘lib, autoregressiv emas, oqim moslashtirish diffuziyasi arxitekturasidan foydalanadi. Model yagona tabiiy til buyruqlari interfeysi orqali 16 xil nutq vazifasini, jumladan, nol namunali/buyruqli TTS, nutq mazmunini tahrirlash, akustik sozlash, paralingvistik tahrirlash, shuningdek, shovqinni kamaytirish va inson ovozini ajratishni bajaradi. Model 4 bosqichli inferensiyaga ega AuK-Flash tezkor versiyasini ham taqdim etadi; tezlik taxminan 4.5 baravar oshirilgan.
02AuKning asosiy funksiyalari
Zero-shot TTS: bir necha soniyalik namunaviy audio orqali ovoz tembrini klonlab, yangi nutq sintez qiladi.
Instruct TTS: ovoz xususiyatlarini faqat matn orqali tasvirlash kifoya; namunaviy audio talab qilinmaydi.
Nutq mazmunini tahrirlash: ovoz tembri va ohangini o‘zgartirmagan holda yozuvdagi so‘zlarni almashtirish, qo‘shish yoki o‘chirish.
Qo‘shiq matnini tahrirlash: kuy va vokal xususiyatlarini saqlagan holda faqat qo‘shiq so‘zlarini o‘zgartirish.
Pitch/tezlik/ovoz balandligini tahrirlash: akustik xususiyatlarni yarim ton, karrali tezlik va detsibel birliklarida aniq sozlash.
Emotsiya va tembrni tahrirlash: so‘zlarni almashtirmasdan hissiy tusni o‘zgartirish yoki mazmunni saqlagan holda tembrni almashtirish.
Shevani tahrirlash va shovqinni kamaytirish: shevani yo‘qotish, shovqin va reverberatsiyani kamaytirish orqali ravshanlikni oshirish.
Paralingvistik hodisalarni tahrirlash: nafas olish, kulgi va yo‘tal tovushlarini qo‘shish yoki olib tashlash, oddiy nutqni shivirlashga va aksincha aylantirish.
Nutqni ajratish: ko‘p kishilik audioni so‘zlashish tartibiga ko‘ra bo‘lish yoki mazmun tavsifi asosida kerakli so‘zlovchini ajratib olish.
Musiqani ajratish: qo‘shiqdan vokalni ajratib olish va伴奏ni olib tashlash.
03AuKning texnik prinsipi
WeChat’da kuzatib, “开源” deb javob yuboring va AI ochiq manba loyihalari guruhiga qo‘shiling.
Umumiy paradigma: AuK audio latent fazo tasvirlarini yaratish uchun flow-matching diffuziya arxitekturasidan foydalanadi. Bu arxitektura “tahrirlash” vazifalariga tabiiy ravishda mos keladi: asl audioning latent tasviri denoising jarayonining boshlang‘ich nuqtasi sifatida olinadi va faqat buyruqda ko‘rsatilgan qism o‘zgartiriladi. Natijada asl tembr, kuy va tahrirlanmagan mazmun yaxshiroq saqlanadi. Bu uning tahrirlash vazifalari oilasini qamrab olishining texnik asosidir.
Uch komponentli pipeline arxitekturasi: tizim uch qismdan iborat. Multimodal katta til modeli tabiiy til buyruqlari va namunaviy audioni o‘qib, semantik shartlarni yaratadi; audio VAE 24kHz to‘lqin shaklini 50Hz akustik latent fazoga kodlaydi; asosiy gibrid Transformer 10 qatlamli ikki oqimli MMDiT va 20 qatlamli bir oqimli DiT bloklaridan tuzilgan. Model kengligi 1536, jami parametrlar soni 15亿.
Katta miqyosdagi buyruqlarni moslashtirish treningi: trening ma’lumotlari taxminan 30.3 milliardta “buyruq — audio” juftligidan iborat bo‘lib, jami taxminan 195万 soatlik samarali nazorat ma’lumotini qamrab oladi. Muhim jihati shundaki, barcha vazifalar yagona “buyruq + kirish audiosi → chiqish audiosi” formatiga keltirilgan. Shu sababli model yagona interfeys orqali 16 xil vazifaga umumlashtiriladi.
Treningdan keyingi bosqich va inson afzalliklarini optimallashtirish: asosiy treningdan so‘ng model inson afzalliklarini optimallashtirish va mustahkamlovchi o‘qitish asosidagi post-training (RL post-training) jarayonidan o‘tkaziladi. Bu generatsiya qilingan nutqning tabiiyligi, buyruqqa rioya qilishi va eshitish sifatini yaxshilaydi.
04AuKdan qanday foydalaniladi
Uskuna muhitini tekshiring: taxminan 24GB videoxotiraga ega NVIDIA GPU, masalan, RTX 3090/4090 tayyorlang.
Kod omborini klonlang: GitHub’dan Tencent-Hunyun/AuK omborini mahalliy kompyuterga klonlang.
Qaramliklarni o‘rnating: ombor talablariga muvofiq Python muhitini sozlang va kerakli paketlarni o‘rnating.
Model og‘irliklarini yuklab oling: Hugging Face yoki ModelScope’dan AuK og‘irliklari va unga mos VAE fayllarini yuklab oling.
Semantik shartlar modelini yuklab oling: buyruqlar va namunaviy audioni tahlil qilish uchun Qwen2.5-Omni-3B multimodal katta til modelini alohida yuklab olib sozlang.
Kirish materiallarini tayyorlang: maqsadli matn, namunaviy audio yoki tahrirlanadigan asl audio faylni tayyorlang.
Tabiiy til buyruqlarini yozing: vazifaga qarab ovoz xususiyatlarini tasvirlash, almashtiriladigan jumla yoki sozlanadigan pitch/tezlikni ko‘rsatish kabi buyruqlar tuzing.
Inferensiyani ishga tushiring: buyruq satri (CLI) orqali buyruq va materiallarni kiriting, generatsiya yoki tahrirlashni bajaring va natijani kuting.
Tinglab ko‘ring va sozlang: natijaviy audioni tekshiring; qoniqarsiz bo‘lsa, buyruq ifodasini, sampling bosqichlari sonini yoki CFG kuchini o‘zgartirib, qayta generatsiya qiling.
05AuKning asosiy afzalliklari
Yagona interfeys, vazifalarning to‘liq qamrovi: model tabiiy til buyruqlari orqali TTS, tahrirlash, yaxshilash va ajratish kabi 16 xil nutq vazifasini bajara oladi; har bir vazifa uchun alohida modelni joylashtirish shart emas.
Tahrirlash qobiliyati sohada noyob: so‘zlarni almashtirish, jumla qo‘shish, pitchni sozlash va emotsiyani o‘zgartirish kabi nozik tahrirlarni qo‘llab-quvvatlaydi, shu bilan birga asl tembr va ohangni imkon qadar saqlaydi.
Instruct TTS’da namunaviy audio talab qilinmaydi: ovoz xususiyatlarini matn orqali tasvirlash yordamida nutq yaratish mumkin, bu foydalanish chegarasini pasaytiradi.
Oqim moslashtirish arxitekturasi yuqori aniqlikni ta’minlaydi: tokenma-token bashorat o‘rniga diffuziyaviy generatsiyadan foydalanadi; tahrirlashda asl audio denoising uchun boshlang‘ich nuqta bo‘ladi va o‘zgartirilmagan qismlar deyarli zararlanmaydi.
06AuK loyihasi manzillari
Loyiha rasmiy sayti: https://auk-project.github.io/
GitHub ombori: https://github.com/Tencent-Hunyuan/AuK
Hugging Face model ombori: https://huggingface.co/tencent/AuK
arXiv texnik maqolasi: https://arxiv.org/pdf/2609.08936
07AuKdan foydalanish scenariylari
Film va qisqa seriallar post-prodakshnida dialoglarni tuzatish: aktyor so‘zni noto‘g‘ri aytganda yoki ssenariy biroz o‘zgarganda, yozuvdagi alohida so‘z va jumlalarni to‘g‘ridan-to‘g‘ri almashtirish, qayta dublyaj qilishga hojat qoldirmaslik va asl ijro emotsiyasini saqlash.
Podkast va intervyu tayyorlash: til xatolari va ortiqcha gaplarni olib tashlash, nutq tezligi va ritmini sozlash, fon shovqini hamda reverberatsiyani yo‘qotish orqali xom montajni bir urinishda tayyor mahsulotga aylantirish.
Audiokitob va AI dublyaj ishlab chiqarish: Instruct TTS yordamida personaj tavsifiga ko‘ra farqlanuvchi tembrlarni yaratish; bir narrator keyinchalik emotsiya va ohangini ham sozlay oladi, bu ko‘p personajli kontent ishlab chiqarish xarajatlarini kamaytiradi.
Musiqa yaratish va ikkilamchi ijod: asl kuy va vokal xususiyatlarini saqlagan holda cover qo‘shiq matnini o‘zgartirish yoki qo‘shiqdan vokalni ajratib, remix materiali sifatida ishlatish.
Til o‘rgatish va inklyuziv foydalanish: shevaga ega yoki nutqida qiyinchiliklari bo‘lgan foydalanuvchilar uchun shevani kamaytirish, nutq tezligi va ovoz balandligini sozlash hamda yanada ravshan va tushunarli audio kontent yaratish.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0