
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-09-08
01LLaDA-Image nima
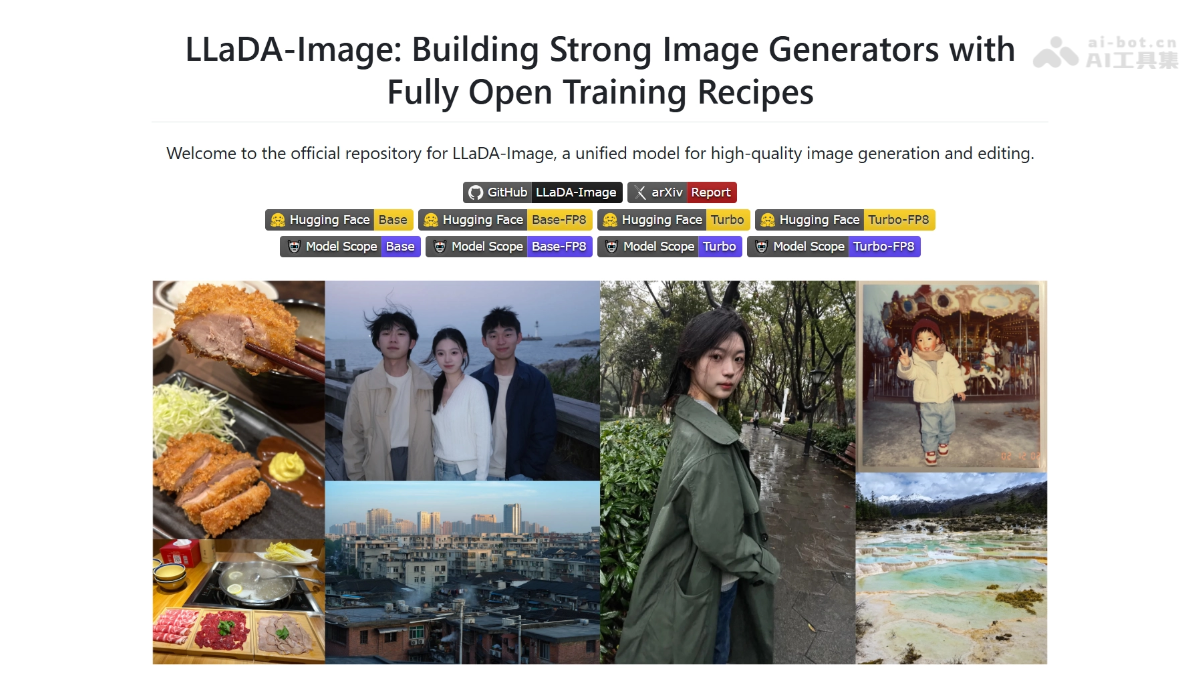
LLaDA-Image — Ant Group’ning inclusionAI jamoasi tomonidan ochiq manbada taqdim etilgan, 6B parametrli yagona tasvir yaratish va tahrirlash modeli. Model avval sof tasvirlar bilan oldindan o‘qitish, keyin esa til bilan moslashtirishga asoslangan innovatsion yondashuvdan foydalanadi. To‘liq diffuziya arxitekturasi (LLaDA2.0-mini tushunishi + 6B DiT generatsiyasi) orqali matndan tasvir yaratish, ko‘rsatmalar asosida tahrirlash hamda xitoycha va inglizcha matnlarni tasvirda aks ettirish imkonini beradi. Turbo versiyasi tasvirni atigi 2–4 qadamda yaratadi va Qwen-Image-Bench sinovining xitoycha hamda inglizcha yo‘nalishlarida ochiq manbali modellar orasida birinchi o‘rinni egallagan.
02LLaDA-Image’ning asosiy funksiyalari
Matndan tasvir yaratish: tabiiy tildagi tavsif asosida yuqori aniqlikdagi, tafsilotlarga boy fotorealistik tasvirlar yaratish.
Ko‘rsatmalar asosida tasvirni tahrirlash: ma’lumotnoma tasvirini yuklash va tabiiy tilda ko‘rsatma kiritish orqali belgilangan hududlarni aniq o‘zgartirish, qolgan qismlarni esa o‘zgarmagan holda saqlash.
Xitoycha va inglizcha ikki tilli matnni aks ettirish: yaratilgan tasvirlarda xitoycha va inglizcha matnlarni aniq ko‘rsatish, poster, maket va badiiy shrift dizaynlarini qo‘llab-quvvatlash.
VQ shartli generatsiyasi: vizual kvantlash (VQ) tokenlaridan shartli kirish sifatida foydalanib, boshqariladigan tasvirlar yaratish.
Ma’lumotnoma tasvirini tahrirlash: yuklangan tasvirdan ma’lumotnoma sifatida foydalanib, uslubni ko‘chirish, mazmunni o‘zgartirish kabi tahrirlash amallarini bajarish.
Turbo tezkor inferens: distillangan model 2–4 ta namuna olish bosqichidagina 1024×1024 o‘lchamdagi yuqori sifatli tasvirlarni yaratishi mumkin.
03LLaDA-Image texnologiyasining ishlash prinsipi
WeChat’da kuzatib, “开源” deb javob yuboring va AI ochiq kodli loyihalar guruhiga qo‘shiling
Yagona to‘liq diffuziya arxitekturasi: model tushunish moduli LLaDA2.0-mini (MoE asosidagi diffuziya til modeli) va generatsiya moduli 6B DiT’dan iborat. Har ikkala modulning backend’i ham diffuziya modeliga asoslangan bo‘lib, Connector orqali bog‘lanadi va semantik tushunish bilan piksellarni generatsiya qilishni ajratadi.
Bosqichma-bosqich o‘qitish strategiyasi: “avval chizishni, keyin buyruqqa bo‘ysunishni o‘rganish” yo‘li qo‘llanadi. Dastlab sof tasvirli pre-o‘qitish va oraliq o‘qitish orqali kuchli vizual generatsiya apriorisi shakllantiriladi, so‘ng matn va vizual ma’lumotlarni moslashtirish uchun juftlangan til nazorati kiritiladi.
Yuqori sifatli ma’lumotlarni yaratish: generatsiya uchun jami taxminan 2.2 亿 ta namuna ishlatilgan, ularning 98% haqiqiy tasvirlardan iborat. Til bilan moslashtirish bosqichidagi matn-tasvir tavsiflari Qwen seriyasidagi yirik modellar tomonidan yaratiladi va tekshiriladi, bu buyruqlarni aniq bajarishni ta’minlaydi.
Samarali o‘qitishni optimallashtirish: butun jarayonda LayerNorm o‘rniga parametrlarga bog‘liq bo‘lmagan RMSNorm ishlatiladi, shuningdek Muon optimizatori qo‘llanadi. Bu katta miqyosli o‘qitishning barqarorligi va samaradorligini oshiradi.
Twin-DMD yordamida tezkor distillatsiya: Turbo versiyasida Twin-DMD distillatsiya texnologiyasi orqali Base modeli siqiladi. 2–4 bosqichli sampling yordamida 1024×1024 o‘lchamdagi yuqori sifatli tasvirlar yaratiladi va tezlik bilan sifat o‘rtasidagi muvozanat ta’minlanadi.
04LLaDA-Image’dan qanday foydalanish
Muhitni sozlash: Python 3.11, PyTorch 2.8, Diffusers 0.39.0 va FlashAttention 2.8.3 kabi bog‘liqliklarni o‘rnating hamda mahalliy inferens muhitini yarating.
Model og‘irliklarini olish: Hugging Face yoki ModelScope’dan LLaDA-Image (yuqori aniqlikdagi versiya) yoki LLaDA-Image-Turbo (tezkor versiya) model fayllarini yuklab oling.
Matndan tasvir yaratish: modelni yuklagach, tavsif matnini kiriting. Base versiyasida 50 qadam va guidance scale 5.0, Turbo versiyasida 2–4 qadam va guidance scale 1.0 qiymatlarini belgilang; natijada 1024×1024 o‘lchamdagi tasvir yaratiladi.
Ko‘rsatmalar asosida tasvirni tahrirlash: mos yozuvlar tasvirini yuklang va tabiiy tildagi tahrirlash ko‘rsatmasini kiriting (masalan, ”fonni dengiz bo‘yiga o‘zgartir”); model tahrirlanmagan hududlarni avtomatik ravishda o‘zgartirmay saqlaydi.
O‘lcham talablariga e’tibor bering: matndan tasvir yaratish va VQ shartli generatsiyasi uchun kirish o‘lchamlari 16 ga, tahrirlash vazifalari uchun esa 32 ga karrali bo‘lishi kerak.
05LLaDA-Image’ning asosiy afzalliklari
Ochiq manbali modellar orasida yetakchi unumdorlik: Qwen-Image-Bench testining xitoy va ingliz tillaridagi yo‘nalishlarida ochiq manbali modellar orasida birinchi o‘rinni egallab, umumiy natijada FLUX.2 Max kabi yetakchi ochiq manbali modellarni ortda qoldiradi.
Yagona modelda generatsiya va tahrirlash: bitta model yuqori sifatli matndan tasvir yaratish hamda aniq ko‘rsatmalar asosida tasvirni nozik tahrirlashni bir vaqtning o‘zida qo‘llab-quvvatlaydi, turli modellar o‘rtasida almashish talab etilmaydi.
Tezkor inferens: Turbo distillatsiya qilingan versiyasi 1024×1024 o‘lchamdagi yuqori aniqlikdagi tasvirni atigi 2–4 ta sampling bosqichida yaratadi va kutish vaqtini sezilarli darajada qisqartiradi.
Xitoy va ingliz matnlarini renderlash: xitoy va ingliz tillarida matn yaratish bo‘yicha a’lo qobiliyatga ega bo‘lib, posterlar, maketlar, badiiy yozuvlar kabi dizayn vazifalarini bajara oladi.
Fotosurat darajasidagi realizm: 98% real tasvirlardan iborat oldindan o‘qitish ma’lumotlariga asoslangan bo‘lib, natijalarda tabiiy yorug‘lik, boy detallar va yuqori darajadagi realizm mujassam.
06LLaDA-Image loyihasi manzillari
GitHub repozitoriysi: https://github.com/inclusionAI/LLaDA-Image
HuggingFace model kutubxonasi: https://huggingface.co/collections/inclusionAI/llada-image
arXiv texnik maqolasi: https://arxiv.org/pdf/2609.03796
07LLaDA-Image qo‘llanilish sohalari
E-tijorat uchun vizual dizayn: Mahsulot tavsifi asosida bir bosishda asosiy mahsulot rasmini yarating yoki buyruqlar yordamida fonni tezda almashtiring, yorug‘lik va soyalarni sozlang, suratga olish hamda post-ishlov berish xarajatlarini kamaytiring.
Marketing plakatlarini yaratish: Xitoycha va inglizcha matnlarni a’lo darajada ko‘rsatish imkoniyati yordamida brend Slogani va aksiya ma’lumotlari kiritilgan tijoriy plakatlar hamda ijtimoiy tarmoqlar uchun rasmlarni bevosita yarating.
Ijtimoiy tarmoqlar uchun kontent yaratish: Blogerlar va ijodkorlar uchun fotosurat darajasidagi portretlar, manzaralar va turmush tarzi tasvirlarini yarating, uslubiy tahrirlash va tezkor natija olishni qo‘llab-quvvatlang.
O‘yinlar va filmlar uchun konseptual dizayn: Matn asosida qahramonlar va sahnalar konseptual rasmlarini tezda yarating, buyruqlar orqali tafsilotlarni bosqichma-bosqich o‘zgartirib, dastlabki ijodiy jarayonni tezlashtiring.
Shaxsiy fotosuratlarni tahrirlash: Suratni yuklagandan so‘ng tabiiy tildagi buyruqlar yordamida ortiqcha obyektlarni olib tashlang, osmonni almashtiring, rang ohangini sozlang va boshqa amallarni bajaring. O‘zgartirilmagan hududlarni saqlab qolgan holda murakkab foto tahrirlash dasturlarining o‘rnini bosing.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0