
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-10-30
01Nemotron 3.5 Transcribe nima
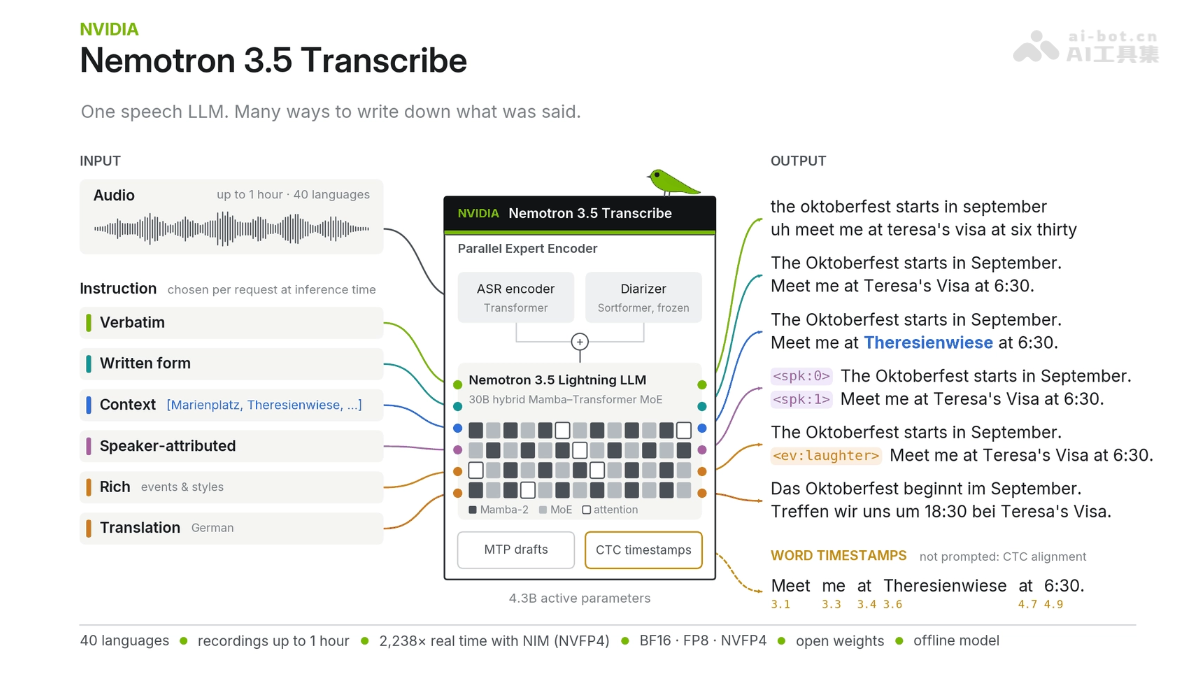
Nemotron 3.5 Transcribe — NVIDIA tomonidan ishlab chiqilgan, ochiq kodli katta nutq modeli bo‘lib, nutq kodlagichi va MoE arxitekturasidan foydalanadi, taxminan 43 milliard faol parametrga ega, 40 ta tilni qo‘llab-quvvatlaydi, davomiyligi 1 soatgacha bo‘lgan va 8 nafargacha kishi so‘zlashadigan audio yozuvlarni qayta ishlay oladi. U so‘zma-so‘z transkripsiya, so‘zlovchilarni ajratish va tarjima kabi funksiyalarni taqdim etadi. Nemotron 3.5 Transcribe tabiiy til ko‘rsatmalari orqali chiqish formatini moslashtirishni, nozik sozlash yordamida professional sohalarga moslashishni qo‘llab-quvvatlaydi va tijoriy foydalanish uchun bepul.
02Nemotron 3.5 Transcribe’ning asosiy funksiyalari
Ko‘p tilli transkripsiya: 40 ta tilni qo‘llab-quvvatlaydi, audio yozuvlarni matnga aylantiradi va og‘zaki nutqda ishlatilgan tilni aniqlay oladi.
So‘zlovchilarni ajratish: 8 nafargacha so‘zlovchini farqlay oladi va har bir jumlani tegishli so‘zlovchiga biriktiradi; yig‘ilishlar va ko‘p kishilik intervyular uchun mos.
Uzun audio yozuvlarni qayta ishlash: bir martada davomiyligi taxminan 1 soatgacha bo‘lgan yozuvlarni qayta ishlay oladi.
Ko‘rsatma asosida transkripsiya: tabiiy til orqali chiqish formatini belgilang — so‘zma-so‘z matn, tahrirlangan yozuv, og‘zaki to‘ldiruvchi so‘zlarni tozalash, terminlarni belgilash va boshqalar. Qayta o‘qitish talab qilinmaydi.
Nutq tarjimasi: 31 ta til va ingliz tili o‘rtasida tarjima qila oladi.
So‘z darajasidagi vaqt belgilari: har bir so‘zga mos audio vaqt nuqtasini qaytaradi, bu qayta tinglash va qidirishni osonlashtiradi.
Soha bo‘yicha nozik sozlash: NeMo Speech vositalar to‘plami asosida bitta GPU’da oz miqdordagi ma’lumot bilan professional sohaga tez moslashish mumkin.
03Nemotron 3.5 Transcribe’ning texnik prinsipi
WeChat’da kuzatib boring va “开源” deb javob yuborib, AI ochiq kodli loyihalar guruhiga qo‘shiling
Speech-Augmented Language Model (SALM): model uch qismdan iborat. Transformer nutq kodlagichi audio xususiyatlarini ajratib oladi, muzlatilgan Nemotron 3 so‘zlovchilarni ajratish modeli so‘zlovchilar faolligi haqidagi ma’lumotni taqdim etadi, ikkalasi esa birgalikda Nemotron 3.5 Lightning 30B-A3B gibrid Mamba-Transformer MoE katta til modeliga ulanadi. Jami parametrlar soni taxminan 340 milliard, biroq har bir inferensiya jarayonida atigi taxminan 43 milliard parametr faollashadi, bu imkoniyat va samaradorlikni muvozanatlashtiradi.
Parallel ekspert kodlagichi: frozen ajratish modeli chiqargan so‘zlovchilar faolligi signali ASR kodlagichining tasvirlariga kiritiladi. Shu sababli model yagona LLM arxitekturasi doirasida o‘zgartirishsiz so‘zlovchi belgilari bilan transkripsiya bajara oladi va ketma-ket chiqish usulida o‘qitiladi.
Nazorat qilinadigan muvozanatli aralashtirish: o‘qitish ma’lumotlari namunalar soni bo‘yicha emas, javob tokenlari soni bo‘yicha tanlanadi. Har bir ASR namunasi bir nechta topshiriq ko‘rsatmalari bilan ishlatilishi mumkin, shuning uchun yangi qobiliyatlarni tanlash ulushi 1% dan kam bo‘lsa ham qo‘shish mumkin. Butun o‘qitish jarayoni nazorat ostida nozik sozlash va qisqa mustahkamlovchi o‘qitish bosqichlaridan iborat; ikkinchisi transkripsiya aniqligini bevosita optimallashtiradi.
MTP spekulyativ dekodlashi: model o‘qitish vaqtida ko‘p tokenli bashorat (MTP) maqsadi bilan birgalikda optimallashtiriladi. Shu sababli uning MTP qatlami vLLM spekulyativ dekodlashi uchun bevosita qoralama model vazifasini bajara oladi; qo‘shimcha ravishda DFlash2 qoralama modeli ham taqdim etiladi. Ularning birgalikdagi ishlashi bitta RTX PRO 6000 Blackwell GPU’da soniyasiga 2238 soniyalik audio transkripsiya o‘tkazuvchanligiga erishadi.
CTC vaqt belgisi adapteri: dekodlashdan so‘ng yengil CTC adapteri yordamida hosil qilingan matn audio bilan moslashtiriladi. Bu uzun audio va kuchli ustma-ust nutq uchun so‘zlovchi belgilari mavjud so‘z darajasidagi vaqt belgilarini hosil qiladi va asosiy modelga qo‘shimcha yuk bermaydi.
04Nemotron 3.5 Transcribe’dan qanday foydalanish kerak
Uskunani tayyorlash: BF16 versiyasi uchun taxminan 80GB video xotira kerak; talabni kamaytirish uchun FP8/NVFP4 yoki GGUF versiyasidan foydalanish mumkin.
Modelni olish: Hugging Face yoki ModelScope’dan NVIDIA-Nemotron-3.5-Transcribe-30B-A4B modelini qidiring va vaznlarni OpenMDW-1.1 litsenziyasi asosida yuklab oling.
Muhitni o‘rnatish: uchta joylashtirish usulidan birini tanlang: Nemotron Transcribe NIM (rasmiy konteyner), vLLM (MTP tezlatishini qo‘llab-quvvatlaydi) yoki NeMo-Speech.cpp (GGUF’ni lokal ishga tushirish).
Audioni tayyorlash: davomiyligi 1 soatgacha bo‘lgan audio faylni yuklang va uni foydalanilayotgan freymvork talablariga muvofiq formatga o‘tkazing.
Prompt yozish: vazifani tabiiy tilda tushuntiring, masalan, ”so‘zma-so‘z nutqni saqlab, so‘zlovchilarni belgilang” ”og‘zaki to‘ldiruvchi so‘zlarni tozalab, ingliz tiliga tarjima qiling”.
Inferensiyani ishga tushirish: audio va promptni interfeysga yuboring. Model transkripsiya matnini, zarur bo‘lsa, so‘zlovchi teglari va so‘z darajasidagi vaqt belgilari bilan qaytaradi.
(Ixtiyoriy) Tezkor sinov: joylashtirishni istamasangiz, avval Hugging Face’dagi nvidia/nemotron-transcribe sinov maydonida onlayn foydalanib ko‘ring.
(Ixtiyoriy) Soha bo‘yicha nozik sozlash: NeMo Speech vositalar to‘plami yordamida belgilangan ma’lumotlarni tayyorlang; bitta GPU’da taxminan 0.5–2.3 soat ichida o‘z aksentingiz, terminlaringiz va formatlaringizga moslashtirish mumkin.
05Nemotron 3.5 Transcribe’ning asosiy afzalliklari
Ko‘rsatma asosida chiqish: bitta tabiiy til jumlasi orqali so‘zma-so‘z matn, tahrirlangan matn, tarjima kabi turli formatlarga o‘tish mumkin; qayta o‘qitish yoki bir nechta modelni sozlash talab qilinmaydi.
Yuqori transkripsiya aniqligi: ingliz tilidagi Open ASR reytingida o‘rtacha WER atigi 4.71%, ko‘p tilli reytingda esa 4.62% bo‘lib, ikkalasida ham ochiq vaznli modellar orasida birinchi o‘rinda turadi.
Yetakchi so‘zlovchi ajratish: ustma-ust keladigan ko‘p kishilik nutqni belgilab transkripsiya qilish vazifalarida ilk bor maxsus kaskad tizimlardan o‘zib ketadi va 1 soatgacha davom etadigan, 8 kishilik sahnalarni qo‘llab-quvvatlaydi.
Kontekst asosida xatolarni tuzatish kuchli: terminlar va ismlar kabi obyektlar ro‘yxati berilganda, nomlangan obyektlar xatolik darajasi 6 baravargacha kamayadi, professional so‘zlarni endi taxmin qilish shart emas.
So‘zlovchi belgilari bilan so‘z darajasidagi vaqt belgilari: yengil CTC moslashtirishi transkripsiya natijasini qayta tinglash va qidirish imkonini beradi, bu darslarni qayta ko‘rish va yig‘ilishlar bo‘yicha qidiruv kabi ilovalarni bevosita qo‘llab-quvvatlaydi.
Inferensiya samaradorligi yuqori: mahalliy MTP spekulyativ dekodlashi va DFlash2 qoralama modeli yordamida bitta RTX PRO 6000 soniyasiga 2238 soniyalik audioni qayta ishlay oladi.
06Nemotron 3.5 Transcribe loyihasi manzillari
HuggingFace model kutubxonasi: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
Texnik maqola: https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
07Nemotron 3.5 Transcribe’ning qo‘llanish sohalari
Yig‘ilish bayonnomasi va qarorlarni ajratib olish: so‘zlovchilarni avtomatik ajratadi, muhokamadagi asl jumlalarni saqlaydi hamda ko‘rsatmalar asosida yig‘ilish xulosalari va bajarilishi kerak bo‘lgan vazifalarni ajratib oladi.
Media intervyulari va yangiliklar tahririyati: suhbatdoshning asl so‘zlarini so‘zma-so‘z saqlaydi va so‘zlovchini belgilaydi, iqtiboslarning aniqligini ta’minlaydi hamda kerak bo‘lsa og‘zaki to‘ldiruvchi so‘zlarni tozalaydi.
Dars va treninglarni qayta ko‘rish: so‘z darajasidagi vaqt belgilari mavjud transkripsiya yaratadi, o‘quvchilar kalit so‘zlarni qidirib, o‘qituvchi tegishli bilimni tushuntirgan vaqtga bevosita o‘tishlari mumkin.
Tibbiyot va professional sohalardagi qaydlar: terminlar ro‘yxati va soha bo‘yicha nozik sozlashdan foydalanib, shifokor va bemor suhbatlarini standart formatda tibbiy karta matniga aylantiradi va professional atamalar xatoliklarini kamaytiradi.
Ko‘p tilli kontentni lokalizatsiya qilish: 40 ta tildagi audio yozuvlarni bevosita inglizcha matnga tarjima qiladi; xalqaro yig‘ilishlar, intervyular yoki video subtitrlari tayyorlash uchun mos.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0