

WeMM-Embedding nima?
WeMM-Embedding — WeChat Vision jamoasi tomonidan ishlab chiqilgan universal multimodal embedding modellar oilasi. U matn, tasvirlar, videolar, vizual hujjatlar va aralash multimodal kiritmalarni yagona vektor ko‘rinishlariga aylantiradi. Ushbu vektorlar turli modalliklardagi kontentni ifodalash va taqqoslashni talab qiladigan jarayonlarni qo‘llab-quvvatlashi mumkin.
Har bir model embeddingni maxsus <embedding> tokeni joylashgan oxirgi qatlamdagi yashirin holatdan oladi va keyin L2 normallashtirishni qo‘llaydi. Hozircha audio kiritmasi qo‘llab-quvvatlanmaydi.
Asosiy xususiyatlar
- Yagona multimodal ko‘rinishlar: Bir xil modellar oilasi matn, tasvirlar, videolar, vizual hujjatlar va aralash kiritmalarni qayta ishlaydi.
- Bir nechta model o‘lchamlari: 2B, 4B va 9B parametrli variantlardan birini tanlang.
- Matryoshka Representation Learning: Saqlash yoki qidiruv samaradorligi muhim bo‘lganda, qo‘llab-quvvatlanadigan qisqaroq vektor o‘lchamlaridan foydalaning.
- Ikki xil inference interfeysi: Transformers va Sentence Transformers uchun misollar taqdim etilgan.
- Production serving: Repozitoriy vLLM va SGLang uchun konfiguratsiyalar hamda wrapper skriptlarini o‘z ichiga oladi.
- Baholash vositalari: Kiritilgan MMEB-v3 pipeline bir tugunli va ko‘p tugunli inferenceni qo‘llab-quvvatlaydi.
Model va o‘lchamni tanlash
Model zoo Hugging Face platformasida uchta variantni o‘z ichiga oladi. Mavjud hisoblash resurslaringiz va talab qilinadigan to‘liq embedding o‘lchamiga qarab model tanlang.
- WeMM-Embedding-2B: 64, 128, 256, 512, 1024 va 2048 o‘lchamlarini qo‘llab-quvvatlaydi.
- WeMM-Embedding-4B: 64, 128, 256, 512, 1024 va 2560 o‘lchamlarini qo‘llab-quvvatlaydi.
- WeMM-Embedding-9B: 64, 128, 256, 512, 1024, 2048 va 4096 o‘lchamlarini qo‘llab-quvvatlaydi.
Qo‘llab-quvvatlanadigan kichikroq o‘lcham vektorlarni saqlash va keyingi hisoblashlarni kamaytiradi. Masalan, README ma’lumotlariga ko‘ra, 256 o‘lchamdagi 2B model MMEB-v2 da to‘liq o‘lchamli tasvir va video unumdorligining 98.7 foizini saqlab qoladi.
O‘rnatish va sozlash
1. Repozitoriy va modelni oling
Repozitoriyning mahalliy nusxasidan foydalaning, so‘ngra Hugging Face sahifasidan modelni yuklab oling yoki qo‘llab-quvvatlanganda tegishli misolni Hugging Face model identifikatoridan foydalanishga sozlang.
2. Bog‘liqliklarni o‘rnating
Loyiha e’lon qilgan versiyalarni o‘rnating:
pip install -r requirements.txt3. Transformers versiyasini belgilang
Loyiha inference va qayta tiklanadigan natijalar uchun transformers==5.2.0 versiyasini tavsiya qiladi, chunki yangiroq relizlarda preprocessing xatti-harakati farq qilishi mumkin.
pip install transformers==5.2.0Misollarni ishga tushirishdan oldin modelingiz, sinov tasviringiz va sinov videongiz yo‘llarini tayyorlang.
Transformers bilan asosiy foydalanish
Transformers misoli matn, tasvir va video kiritmalari uchun mustaqil embeddinglar hosil qiladi. Uni mahalliy model yo‘li va qo‘llab-quvvatlanadigan chiqish o‘lchami bilan ishga tushiring:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
O‘rnini bosuvchi yo‘llarni tizimingizdagi fayllar yo‘llari bilan almashtiring. 2B modeli uchun 2048 to‘liq vektor o‘lchamidir. Modelning to‘liq embedding o‘lchamini alohida ko‘rsatmasdan so‘rash uchun --dimension parametrini olib tashlang:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Sentence Transformers bilan asosiy foydalanish
Sentence Transformers misoli matn, tasvir va video kiritmalarini SentenceTransformer.encode() orqali yo‘naltiradi. U --dimension orqali Matryoshka o‘lchamini tanlashni ham qo‘llab-quvvatlaydi.
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
SentenceTransformer modelni bevosita yuklay olgani sababli, mahalliy yo‘lni Hugging Face model identifikatori bilan almashtirishingiz mumkin:
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Matryoshka embeddinglaridan to‘g‘ri foydalanish
Matryoshka embeddinglar to‘liq vektorni tanlangan model qo‘llab-quvvatlaydigan o‘lchamlardan birigacha qisqartirish imkonini beradi. Yakuniy o‘qni qisqartiring, so‘ng qisqartirilgan vektorni yana normallashtiring:
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)
d qiymatini faqat modelingiz uchun ro‘yxatda ko‘rsatilgan o‘lchamga o‘rnating. Qisqartirish vektor normasini o‘zgartirgani sababli, ikkinchi normallashtirish bosqichi muhim. Taqdim etilgan buyruq satri misollaridan foydalanganda, kerakli Matryoshka o‘lchamini --dimension orqali tanlang.
Modelni vLLM bilan xizmatga chiqarish
Repozitoriy vLLM 0.27.0 bilan sinovdan o‘tkazilgan. Pooling serverini ishga tushiring va modelning embedding chat shablonini ko‘rsating:
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
Tegishli wrapper scripts/serve_vllm.sh manzilida mavjud.
Modelni SGLang bilan xizmatga chiqarish
SGLang 0.5.9 loyiha hujjatlarida ko‘rsatilgan sinovdan o‘tgan versiyadir. Embedding serverini ishga tushirishdan oldin taqdim etilgan video patchni qo‘llang:
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
Shuningdek, repozitoriy bir buyruq bilan ishga tushirish uchun scripts/serve_sglang.sh skriptini taqdim etadi.
MMEB-v3 baholashini ishga tushirish
mmeb_v3_eval/ katalogida xabar qilingan MMEB-v3 natijalari uchun foydalanilgan baholash kodi mavjud. U rasmiy VLM2Vec pipeline'iga asoslangan bo‘lib, WeMM-Embedding backbone'i, moslashtirilgan dataset ko‘rsatmalari, paketlangan inferens, bir nechta tugun va GPU'da bajarish hamda videodan 64 ta kadr namunasini olish imkoniyatlarini qo‘shadi.
Avval baholash katalogiga o‘ting va ma’lumotlarni yuklab oling:
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
Keyin modelingiz, dataset va chiqish yo‘llari bilan baholashni ishga tushiring:
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
Hujjatlashtirilgan ma’lumotlarni sozlash hamda bitta yoki bir nechta tugun uchun buyruqlar bilan tanishish uchun mmeb_v3_eval/README.md fayliga murojaat qiling.
Ilg‘or maslahatlar
- O‘lchamlarni modelga moslang: 2B modelidan 2560 o‘lcham yoki 4B modelidan 4096 o‘lcham so‘ramang. Faqat tanlangan checkpoint uchun ko‘rsatilgan o‘lchamlardan foydalaning.
- Qisqartirilgan vektorlarni qayta normallashtiring: To‘liq embeddingni qo‘lda qisqartirsangiz, keyin har doim L2 normallashtirishni qo‘llang.
- Oldindan ishlov berishni takrorlanuvchan saqlang: Natijalarni qayta ishlab chiqarishda tavsiya etilgan Transformers versiyasidan foydalaning, chunki oldindan ishlov berish versiyalar orasida o‘zgarishi mumkin.
- Tegishli yuklash usulidan foydalaning: Hujjatlashtirilgan Transformers buyrug‘ida model yo‘li ishlatiladi, Sentence Transformers misolida esa
tencent/WeMM-Embedding-2Bni bevosita yuklash ham mumkin. - Qo‘llab-quvvatlanmaydigan audioni hisobga oling: Modellar hozircha audioni qabul qilmaydi, shu sababli xabar qilingan MMEB-v3 audio bali nolga teng.
- Qulaylik uchun serving wrapper'laridan foydalaning:
scripts/katalogidagi shell skriptlar hujjatlashtirilgan vLLM va SGLang ishga tushirish konfiguratsiyalarini birlashtiradi.
Unumdorlik konteksti
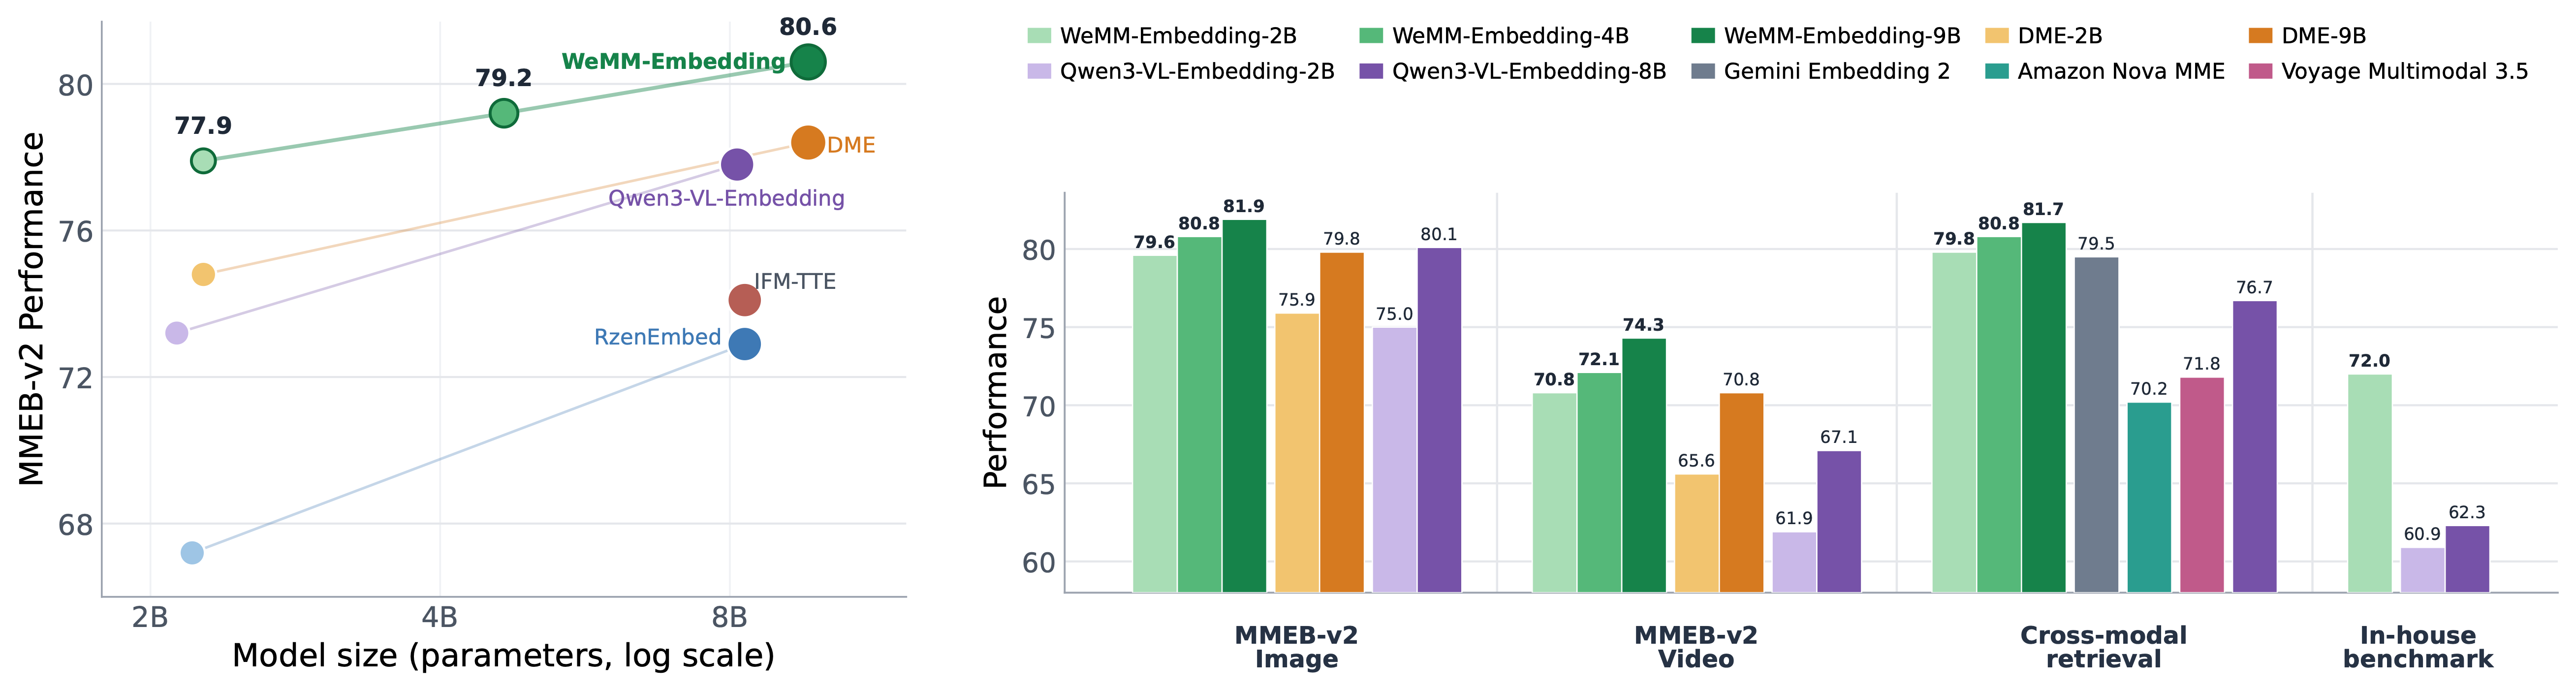
README 78 ta MMEB-v2 dataset va barcha 190 ta MMEB-v3 topshirig‘i bo‘yicha natijalarni keltiradi. MMEB-v2 uchun 2B, 4B va 9B variantlarining o‘rtacha ballari mos ravishda 77.9, 79.2 va 80.6. MMEB-v3 uchun ularning xabar qilingan umumiy ballari 56.0, 58.2 va 59.5. Metrikalar topshiriq guruhiga qarab farqlanadi: rasm va video topshiriqlarida Hit@1, vizual hujjat va matn topshiriqlarida NDCG@5, agent, MCMR va audio topshiriqlarida esa Hit@1 ishlatiladi.
Benchmark ballari hujjatlashtirilgan topshiriq qamrovini hisobga olgan holda talqin qilinishi kerak. MMEB-v3 qo‘llab-quvvatlanmaydigan topshiriqlarga, jumladan WeMM-Embedding uchun audioga, nol ball beradi.
Xulosa
WeMM-Embedding bir nechta vizual va matnli kirish turlaridan normallashtirilgan tasvirlarni yaratish uchun yagona model oilasini taqdim etadi. 2B checkpoint va taqdim etilgan inferens misolidan boshlang, ixcham vektorlar foydali bo‘lganda qo‘llab-quvvatlanadigan Matryoshka o‘lchamini tanlang, serving yoki baholash kerak bo‘lganda esa vLLM, SGLang yoki MMEB-v3 pipeline'iga o‘ting. Aks holda ko‘rsatilmagan bo‘lsa, Tencent tomonidan yozilgan repozitoriy kodi Apache License 2.0 ostida chiqarilgan.