

DeepInfer-SM80 nima?
DeepInfer-SM80 — vLLM V1 mexanizmi orqali NVIDIA Ampere GPU'larida DeepSeek-V4.1 ni ishga tushirish uchun optimallashtirilgan Python, Triton va TileLang modullari to'plamidir. U NVIDIA Blackwell uchun mo'ljallangan DeepSeek'ning DeepInfer loyihasidagi asosiy g'oyalarni ko'chiradi va muhim bajarilish yo'lini Ampere qurilmalarining imkoniyatlariga moslab qayta ishlab chiqadi.
Blackwell'ga xos tcgen05 warp-guruh ko'rsatmalari, Tensor Memory, apparat UE8M0 masshtablash ko'rsatmalari va har bir streaming multiprocessor uchun 228 KB umumiy xotira kabi funksiyalarga tayanish o'rniga, loyiha Ampere'ning mma.sync.aligned.m16n8k16 Tensor Core'lari, SM'ni hisobga oluvchi rejalashtirish, butun sonli bit siljitish orqali UE8M0 dekodlash va YOCO umumiy KV qayta foydalanish imkoniyatlaridan foydalanadi.
Loyiha A100 va A800 kabi ma'lumotlar markazlari uchun mo'ljallangan SM80 GPU'larini, shuningdek RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 va A30 kabi SM86 qurilmalarini qo'llab-quvvatlaydi. Uning yadrolari har bir CTA uchun 48 KB dan ko'p bo'lmagan umumiy xotiradan foydalanadi, shu sababli SM86 qurilmalaridagi kichikroq umumiy xotira cheklovlari doirasida ishlay oladi.
Nima uchun undan foydalanish kerak?
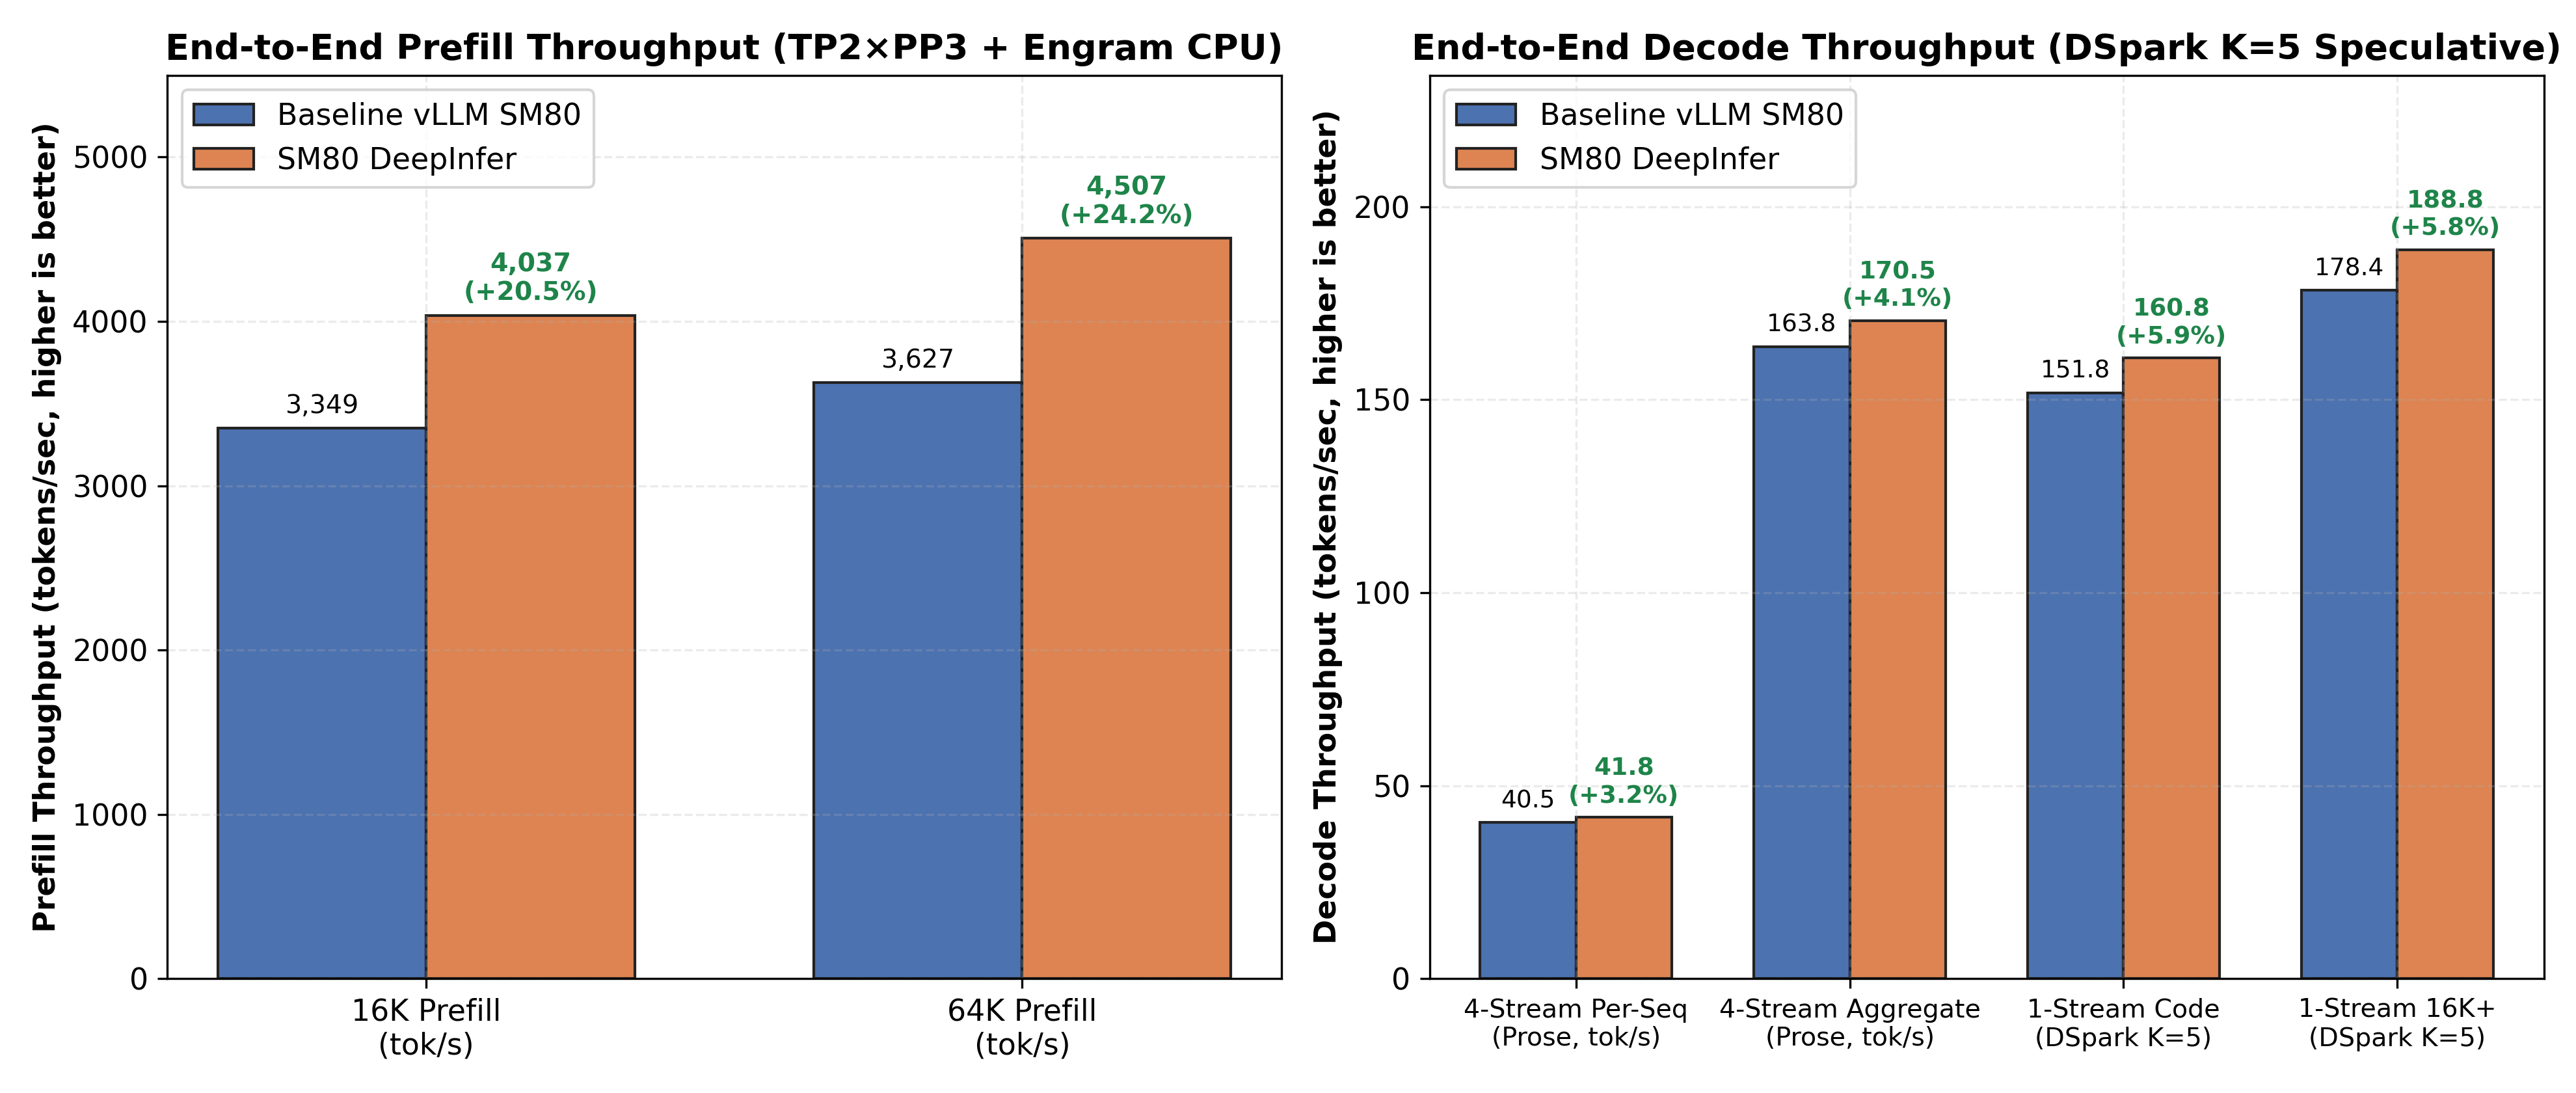
DeepInfer-SM80 DeepSeek-V4.1 prefill, siyrak attention, KV-keshga kirish, residual yo'naltirish va uzun kontekstli inference jarayonlaridagi qimmat amallarga e'tibor qaratadi. Repozitoriy oltita GA100 64 GB GPU, TP2 × PP3, K=5 bilan DSpark spekulyativ dekodlashi va 1,048,576 tokenlik maksimal kontekst uzunligidan foydalanadigan ishlab chiqarish konfiguratsiyasida quyidagi natijalarni qayd etadi:
- 16K sovuq prefill: soniyasiga 4,037.0 token, avvalgi 3,349.4 token o'rniga.
- 64K sovuq prefill: soniyasiga 4,506.8 token, avvalgi 3,627.3 token o'rniga.
- 64K birinchi tokengacha bo'lgan vaqt: 10.7 soniya, avvalgi 13.2 soniyaga nisbatan kam.
- To'rtta oqimli spekulyativ dekodlash: jami soniyasiga 170.5 token, avvalgi 163.8 token bilan taqqoslaganda.
- Bitta oqimli Python-kod dekodlashi: soniyasiga 160.8 token, avvalgi 151.8 token bilan taqqoslaganda.
- GPU'da joylashgan KV sig'imi: 4,648,480 token, bazaviy konfiguratsiyaga nisbatan qo'shimcha VRAM sarfisiz.
Ushbu o'lchovlar repozitoriyning sinovdan o'tkazilgan apparat va xizmat ko'rsatish konfiguratsiyasini ifodalaydi. Boshqa Ampere GPU'lari, model konfiguratsiyalari, yuklamalar yoki vLLM muhitlaridagi natijalar farq qilishi mumkin.
Asosiy optimallashtirishlar
Yagona 512 o'lchamli siyrak MLA
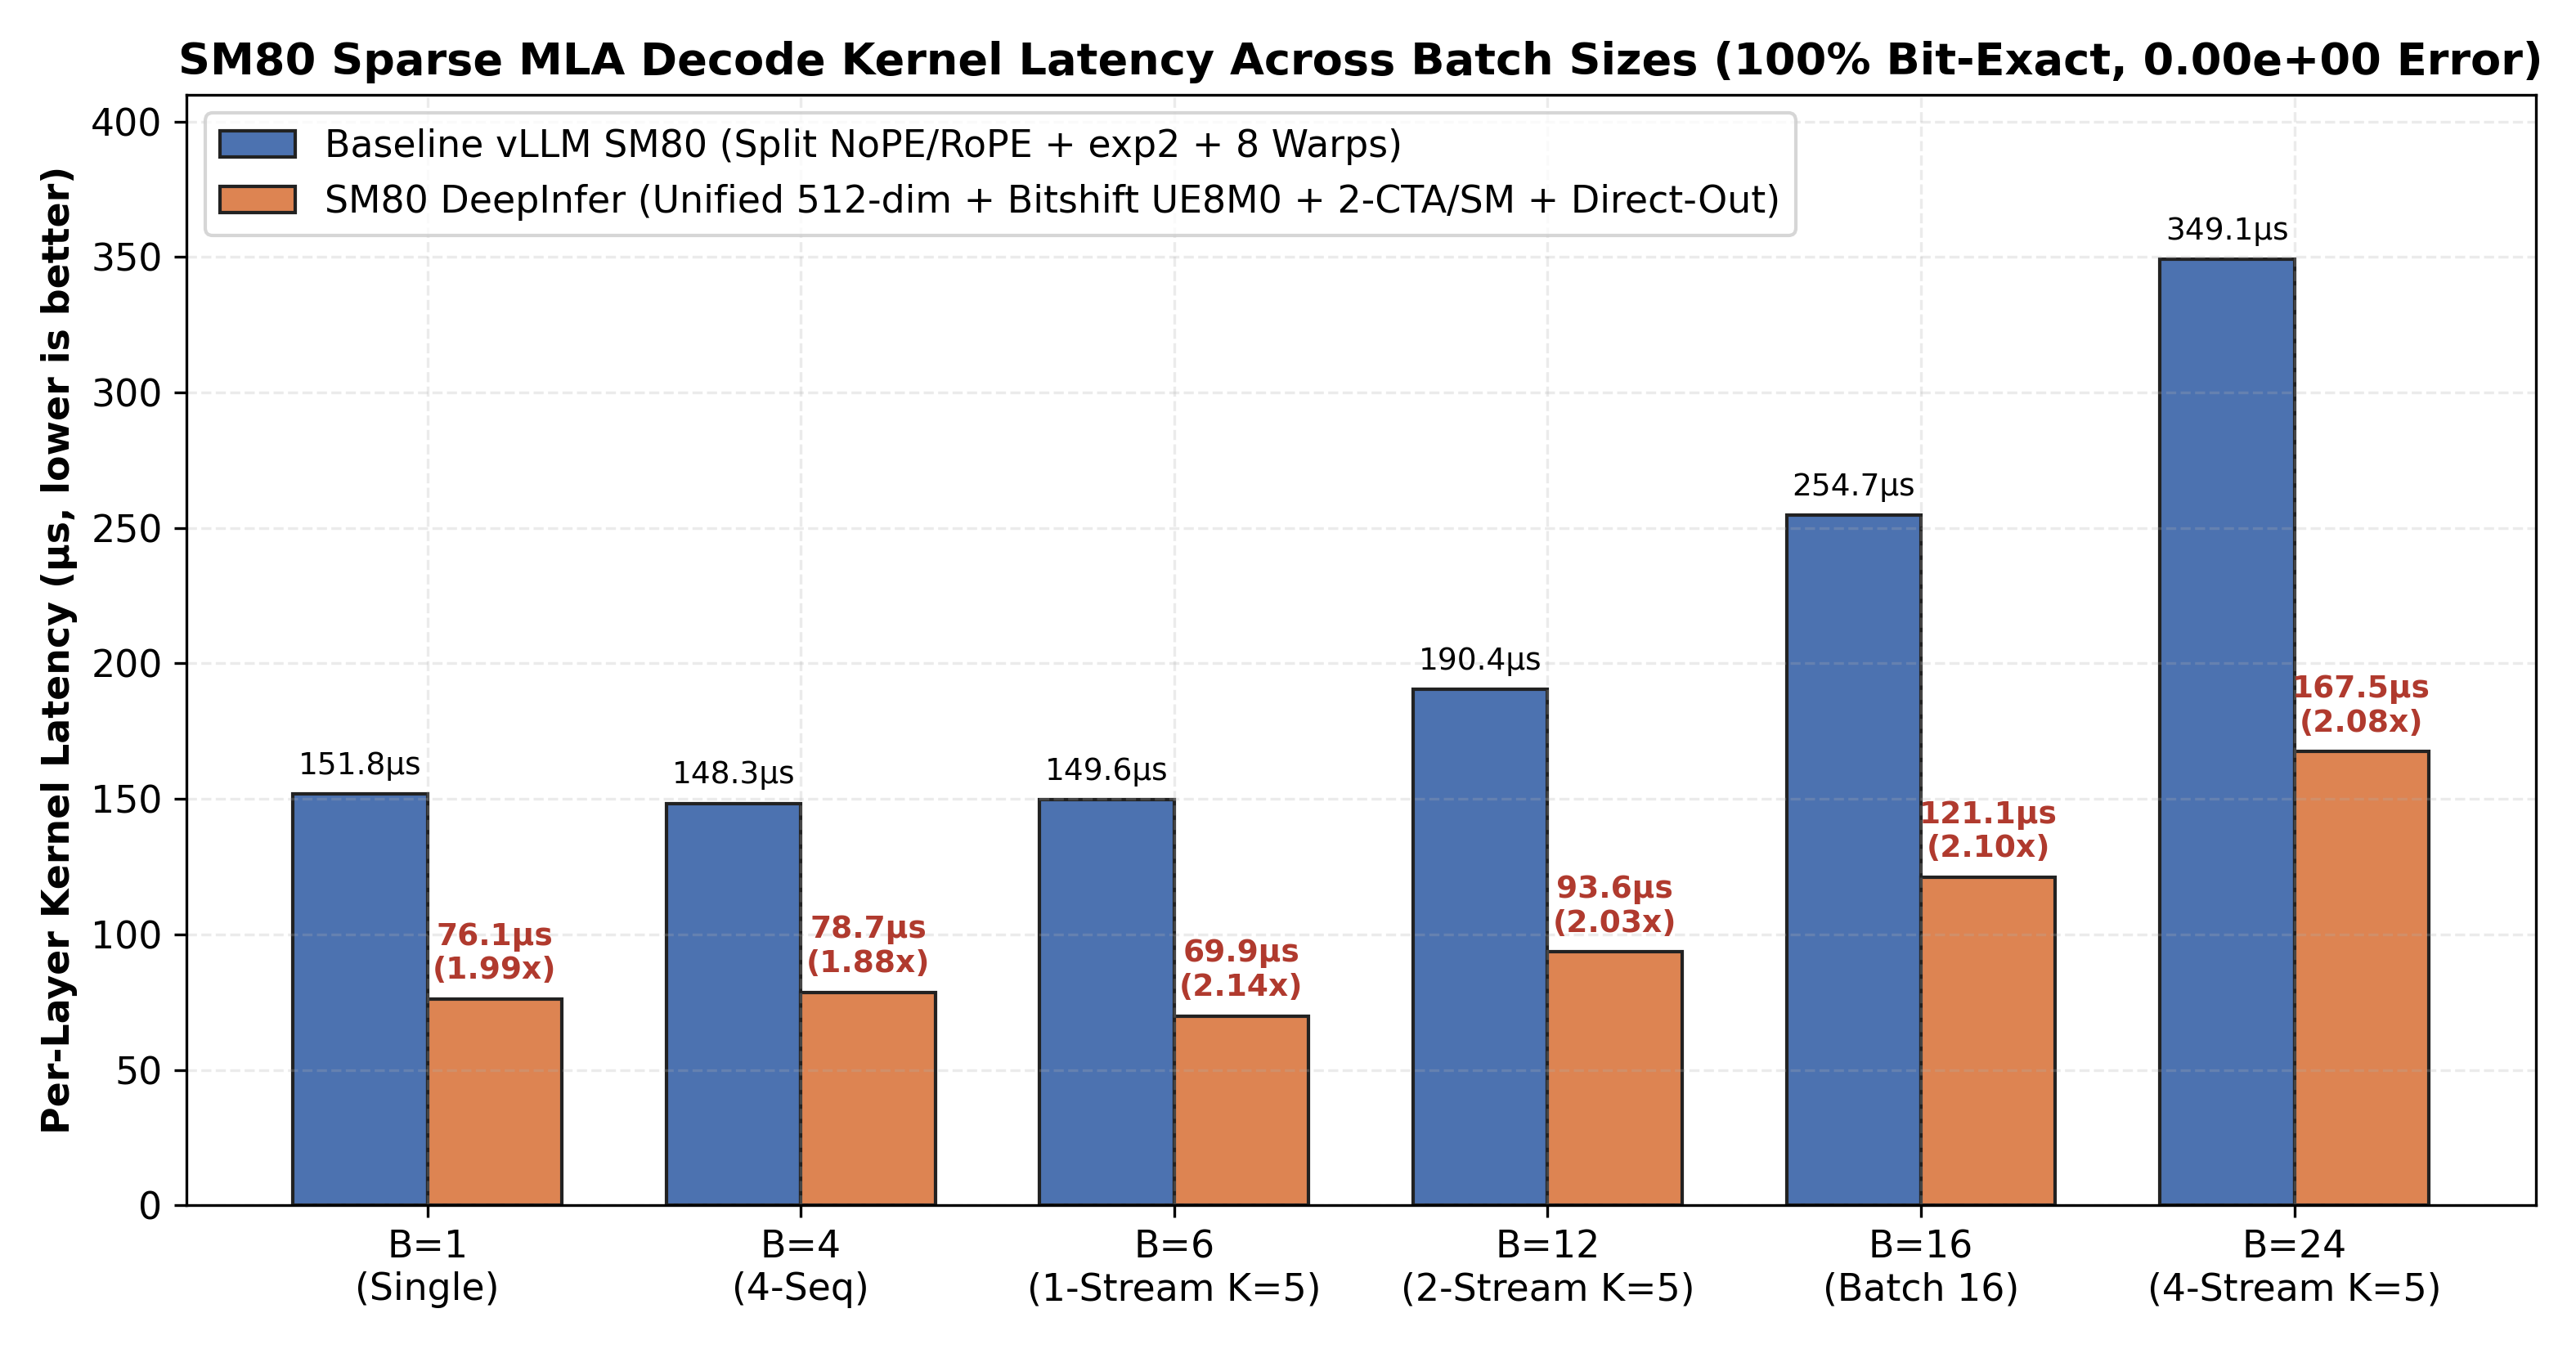
DeepSeek-V4.1'ning DeepSelect siyrak attention mexanizmi 448 o'lchamli NoPE latentini float8_e4m3fn formatida, UE8M0 ikki darajali blok masshtablari bilan, shuningdek 64 o'lchamli BF16 RoPE qo'shimchasi bilan saqlaydi. DeepInfer-SM80 to'liq 512 o'lchamli tile'ni yuklaydi va NoPE hamda RoPE qismlarini alohida qayta ishlash o'rniga, ularni yagona Tensor Core dot-product yo'li orqali qayta ishlaydi.
Yadro exp2 asosidagi UE8M0 konversiyasini IEEE-754 butun sonli bit siljitish bilan almashtiradi:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)Yaroqli UE8M0 eksponentlari uchun bu usul bitlar darajasida aynan bir xil FP32 masshtab qiymatlarini hosil qiladi va ishni transsendent amallardan butun sonlar konveyeriga ko'chiradi.
Sozlangan konfiguratsiya BLOCK_N=64, num_warps=4 va num_stages=2 qiymatlaridan foydalanadi. Registrlar yuklamasini kamaytirish har bir SM80 streaming multiprocessorida ikkita CTA joylashishiga imkon beradi. num_kv_splits == 1 bo'lganda, yadro to'g'ridan-to'g'ri yakuniy chiqishga yozadi va alohida reduction bosqichini ishga tushirishdan qochadi.
Yagona CTA orqali Top-K va SWA indekslarini birlashtirish
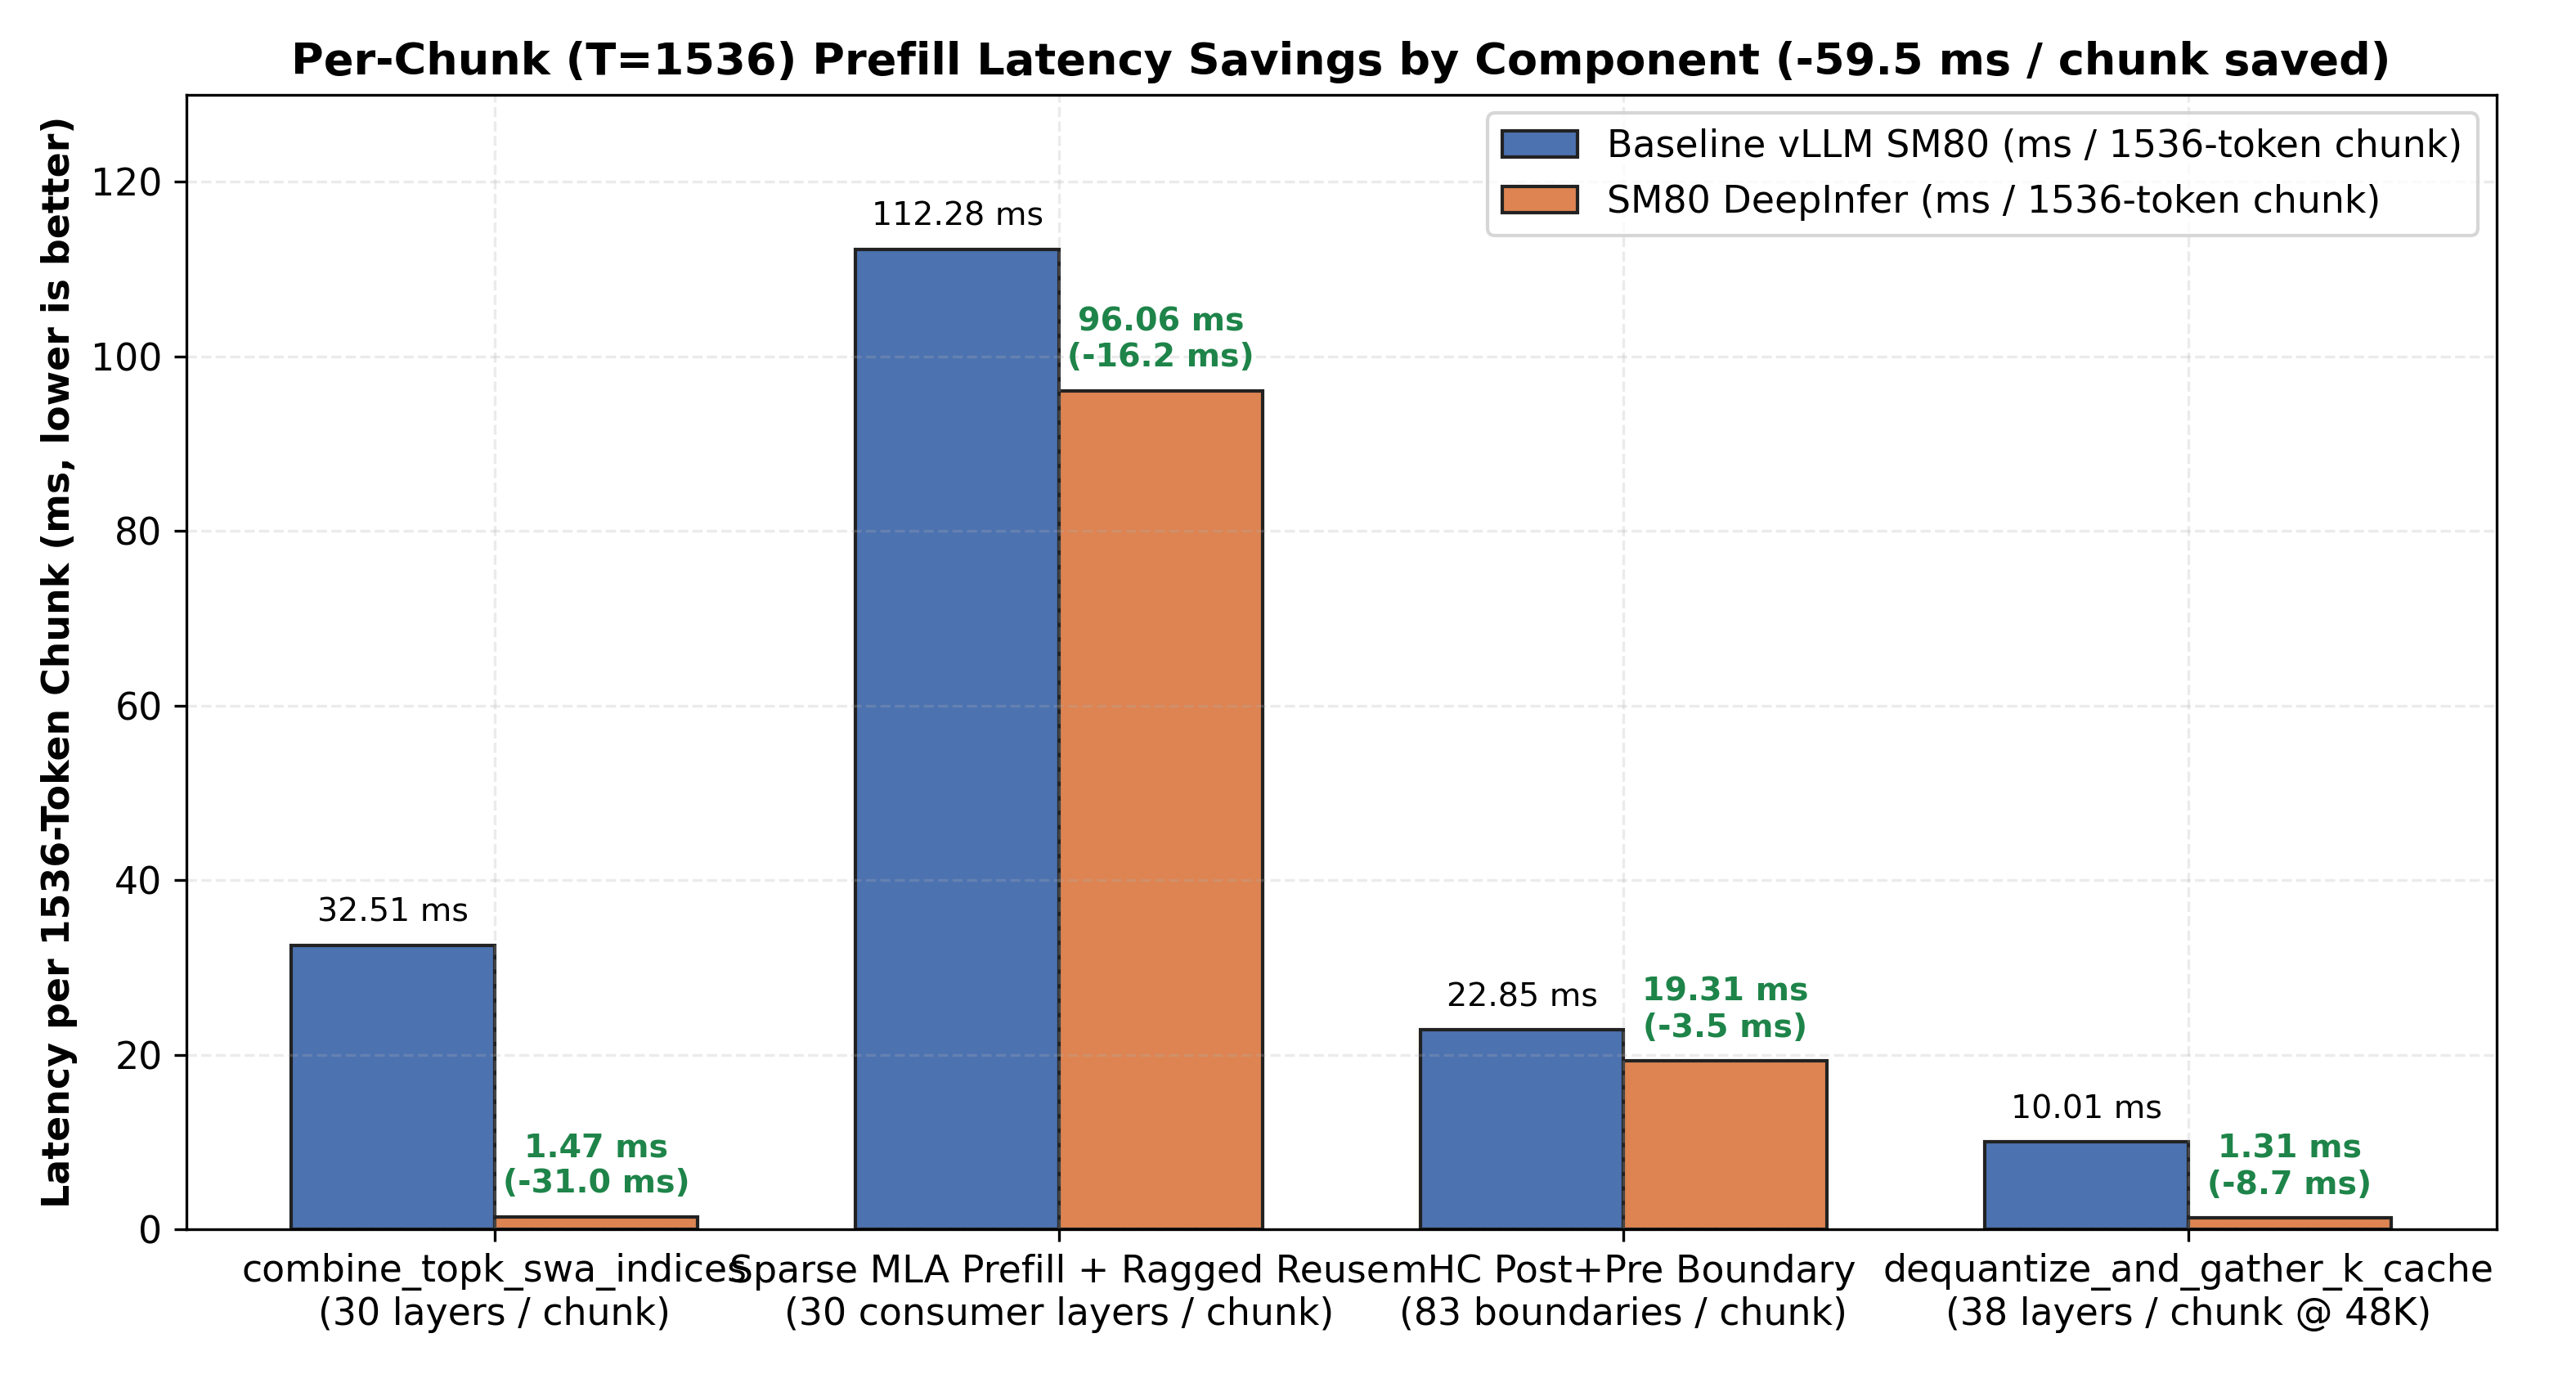
Optimallashtirilgan _combine_topk_swa_indices_kernel PyTorch ajratmalari va amallari ketma-ketligini har bir so'rov tokeni uchun bittadan CTA ishlatadigan yagona Triton yadrosi bilan almashtiradi. T=1536 holatida o'lchangan kechikish 1,083.72 mikrosoniyadan 48.88 mikrosoniyagacha kamayadi, bu 22.17× tezlashuvdir.
Warp'lararo yozish to'qnashuvlarining oldini olish uchun har bir chiqish qatori uchta bir-biridan ajratilgan sohaga bo'linadi:
- Siqilgan Top-K indekslari
[0, topk_len)oralig'ini egallaydi. - Siljuvchi oyna attention indekslari
[topk_len, topk_len + swa_len)oralig'ini egallaydi. - Qolgan ustunlar
-1bilan to'ldiriladi.
README sinovdan o'tkazilgan barcha ketma-ketlik uzunliklari va 0, 1 hamda 2 siqish koeffitsiyentlarida bitlar darajasida aynan bir xil chiqish olinganini qayd etadi.
Tezlashtirilgan KV-kesh dekvalifikatsiyasi va yig'ish
dequantize_and_gather_k_cache yo'li xuddi shu bit siljitishga asoslangan UE8M0 konversiyasidan foydalanadi. Shuningdek, u Triton yadrosiga berilgan maqsad stride'lari orqali yozadi, shu tariqa oraliq torch.empty ajratmalari va undan keyingi .copy_() amallarini yo'q qiladi.
O'lchangan tezlashuv 16K kontekstda 4.02×, 48K kontekstda esa 7.64× ni tashkil etadi; qayd etilgan sinovlarda referens natijalar bilan bitlar darajasida aynan mos kelgan.
SM80 uchun sozlangan mHC residual yo'naltirish
DeepSeek-V4.1 har bir forward pass davomida 83 ta chegarada to'rt oqimli, manifold bilan cheklangan hyper-connection yo'naltirishini amalga oshiradi. DeepInfer-SM80 modelning 5,120 o'lchamli yashirin qatlami uchun moslashtirilgan (6, 8, 128) bo'linish geometriyasini qo'shadi. Sakkizta bo'lakning har biri 640 ta elementdan iborat bo'lib, bu son 128 ga bo'linadi.
Loyiha, shuningdek, kichik matritsa chegarasini 32 dan 16 gacha pasaytiradi, natijada kamida 16 ta token bo'lgan holatlarda Tensor Core T.gemm yo'lidan foydalanish mumkin. Qayd etilgan mhc_fused_post_pre_delayed tezlashuvi T=12 da 2.89×, T=6 da esa 1.30× ni tashkil etadi.
YOCO metama'lumotlarini qayta ishlatish
DeepSeek-V4.1’ning You-Only-Cache-Once arxitekturasida 21-dan 39-gacha bo‘lgan qatlamlar 20-qatlamning to‘liq aniqlikdagi KV keshidan o‘qiydi. Bu iste’molchilar bir xil kengaytirilgan ketma-ketlik uzunliklari, bloklar jadvali va siqish koeffitsientidan foydalanadi.
DeepInfer-SM80 20-qatlamni qayta ishlashda notekis K metama’lumotlarini vLLM forward kontekstida saqlaydi. Ushbu ma’lumotlarni 21-dan 39-gacha bo‘lgan qatlamlarda qayta ishlatish har bir prefill bo‘lagi uchun 19 ta ortiqcha metama’lumot yaratish GPU yadrolari zanjirini bekor qiladi.
O‘rnatishdan oldin
Sizga DeepSeek-V4.1’ni qo‘llab-quvvatlanadigan NVIDIA Ampere GPU’da ishga tushiradigan vLLM V1 muhiti kerak bo‘ladi. Repozitoriy yagona patch va oltita almashtiriladigan modulni taqdim etadi, biroq README CUDA, Python, Triton, TileLang yoki vLLM versiyalarining aniq raqamlarini belgilamaydi. Patch va mavjud DeepSeek-V4.1 deployment’ingiz bilan mos keladigan vLLM checkout’idan foydalaning.
Qo‘llab-quvvatlanadigan qurilmalar guruhlari:
- SM80 ma’lumotlar markazi GPU’lari: A100 40 GB, A100 80 GB, GA100 64 GB hamda A800 40 GB yoki 80 GB.
- SM86 ish stansiyasi va iste’molchi GPU’lari: RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 va A30.
Dasturiy ta’minot Apache License 2.0 litsenziyasi ostida tarqatiladi.
O‘rnatish varianti A: Yagona patch’ni qo‘llash
Bu usul barcha oltita o‘zgartirilgan faylni vLLM manba checkout’iga qo‘llaydi. Ushbu checkout’ning ildiz katalogida terminal ochib, quyidagini bajaring:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patch/path/to/Deepinfer-SM80 o‘rniga klonlangan yoki yuklab olingan loyiha joylashuvini kiriting. Patch sparse MLA, cache-gather, Top-K va SWA, mHC, warmup hamda YOCO metama’lumotlarini qayta ishlatishdagi o‘zgarishlarni o‘z ichiga oladi.
O‘rnatish varianti B: Almashtiriladigan modullarni o‘rnatish
Agar fayllarni bevosita almashtirish muhitingiz uchun ma’qulroq bo‘lsa, loyiha vLLM modul daraxtini o‘rnatilgan vLLM paketi ustiga ko‘chiring:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm//path/to/site-packages/vllm/ o‘rniga haqiqiy vLLM paketi katalogini kiriting. Xuddi shu fayllarni Docker deployment’ida faqat o‘qish uchun bind-mounted overlay sifatida ham ulash mumkin.
Almashtiriladigan daraxt quyidagi funksional sohalarni o‘zgartiradi:
model_executor/kernels/mhc/TileLang mHC bajarilishi va warmup uchun.models/deepseek_v4_1/amd/rocm.pyTriton Top-K va SWA birlashtiruvchisi uchun.models/deepseek_v4_1/common/ops/cache_utils.pyKV keshini yig‘ish uchun.models/deepseek_v4_1/nvidia/model.pyYOCO metama’lumotlarini qayta ishlatish uchun.v1/attention/ops/rocm_aiter_mla_sparse.pyyagona sparse MLA yadrolari uchun.
Ikki optimallashtirilgan fayl yo‘llarida
rocmyokiamdsaqlanib qolgan bo‘lsa-da, repozitoriy ulardan Ampere’ga yo‘naltirilgan vLLM integratsiyasining bir qismi sifatida aniq foydalanadi. Almashtiriladigan fayllarni qo‘llashda taqdim etilgan katalog tuzilmasini saqlang.
Asosiy foydalanish: yadrolarni tekshirish
Patch yoki almashtiriladigan modullarni o‘rnatgandan so‘ng, taqdim etilgan ajratilgan mikrobenchmark’larni maqsadli A100, A800, RTX 3090, RTX A6000 yoki boshqa qo‘llab-quvvatlanadigan Ampere GPU’da ishga tushiring:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
Benchmark fayllari sparse MLA va KV-gather yadrolari, TileLang mHC yadrolari hamda Top-K va SWA birlashtiruvchisini qamrab oladi. Ularning maqsadi mahalliy yadro kechikishini o‘lchash va optimallashtirilgan natijalarni bazaviy namunalar bilan solishtirib tekshirishdir.
Repozitoriyning benchmark grafiklarini quyidagicha yarating:
python3 benchmarks/generate_charts.pyTo‘liq benchmark ma’lumotlar to‘plami ham benchmarks/results/sm80_benchmark_summary.json manzilida mavjud.
Sonli tekshiruvni tushunish
Bir nechta optimallashtirilgan yo‘llar bitma-bit aynan bir xil deb ko‘rsatilgan:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
Boshqa Tensor Core yo‘llarida BF16 akkumulyatsiyasi yoki MMA bajarilish tartibi o‘zgargani sababli kichik farqlar bo‘lishi mumkin. O‘lchangan fused mHC konfiguratsiyalarida qayd etilgan maksimal farqlar 1.9e-3 dan, o‘lchangan sparse-attention prefill konfiguratsiyasida esa 4.8e-3 dan past.
Prompt-logprob manfiy log-ehtimollik natijalari ishga tushirishlar orasidagi qayd etilgan shovqin chegarasida qoldi. Deployment’ni baholashda har bir optimallashtirilgan operator bitma-bit aynan bir xil bo‘lishi kerak deb hisoblamasdan, unumdorlik va sonli natijalarni birgalikda tekshiring.
Kengaytirilgan deployment maslahatlari
Sinovdan o‘tgan olti GPU’li ishlab chiqarish konfiguratsiyasi uchun TP2 × PP3’dan foydalaning
64 GB yoki 80 GB sig‘imli oltita Ampere GPU uchun repozitoriy 14,14,12 qatlam taqsimotiga ega TP2 × PP3 konfiguratsiyasini tavsiya qiladi. Sinovdan o‘tgan konfiguratsiyada bu tuzilma tanlangan bir oqimli kod va uzun generatsiya ish yuklamalari uchun sekundiga 160.8–188.8 token, 64K cold prefill uchun sekundiga 4,506.8 token hamda GPU’da joylashgan taxminan 4.65 million KV token sig‘imini ta’minladi.
Bu sig‘im benchmark konfiguratsiyasida bir million tokenlik taxminan 4.43 ta kontekstga mos keladi.
Muqobil variantlarni tushuning
- PP6: taxminan 4.5–4.7 million token sig‘imini taqdim etadi, biroq README tensor parallelism bir bo‘lgani va so‘rovlar oltita pipeline bosqichidan o‘tishi sababli bir oqimli decode ancha sekinlashishini qayd etadi.
- Asimmetrik TP2 va TP4: taxminiy sig‘imni taxminan olti million tokengacha oshiradi, biroq MoE’ning 2,304 o‘lchamli oraliq hajmini 576 kenglikdagi TP4 bo‘limlariga ajratish Marlin tile samaradorligini pasaytiradi.
Bir million tokenli joylashtirish uchun topologiyani tanlashdan oldin repozitoriydagi docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md faylini ko‘rib chiqing.
Haqiqiy ish yuklamasini sinovdan o‘tkazing
Eng katta yutuqlar tez-tez chaqiriladigan operatorlardan olinadi, biroq uchidan uchigacha bo‘lgan yaxshilanish prompt uzunligi, bir vaqtdagi so‘rovlar soni, spekulyativ dekodlash, topologiya va GPU modeliga bog‘liq. Avval ajratilgan benchmarklarni ishga tushiring, so‘ng ishlab chiqarish ilovangizdagi promptlar, kontekst o‘lchamlari va bir vaqtdagi so‘rovlar darajalari bilan bir xil sharoitda to‘liq xizmat ko‘rsatish ish yuklamalarini taqqoslang.
To‘g‘ridan-to‘g‘ri chiqish tezkor yo‘lini saqlang
Siyrak MLA dekodlash optimizatsiyasi num_kv_splits == 1 bo‘lganda ikkinchi reduction ishga tushirilishini chetlab o‘tadi. Agar attention rejalashtirilishi yoki bo‘lish xatti-harakatini o‘zgartirsangiz, yadroni qayta o‘lchang, chunki to‘g‘ridan-to‘g‘ri chiqish yo‘li qayd etilgan dekodlash yaxshilanishining muhim qismidir.
YOCO metama’lumotlarini forward kontekstida saqlang
20-qavat metama’lumotlar keshi qimmatlidir, chunki 21–39-qavatlardagi barcha iste’molchilar uning KV manbasidan foydalanadi. Model bajarilishi yoki forward-kontekst bilan ishlashdagi o‘zgarishlar bu qayta foydalanishni saqlashi kerak; aks holda, dvigatel har bir iste’molchi qavati uchun bir xil ragged metama’lumotlarni qayta qurishi mumkin.
Xulosa
DeepInfer-SM80 NVIDIA Ampere’da DeepSeek-V4.1’ni KV-kesh VRAM sarfini oshirmagan holda tezlashtirish uchun yo‘naltirilgan yechimni taqdim etadi. Uning yaxshilanishlari Ampere’ga mos siyrak attention, bitshift UE8M0 dekodlashi, to‘g‘ridan-to‘g‘ri KV-kesh chiqishi, poygasiz Top-K va SWA birlashtirgichi, moslashtirilgan mHC marshrutlash hamda YOCO metama’lumotlaridan qayta foydalanishni birlashtiradi.
Avval yagona patchni qo‘llang yoki oltita drop-in modulni o‘rnating. Uskunangizda kechikish va sonli xatti-harakatni tasdiqlash uchun barcha uchta mikrobenchmark to‘plamini ishga tushiring, so‘ng haqiqiy xizmat ko‘rsatish ish yuklamangiz bilan optimallashtirilgan vLLM muhitini baholang. Olti GPU’li, bir millionlik kontekstli joylashtirish uchun repozitoriyda sinovdan o‘tkazilgan TP2 × PP3 konfiguratsiyasidan asosiy ma’lumotnoma sifatida foydalaning.