

NamiGPT nima
NamiGPT xitoy tilini endi o‘rganayotganlar uchun mo‘ljallangan yirik til modellari asoslari bo‘yicha qo‘llanmadir. U PyTorch yordamida GPT-2 ni noldan amalga oshiradi, tayyor Transformer modullaridan foydalanmaydi va OpenAI’ning rasmiy oldindan o‘qitilgan vaznlarini yuklab, inferens hamda matn generatsiyasini bajaradi.
Loyiha uchun asosiy maqsad o‘qitish samaradorligi emas, balki tushunishdir: asosiy model gpt2/model.py faylida joylashgan va kod 200 qatordan kam; qo‘llanma “mushuk baliq yeydi” nomli uch so‘zli misol orqali tokenizatsiya, vektorlar, diqqat matritsasi va yakuniy generatsiya jarayonini bosqichma-bosqich tushuntiradi.
NamiGPT nomi Karpathy’ning nanoGPT loyihasiga hurmat sifatida tanlangan. U xitoy tilini noldan o‘rganayotganlar uchun ta’limga ko‘proq e’tibor qaratib, GPT-2 ning har bir bosqichini minimal misollar orqali tushuntiradi.
Nimalarni o‘rganasiz
- Tokenizer matnni token ID lariga qanday aylantirishi.
- Embedding va pozitsion kodlash model kirishini qanday shakllantirishi.
- Self-Attention va Multi-Head Attention qanday hisoblanishi.
- Qoldiq ulanishi, LayerNorm, FFN va aktivatsiya funksiyalari qanday vazifalarni bajarishi.
- Bir nechta Transformer Block GPT-2 ga qanday birlashtirilishi.
- OpenAI’ning rasmiy vaznlarini qo‘lda yozilgan modelga qanday yuklash.
- Matn generatsiyasi uchun ochko‘zlik, harorat va top-k strategiyalaridan qanday foydalanish.
- Qo‘lda yozilgan implementatsiya HuggingFace implementatsiyasiga mosligini testlar orqali qanday tekshirish.
Loyihaning asosiy xususiyatlari
Asosiy komponentlar noldan amalga oshirilgan
NamiGPT tayyor Transformer modullarini bevosita chaqirmaydi. Model tarkibiga LayerNorm, Attention, FFN, Block va GPT komponentlari kiradi. Bu ma’lumotlar va tensorlar qanday oqishini satrma-satr o‘rganish uchun qulay.
Bob skriptlari mustaqil ishlaydi
Inferens bo‘limi 15 ta bosqichma-bosqich murakkablashib boradigan mavzudan iborat. Ular tokenizator, Embedding, pozitsion kodlash, o‘z-o‘ziga diqqat, ko‘p boshli diqqat, qoldiq ulanishi, qatlamni normallashtirish, oldinga uzatiluvchi tarmoq, aktivatsiya funksiyalari, Transformer Block, steklash, vaznlarni yuklash, matn generatsiyasi va izohlanuvchanlikni o‘z ichiga oladi. Har bir mavzu uchun ishga tushiriladigan skript mavjud.
Interaktiv vizualizatsiya taqdim etiladi
Loyiha Transformer arxitekturasining dinamik tasvirini va to‘liq inferens matritsasi vizualizatsiyasini taqdim etadi. Kod yoki formulalarni tushunish qiyin bo‘lganda, “mushuk baliq yeydi” misolidagi matritsa elementlari katakma-katak qanday hisoblanishini kuzatish mumkin.
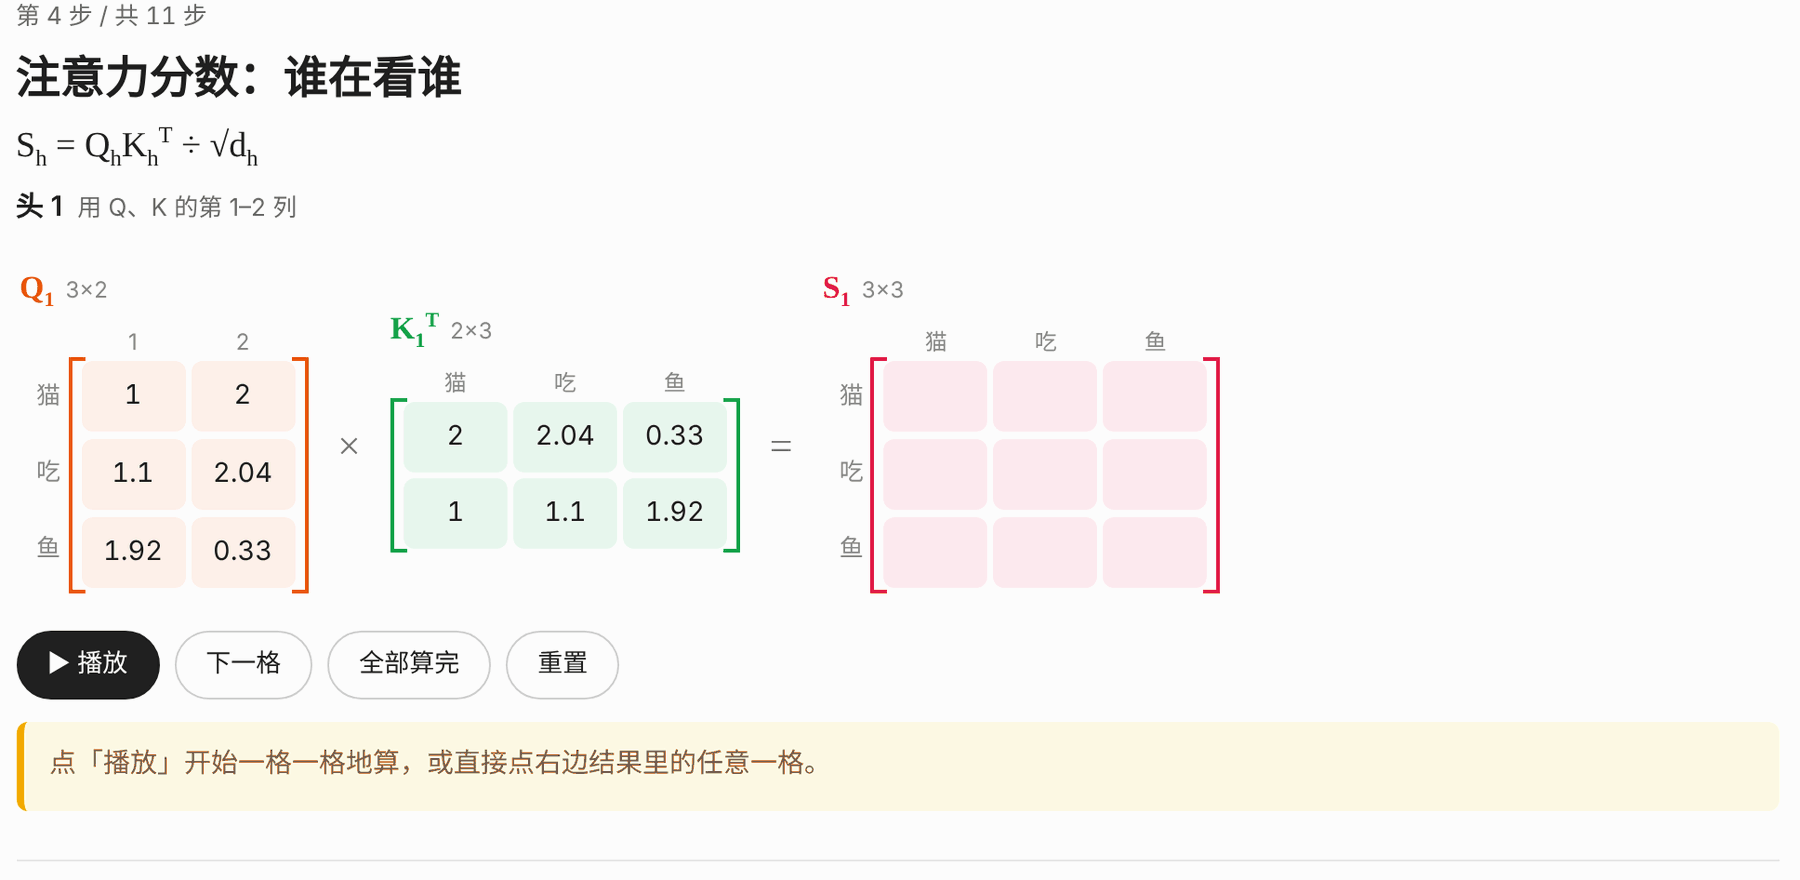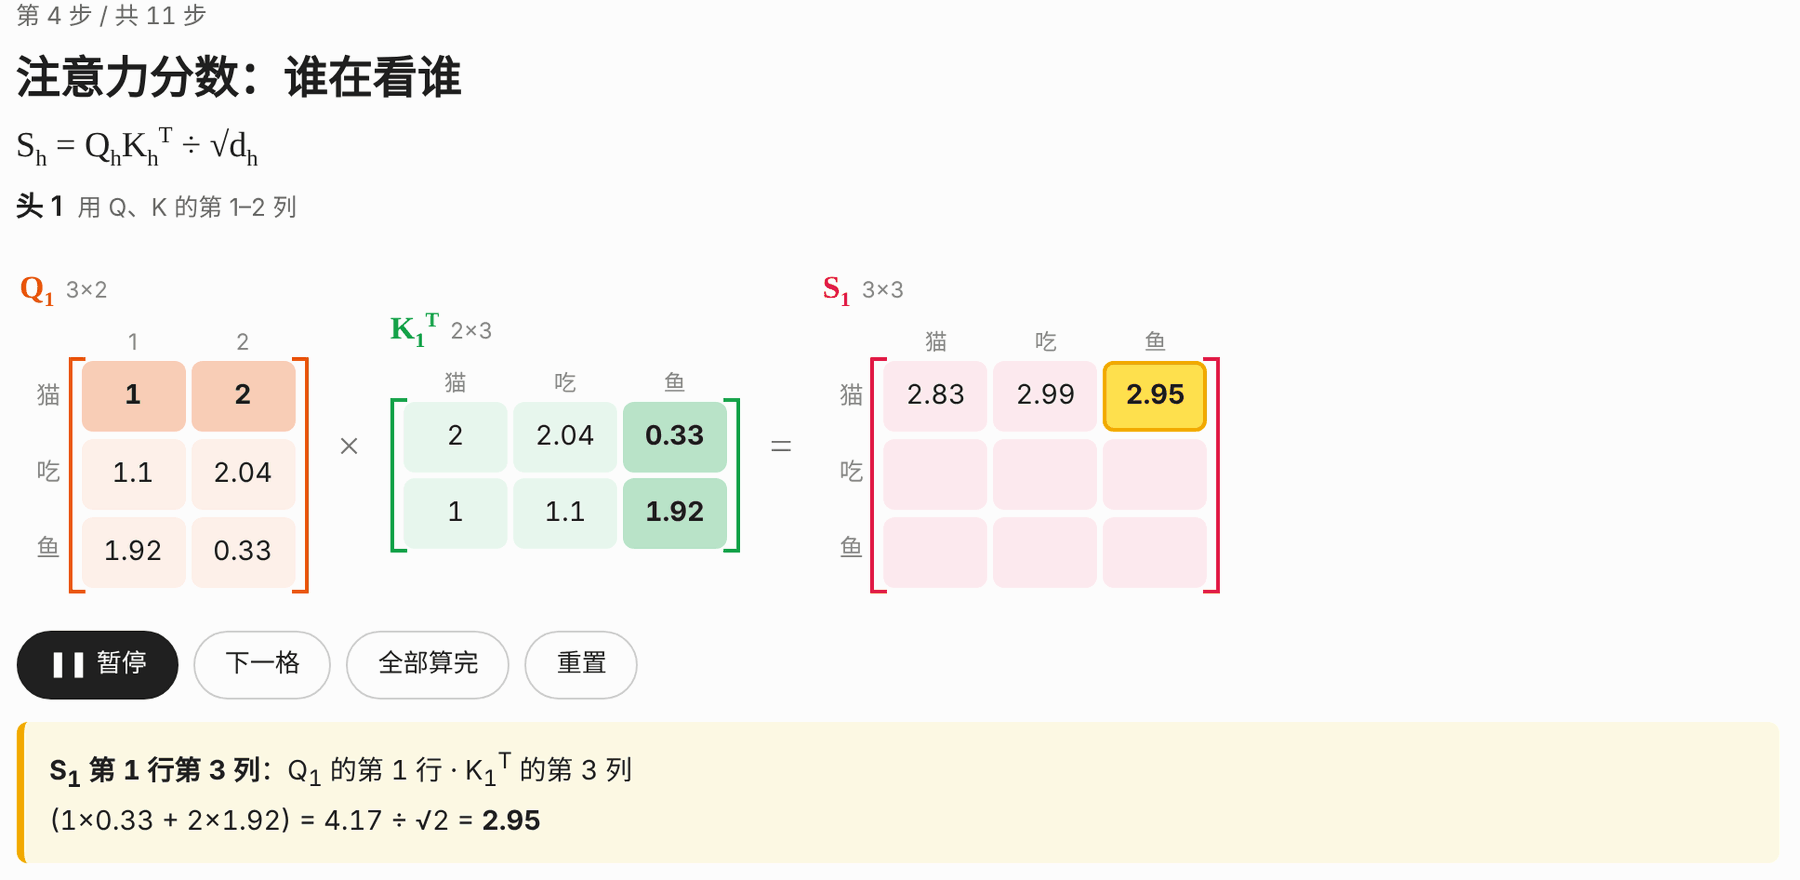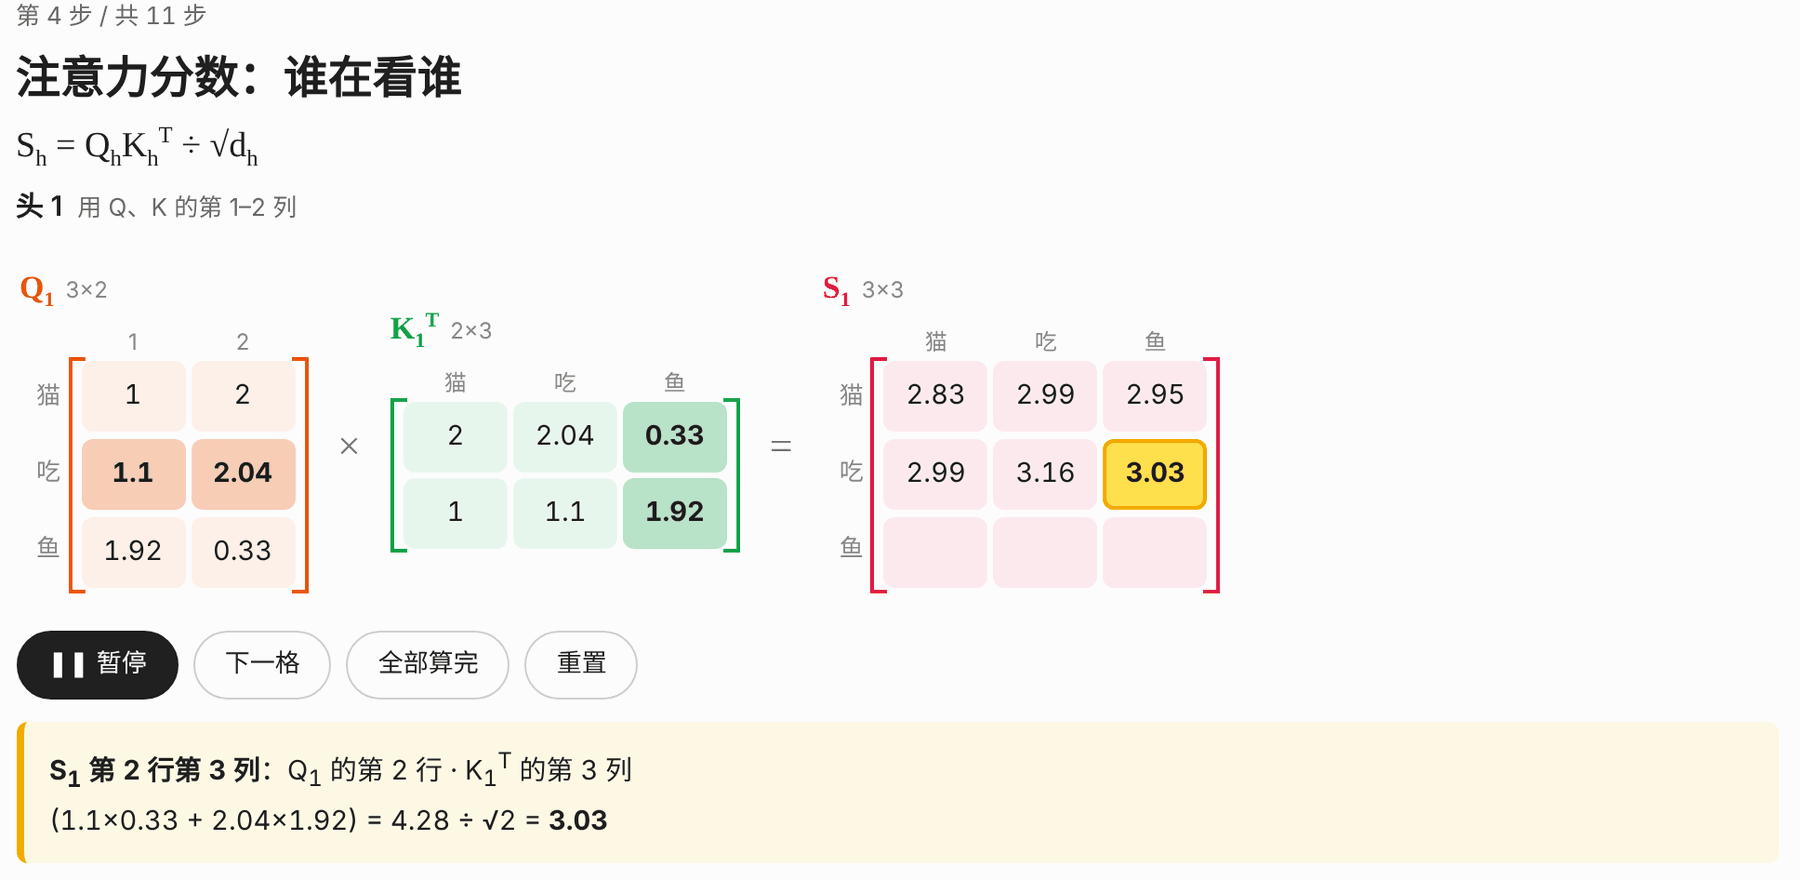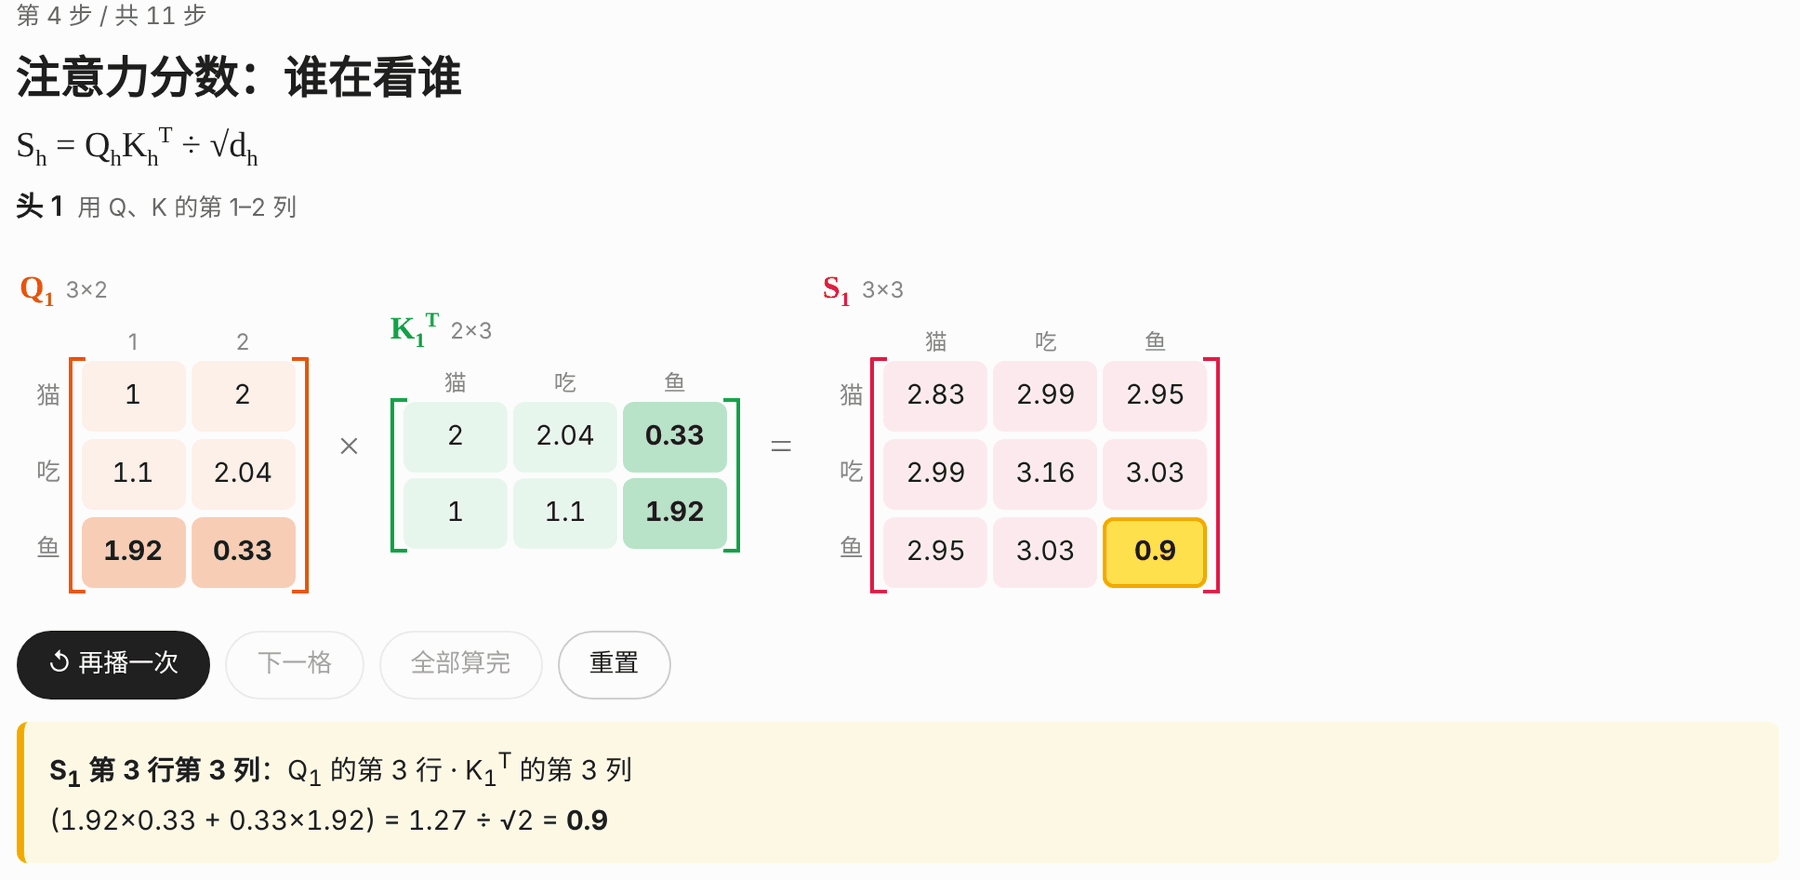
Avval Transformer’ni bir rasmda tushunish materialini ko‘rib chiqing, so‘ng bob kodlari bilan taqqoslash uchun yirik til modeli inferens vizualizatsiyasidan foydalaning.
HuggingFace natijalari bilan moslashtirilgan
Repozitoriyda shakl tekshiruvlari hamda HuggingFace’ning rasmiy implementatsiyasi bilan moslik testlari mavjud. Tasodifiy vaznlar yordamida tezkor taqqoslashdan tashqari, qo‘shimcha tekshiruv uchun haqiqiy GPT-2 vaznlarini ham yuklab olish mumkin.
O‘rnatishdan oldingi tayyorgarlik
Boshlashdan oldin Python kodini o‘qish bo‘yicha boshlang‘ich ko‘nikmaga ega bo‘lish va matritsalarni ko‘paytirish kabi asosiy chiziqli algebra tushunchalarini bilish kerak. Loyiha ko‘rsatgan ish muhiti Python 3.9 va undan yuqori versiya hamda PyTorch 2.x dan iborat.
Avval repozitoriyni klonlang, loyiha katalogiga kiring va bog‘liqliklarni o‘rnating:
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
HuggingFace’dan rasmiy vaznlarni yuklashda tarmoq cheklangan bo‘lsa, joriy terminalda mirror manzilini belgilang:
export HF_ENDPOINT=https://hf-mirror.comUshbu mirror faqat rasmiy vaznlarni yuklash uchun ishlatiladi. Keyinchalik from_pretrained chaqirilganda, model tuzilmasi baribir NamiGPT’ning qo‘lda yozilgan implementatsiyasidan olinadi.
Birinchi qadam: GPT-2 ni boblar orqali tushunish
Boshlovchilar uchun eng qulay usul to‘liq modelni darhol o‘qish emas, balki inferens ma’lumotlar oqimini bobma-bob o‘rganishdir:
- Kirish bosqichi: avval Tokenizer, Embedding va pozitsion kodlashni o‘zlashtiring.
- Diqqat bosqichi: Self-Attention ni tushuning, keyin Multi-Head Attention ga o‘ting.
- Modullar bosqichi: qoldiq ulanishi, LayerNorm, FFN va aktivatsiya funksiyalarini o‘rganing.
- Model bosqichi: komponentlarni Transformer Block ga birlashtiring va uni steklab, to‘liq GPT-2 ni hosil qiling.
- Qo‘llash bosqichi: rasmiy vaznlarni yuklang, matn yarating va izohlanuvchanlik natijalarini ko‘ring.
Har bir skriptni mustaqil ishga tushirish mumkin. Masalan, ko‘p boshli diqqat bobini ishga tushirish:
python chapters/01-inference/ep06_multi_head_attention.pyTo‘liq matnli va rasmlarga boy materialni NamiGPT illyustratsiyali qo‘llanmasidan ko‘rish mumkin, repozitoriydagi asl nusxalar esa docs/01-inference/ katalogida joylashgan.
Ikkinchi qadam: GPT-2 ni yuklash va matn generatsiya qilish
O‘rnatish tugagach, NamiGPT taqdim etadigan modelni yuklash va generatsiya interfeyslarini bevosita import qilish mumkin. Quyidagi misolda GPT-2 tokenizeridan foydalanib, inglizcha prompt token ID lariga kodlanadi, so‘ng qo‘lda yozilgan model va rasmiy 124M vaznlar yuklanadi:
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
Kodning bajarilish jarayoni
tiktoken.get_encoding("gpt2")GPT-2 ishlatadigan kodlovchini oladi.enc.encode(...)prompt matnini token ID lariga aylantiradi.torch.tensorID larni model talab qiladigan batch tensoriga o‘raydi.from_pretrained("gpt2")qo‘lda yozilgan GPT-2 ni yaratadi va rasmiy 124M vaznlarni yuklaydi.generateprompt matnidan keyin ko‘pi bilan 30 ta yangi token generatsiya qiladi.enc.decodechiqish token ID larini yana matnga aylantiradi.
Eslatma: GPT-2 dialog uchun nozik sozlanmagan. U savollarga chat modeli kabi javob berishdan ko‘ra, mavjud matnni davom ettirishga mo‘ljallangan. Uning o‘qitish korpusi asosan ingliz tilida bo‘lgani sababli, avval inglizcha promptlardan foydalanish tavsiya etiladi.
Uchinchi qadam: generatsiya parametrlarini tushunish
Misolda ikkita muhim sampling parametri ishlatilgan:
temperature=0.8: nomzod tokenlar ehtimollik taqsimotini sozlaydi. Loyiha generatsiya moduli harorat strategiyasini qo‘llab-quvvatlaydi.top_k=50: faqat ehtimoli yuqori bo‘lgan dastlabki 50 ta nomzod token orasidan tanlaydi. Loyiha ochko‘zlik va top-k generatsiyasini ham qo‘llab-quvvatlaydi.
O‘rganish paytida prompt matnini o‘zgartirmasdan, faqat harorat yoki top-k qiymatini o‘zgartirib, davom ettirish natijalarini taqqoslash mumkin. Shu orqali generatsiya strategiyasi chiqishga qanday ta’sir qilishini bevosita ko‘rish mumkin, ammo aniq parametrlar tajriba maqsadiga qarab tanlanishi kerak.
To‘rtinchi qadam: Gradio veb namoyishini ishga tushirish
Brauzerda prompt kiritish, davom ettirish natijalarini va har bir bosqichdagi nomzod so‘zlar ehtimolini ko‘rish uchun Gradio’ni o‘rnating va repozitoriydagi namoyish dasturini ishga tushiring:
pip install gradio
python demo/app.py
Veb namoyish modelning har bir bosqichdagi bashoratini kuzatish uchun qulay, bob skriptlari esa alohida komponentlarning hisoblash jarayonini o‘rganish uchun mos. Ularni birga ishlatish orqali yakuniy matnni ichki ehtimollik o‘zgarishlari bilan bog‘lash mumkin.
Beshinchi qadam: testlarni ishga tushirish
Diqqat, vaznlarni yuklash yoki generatsiya mantiqiga o‘zgartirish kiritgandan so‘ng testlarni ishga tushirish tavsiya etiladi. Standart testlar tasodifiy vaznlar yordamida taqqoslanadi, oldindan o‘qitilgan modelni yuklashni talab qilmaydi va odatda tez yakunlanadi:
pytest tests/ -vAgar haqiqiy GPT-2 vaznlari bilan qo‘shimcha moslik tekshiruvini ham o‘tkazmoqchi bo‘lsangiz:
TEST_PRETRAINED=1 pytest tests/ -vIkkinchi buyruq haqiqiy vaznlarni qo‘shimcha ravishda yuklaydi, shuning uchun birinchi ishga tushirishda yuklab olish tugashini kutish kerak.
Repozitoriy tuzilmasiga qisqa nazar
gpt2/config.py: model konfiguratsiyasi, 124M, 355M, 774M va 1.5B o‘lchamlarini o‘z ichiga oladi.gpt2/model.py: LayerNorm, Attention, FFN, Block va GPT modelining asosiy qismi.gpt2/load_weights.py: rasmiy vaznlarni qo‘lda yozilgan modelga yuklaydi.gpt2/generate.py: ochko‘zlik, harorat va top-k generatsiyasi mantiqi.chapters/01-inference/: turli qo‘llanma boblariga mos namoyish skriptlari.docs/01-inference/: qo‘llanma maqolalarining asl nusxalari.demo/app.py: Gradio veb namoyishi.tests/: shakl tekshiruvlari va HuggingFace bilan moslik testlari.
Ilg‘or usullar: HuggingFace bilan moslashtirishdagi uchta muhim jihat
1. Sababiy niqobni to‘g‘ri qo‘llash
GPT-2 autoregressiv til modelidir. Ketma-ketlikdagi har bir so‘z faqat o‘zini va undan oldingi so‘zlarni o‘qiy oladi, keyingi tokenlarni oldindan ko‘ra olmaydi. Agar sababiy niqob qoldirib ketilsa, rasmiy vaznlar muvaffaqiyatli yuklangan taqdirda ham model chiqishi xato bo‘ladi.
2. Vaznlarni ko‘chirishda transpozitsiyani hisobga olish
GPT-2 ning original implementatsiyasi Conv1D dan foydalanadi va uning vazn shakli [in, out] ko‘rinishida; PyTorch’ning nn.Linear moduli esa [out, in] shaklidan foydalanadi. Shu sababli rasmiy parametrlarni qo‘lda yozilgan chiziqli qatlamga yuklashda ularni transpozitsiya qilish shart.
Bundan tashqari, c_attn Query, Key va Value parametrlarini birga birlashtiradi. Qo‘lda yozilgan implementatsiyani moslashtirishda avval ularni tegishli uch qismga ajratib, keyin to‘g‘ri joylarga joylashtirish kerak.
3. GELU ning tanh yaqinlashuvidan foydalanish
GPT-2 GELU ning tanh yaqinlashuv variantidan foydalanadi, PyTorch’ning nn.GELU() moduli esa sukut bo‘yicha aniq variantni qo‘llaydi. Elementma-element moslikka erishish uchun quyidagicha sozlang:
nn.GELU(approximate="tanh")Bu uchta jihat kichik ko‘rinsa-da, qo‘lda yozilgan model rasmiy implementatsiya natijalarini takrorlay olishiga bevosita ta’sir qiladi. Xatoni aniqlashda niqob, parametr shakli va aktivatsiya funksiyasi versiyasini ketma-ket tekshirish mumkin.
Tavsiya etiladigan o‘rganish va nosozliklarni tuzatish usuli
- Avval arxitekturaning dinamik tasviri orqali GPT-2 faqat Transformer dekoder qismidan foydalanishini umumiy tarzda tushuning.
- Joriy bob skriptini ishga tushiring, kirish, chiqish va oraliq tensorlar shakllarini qayd eting.
- Diqqat matritsasini tushunish qiyin bo‘lsa, onlayn matritsa vizualizatsiyasi yordamida katakma-katak tekshiring.
- Biror komponentni tugatgach,
gpt2/model.pydagi mos implementatsiyani o‘qing. - Implementatsiyani o‘zgartirgandan so‘ng avval tasodifiy vaznlar testini, keyin zarurat bo‘lsa haqiqiy vaznlar testini ishga tushiring.
- Oxirida matn generatsiyasi misoli va Gradio sahifasi orqali to‘liq model xatti-harakatini kuzating.
Bu ketma-ketlik arxitektura diagrammasi, matritsa hisoblari, bob kodlari, to‘liq model va yakuniy chiqishni o‘zaro bog‘laydi hamda boshidanoq to‘liq GPT-2 ning ko‘p qatlamli tuzilmasi ichida adashib qolishning oldini oladi.
Xulosa
NamiGPT asosiy matritsa hisob-kitoblaridan to‘liq GPT-2 inferensiyasigacha bo‘lgan o‘rganish yo‘lini taqdim etadi. Avval har bir komponentni tushunish uchun mustaqil bob skriptlarini ishga tushirishingiz, keyin OpenAI’ning rasmiy vaznlarini yuklab, inglizcha matnni davom ettirishni amalga oshirishingiz va nihoyat vizualizatsiya hamda HuggingFace bilan moslik testlari orqali tushunchalaringiz va o‘zgartirishlaringizni tekshirishingiz mumkin.
Loyiha kodi MIT litsenziyasi ostida tarqatiladi; docs/ katalogidagi maqolalar CC BY-NC 4.0 litsenziyasi ostida bo‘lib, qayta nashr etishda manbani ko‘rsatish talab etiladi va tijoriy foydalanish taqiqlanadi.