
LLaMA Factory (hozir LlamaFactory deb ataladi) katta til modellari uchun yagona nozik sozlash freymvorkidir. Ushbu loyiha Pekin Aeronavtika va Astronavtika universitetidagi doktor Zheng Yaowei jamoasi tomonidan boshlangan va ACL 2024 maqolasi bilan ilmiy asoslangan. Freymvork “kodsiz CLI + Web UI” dizaynidan foydalanib, nozik sozlash jarayonini soddalashtirishni maqsad qiladi. LlamaFactory GitHub’da jami 72 000 dan ortiq Stars to‘plagan va katta modellarni nozik sozlash sohasidagi namunaviy implementatsiyaga aylangan.
>
I. Loyiha haqida umumiy ma’lumot
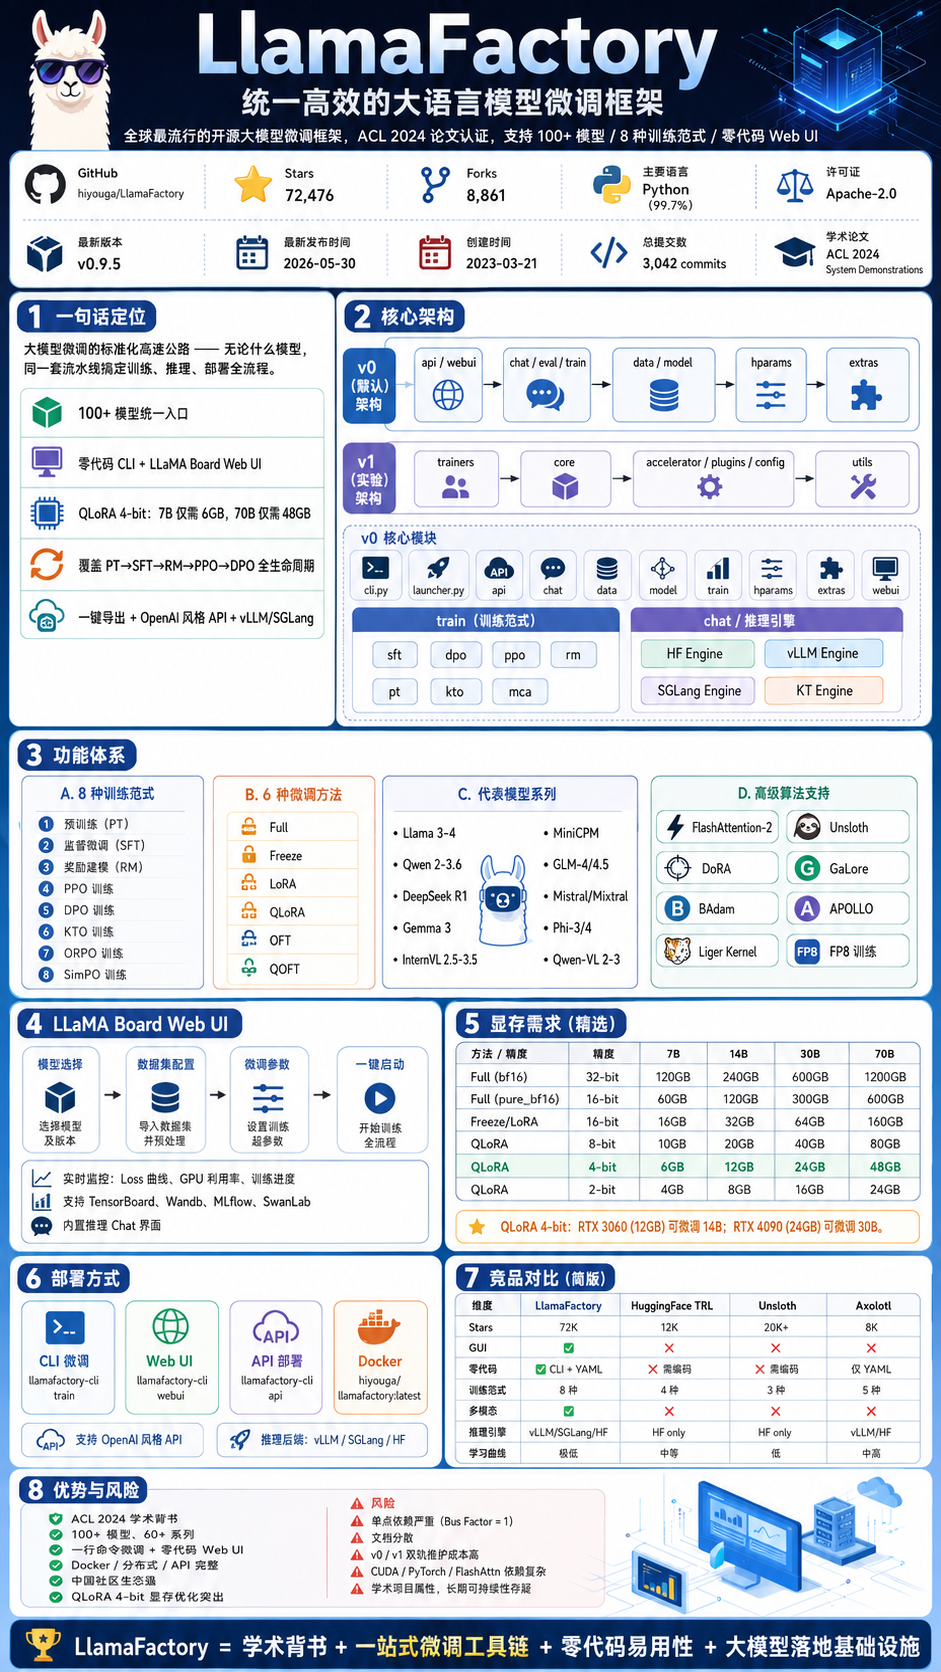
Ko‘rsatkich|Tafsilotlar
Loyihaning to‘liq nomi|LlamaFactory (avvalgi nomi LLaMA-Factory)
GitHub manzili|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
Asosiy til|Python (99.7%)
Litsenziya|Apache-2.0
Yaratilgan sana|2023-03-21
So‘nggi versiya|v0.9.5 (2026-05-30)
Jami commitlar|3,042 commits
Asosiy hissa qo‘shuvchi|hiyouga (Zheng Yaowei, 2,188 commits, jami commitlarning 72%)
Ilmiy maqola|ACL 2024 System Demonstrations
Repozitoriy hajmi|~412.9 MB
Open Issues|57
Asoschi Zheng Yaowei (hiyouga) Pekin Aeronavtika va Astronavtika universitetida doktorant bo‘lib, ACL, CVPR, WWW kabi xalqaro nufuzli konferensiyalarda birinchi muallif sifatida ko‘plab maqolalar chop etgan hamda AAAI, EMNLP kabi konferensiyalarda taqrizchi bo‘lib ishlagan. Uning mukofotlari qatoriga Huawei Cup, Blue Bridge Cup milliy birinchi mukofoti, Beihang universiteti yil talabasi va Ascend ekotizimiga ochiq kodli dasturiy ta’minotdagi ulkan hissasi uchun mukofot kiradi. Hamkor jamoa a’zolari orasida Beihang professorlari Zhang Richong, Zhang Junhao, Ye Yanhan, Luo Zheyan, Feng Zhangchi va Ma Yongqiang bor.
II. Loyihaning yo‘nalishi va asosiy qiymati
2.1 Bir jumlalik ta’rif
Katta modelni nozik sozlashning standartlashtirilgan konveyeri: istalgan model uchun yagona jarayon bo‘lib, ma’lumotlarni tayyorlash, modelni o‘qitish, inferensni tekshirish va deploy qilish kabi to‘liq zanjir bosqichlarini qamrab oladi.
2.2 Hal qilinadigan asosiy muammolar
Muammo|LLaMA Factory yechimi
Turli modellarning nozik sozlash jarayonlari farq qiladi, o‘tish qiymati yuqori|Algoritm-model-ma’lumotlarni "ajratish" dizayni, 100+ model uchun yagona kirish nuqtasi
Nozik sozlash kodi yuqori texnik to‘siqqa ega va chuqur o‘rganish bo‘yicha bilimni talab qiladi|Kodsiz CLI + LLaMA Board Web UI (Gradio)
Video xotira yetishmaydi, iste’molchi GPU’lari katta modellarni o‘qita olmaydi|QLoRA 4-bit: 7B uchun atigi 6GB, 70B uchun atigi 48GB kerak
Ochiq kodli hamjamiyatda bir darcha ostidagi vositalar zanjiri yetishmaydi|PT→SFT→RM→PPO→DPO butun hayotiy siklini qamrab oladi
Inferensni deploy qilish murakkab|Bir marta bosib eksport qilish + OpenAI uslubidagi API + vLLM/SGLang
2.3 Dizayn falsafasi: algoritm-model-ma’lumotlarni "ajratish"
Bir intervyuda Zheng Yaowei model inferensi jarayonini standartlashtirilgan avtomagistralda harakatlanayotgan transport vositasiga qiyoslagan: modelning o‘zi turli xil transport vositalariga, ma’lumotlar esa transport vositasiga yuklangan yukga teng. Model ushbu avtomagistralda muammosiz ishlay olsa, nozik sozlash jarayonini faqat parametrlarni sozlash orqali yakunlash mumkin.
III. Texnik arxitekturani chuqur tahlil qilish
3.1 Ikki arxitekturali parallel dizayn
LLaMA Factory bir vaqtning o‘zida v0 (barqaror versiya) va v1 (eksperimental versiya) arxitekturalarini taqdim etadi; ular o‘rtasida USE_V1 muhit o‘zgaruvchisini sozlash orqali almashish mumkin.
v0 (standart): api/webui → chat/eval/train → data/model → hparams → extras
v1 (eksperimental): trainers → core → accelerator/plugins/config → utils
v0 arxitekturasi hozirgi asosiy implementatsiya bo‘lib, to‘liq funksiyalar va mukammal hujjatlarni taqdim etadi. v1 arxitekturasi hali eksperimental bosqichda bo‘lib, yanada modulli qatlamli dizayndan foydalanadi.
3.2 v0 asosiy modullarining batafsil tavsifi
src/llamafactory/
├── cli.py              # CLI kirish nuqtasi, llamafactory-cli buyruqlarini taqsimlash
├── launcher.py          # Ishga tushirgich, USE_V1 asosida taqsimlaydi
├── api/                 # OpenAI uslubidagi REST API
│   ├── app.py           # FastAPI ilovasi
│   ├── chat.py          # Suhbat endpointi
│   └── protocol.py      # Protokol ta’rifi
├── chat/                # Inferens dvigateli qatlami
│   ├── base_engine.py   # Abstrakt bazaviy sinf
│   ├── hf_engine.py     # HuggingFace’ning original inferensi
│   ├── vllm_engine.py   # vLLM yuqori unumdor inferensi
│   └── sglang_engine.py # SGLang inferensi
├── data/                # Ma’lumotlarni qayta ishlash qatlami
│   ├── template.py      # 100+ model uchun prompt shablonlarini ro‘yxatdan o‘tkazish
│   ├── mm_plugin.py     # Multimodal (rasm/video/audio) qayta ishlash
│   ├── loader.py        # Ma’lumotlar to‘plamini yuklagich
│   ├── processor/       # O‘qitish bosqichlari bo‘yicha protsessorlar
│   └── converter.py     # Formatni o‘zgartirish (Alpaca/ShareGPT)
├── model/               # Model qatlami
│   ├── loader.py        # Model + tokenizatorni yuklash, kvantlash, LoRA
│   └── patcher.py       # Model moslik patchlari
├── train/               # O‘qitish qatlami
│   ├── sft/             # Nazorat ostidagi nozik sozlash
│   ├── dpo/             # DPO afzalliklarini optimallashtirish
│   ├── ppo/             # PPO mustahkamlovchi o‘qitish
│   ├── rm/              # Mukofot modelini qurish
│   ├── pt/              # Oldindan o‘qitish
│   ├── kto/             # KTO o‘qitishi
│   └── mca/             # Megatron-Core moslashuvi
├── hparams/              # Parametrlarni sozlash qatlami
│   ├── model_args.py    # Model parametrlari
│   ├── data_args.py     # Ma’lumotlar parametrlari
│   ├── finetuning_args.py # Nozik sozlash parametrlari
│   └── training_args.py # O‘qitish parametrlari (HF TrainingArguments’dan meros oladi)
├── extras/               # Yordamchi vositalar to‘plami
│   ├── constants.py     # Global konstantalar/enumlar
│   └── packages.py      # Bog‘liqliklarni tekshirish
└── webui/                # LLaMA Board Web interfeysi
    ├── interface.py     # Gradio interfeysini qurish
    ├── runner.py        # O‘qitish vazifalarini ishga tushirish
    └── components/      # UI komponentlari
3.3 O‘qitish jarayoni (v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → YAML/JSON konfiguratsiyasini tahlil qilish
    → get_train_args() → 4 ta tiplashtirilgan dataclass yaratish:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → Muayyan o‘qitish funksiyasiga yo‘naltirish:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (ixtiyoriy) export_model() → LoRA og‘irliklarini birlashtirib eksport qilish
3.4 Inferens dvigatellari matritsasi
Dvigatel|Xususiyatlari|Qo‘llash sohasi
HF Engine|HuggingFace’ning original dvigateli, eng yaxshi moslik|Ishlab chiqish va debugging, kichik hajmdagi inferens
vLLM Engine|270% inferens tezlashuvi, PagedAttention|Yuqori unumdor onlayn inferens
SGLang Engine|RadixAttention, strukturali generatsiya|Ommaviy inferens, murakkab generatsiya
KT Engine|Bilimlarni ko‘chirish uchun maxsus|Model distillyatsiyasi
IV. Funksiyalar tizimi
4.1 Qo‘llab-quvvatlanadigan o‘qitish paradigmalar (8 xil × 6 xil nozik sozlash usuli = 48 ta kombinatsiya)
O‘qitish paradigmasi|Full|Freeze|LoRA|QLoRA|OFT|QOFT
Oldindan o‘qitish (PT)|✅|✅|✅|✅|✅|✅
Nazorat ostidagi nozik sozlash (SFT)|✅|✅|✅|✅|✅|✅
Mukofot modelini qurish (RM)|✅|✅|✅|✅|✅|✅
PPO o‘qitishi|✅|✅|✅|✅|✅|✅
DPO o‘qitishi|✅|✅|✅|✅|✅|✅
KTO o‘qitishi|✅|✅|✅|✅|✅|✅
ORPO o‘qitishi|✅|✅|✅|✅|✅|✅
SimPO o‘qitishi|✅|✅|✅|✅|✅|✅
4.2 Qo‘llab-quvvatlanadigan model seriyalari (60+ seriya, 100+ variant)
Tanlangan namunaviy modellar:
Model seriyasi|Parametrlar miqyosi|Xususiyatlari
Llama 3-4|1B–402B|Metaning flagman ochiq kodli modeli
Qwen 2-3.6|0.5B–397B|Alibaba Tongyi Qianwen’ning to‘liq seriyasi
DeepSeek R1|1.5B–671B|Fikrlash modelining distillatsiya versiyasi
Gemma 3|270M–27B|Google’ning yengil modeli
InternVL 2.5-3.5|1B–241B|Multimodal vizual-lingvistik model
MiniCPM|0.5B–9B|Qurilma tomonida joylashtirish uchun optimallashtirilgan
GLM-4/4.5|9B–355B|Zhipu ChatGLM seriyasi
Mistral/Mixtral|7B–8x22B|MoE ekspertlar aralashmasi
Phi-3/4|3.8B–14B|Microsoft’ning kichik, yuqori unumdor modeli
Qwen-VL 2-3|2B–235B|Vizual-lingvistik model
4.3 Ilg‘or algoritmlarni qo‘llab-quvvatlash
Algoritm|Funksiya|Joriy etilgan versiya
FlashAttention-2|Diqqat hisoblashini tezlashtirish|2023-09
Unsloth|170% tezroq o‘qitish + 50% videoxotira tejalishi|2023-12
DoRA|Og‘irliklarni LoRA orqali ajratish|2024-02
GaLore|Gradientlarning past rangli optimallashtirilishi|2024-03
BAdam|Blok koordinatalari bo‘yicha tushish optimallashtirishi|2024-04
APOLLO|Yuqori tartibli optimizator|2025-Q1
Liger Kernel|Triton yadrosi tezlashtirishi|2025
FP8 training|Transformer Engine qo‘llab-quvvatlashi|2025
4.4 LLaMA Board Web UI
Gradio asosida yaratilgan, kodsiz vizual interfeys
Model tanlash → ma’lumotlar to‘plamini sozlash → nozik sozlash parametrlari → bir marta bosib o‘qitishni boshlash
Real vaqt monitoringi: Loss egri chizig‘i, GPU foydalanilishi, o‘qitish jarayoni
TensorBoard, Wandb, MLflow, SwanLab kabi bir nechta backendlarda jurnallarni qo‘llab-quvvatlash
Ichki Chat inferensiya interfeysi, o‘qitish tugagach darhol sinash mumkin
4.5 Joylashtirish usullari
# CLI orqali nozik sozlash (bir qatorli buyruq)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Web UI
llamafactory-cli webui

# OpenAI uslubidagi API orqali joylashtirish
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
Besh. Uskuna talablari (videoxotira taxmini)
Usul|Aniqlik|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
QLoRA 4-bit kvantlash bitta RTX 3060 (12 GB videoxotira)da 14 B parametrli modelni, bitta RTX 4090 (24 GB videoxotira)da esa 30 B parametrli modelni nozik sozlash imkonini beradi.
Olti. Versiyalar evolyutsiyasi
Versiya|Sana|Asosiy o‘zgarishlar
v0.1.0|2023-03|Dastlabki nashr, LLaMA nozik sozlanishini qo‘llab-quvvatlaydi
Dastlabki iteratsiyalar|2023|SFT + LoRA/QLoRA, DPO, Web UI, FlashAttention-2, Unsloth
Dastlabki iteratsiyalar|2024 Q1-Q3|DoRA, GaLore, BAdam, FSDP+QLoRA, vLLM, multimodal LLaVA, maqola nashri
v0.9.1|2025 Q1|Llama 3.2 Vision, LLaVA-NeXT, Pixtral, Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o, SwanLab, APOLLO optimizatori
v0.9.3|2025 Q2|Llama 4, Gemma 3, Qwen3, InternVL3, Qwen2.5-Omni
v0.9.4|2025-12|🔄 Repozitoriy LlamaFactory deb qayta nomlandi, Python 3.9-3.10 eskirgan deb belgilandi
v0.9.5|2026-05-30|Qwen3.5/3.6, Gemma 4, Transformers v5 bilan moslik
v1.x (eksperimental)|2026|Yangi arxitektura trainers → core → accelerator, modulli qayta yozish
Asosiy bosqichlar sharhi
ACL 2024 maqolasining nashr etilishi —— Akademik e’tirof Stars sonini 10 mingdan 30 mingdan oshirdi
2024 yilning ikkinchi yarmi —— Multimodal qo‘llab-quvvatlash (LLaVA/Video/audio) yangi bozorni ochdi
2025 yil —— Oylik yangilanish ritmi saqlanib, Qwen3/DeepSeek/Llama4 qo‘llab-quvvatlandi va Xitoy ochiq kodli hamjamiyatining birinchi tanloviga aylandi
Repozitoriyning qayta nomlanishi —— LLaMA-Factory → LlamaFactory, Meta brendiga bog‘liqlikdan voz kechish
v1 eksperimental arxitekturasi —— Muhim qayta tuzilish yaqinlashayotganidan darak beradi
Yetti. Hamjamiyat ekotizimi
7.1 Loyihalar ekotizimi matritsasi
Loyiha|Tavsif|Stars
LlamaFactory|Asosiy nozik sozlash freymvorki|72K+
EasyR1|VLM mustahkamlovchi o‘qitish (GRPO/DAPO/Reinforce++)|Yangi loyiha
FastEdit|Model faktlarini samarali tahrirlash|Arxivlangan
llamafactory-community|Hamjamiyat muloqot markazi|-
Easy Dataset|Sintetik ma’lumotlar yaratish vositasi|Uchinchi tomon
DataFlow|Ma’lumotlarni qayta ishlash quvuri|Uchinchi tomon
7.2 Hamjamiyat mashhurligi
Xitoy AI hamjamiyati: CSDN, Zhihu va Blog Garden’da yuzlab qo‘llanma va amaliy tajribalar mavjud
Korxonalar tomonidan qo‘llanishi: Alibaba Cloud, Huawei Ascend, Amazon AWS va NVIDIA tomonidan rasman tavsiya etilgan
Ta’lim sohasi: Fudan universiteti va boshqa ko‘plab oliygohlar tomonidan katta modellar kurslarida o‘quv vositasi sifatida qo‘llanadi
Xitoy tiliga moslashuv: ModelScope (魔搭 hamjamiyati) va OpenMind Hub mirror yuklab olishni tabiiy qo‘llab-quvvatlaydi
LLaMA Factory Online: ilgari onlayn platforma xizmatini taqdim etgan, 2026-06-20 da yopilgan
7.3 Raqobatchilar taqqoslanishi
Freymvork|Stars|Asosiy xususiyat|Modellarni qo‘llab-quvvatlash|Foydalanish qulayligi
LlamaFactory|72K|Bir darcha GUI/CLI, ACL maqolasi bilan tasdiqlangan|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|HF rasmiy vositalar zanjiri, ekotizim bilan chuqur integratsiya|Barcha HF modellari|⭐⭐⭐
Axolotl|8K|YAML asosida boshqariladi, ilg‘or foydalanuvchilar uchun moslashtirish|Asosiy modellar|⭐⭐⭐
Unsloth|20K+|Maksimal unumdorlik optimallashtirilishi (2-5x tezlashuv)|LLaMA/Mistral va boshqalar|⭐⭐⭐⭐
Firefly|5K|Xitoy tilidagi katta modellarni optimallashtirish|Asosan xitoycha modellar|⭐⭐⭐
LLaMA-Adapter|6K|Akademik tadqiqotga yo‘naltirilgan|LLaMA seriyasi|⭐⭐
LlamaFactory’ning asosiy afzalliklari:
Bir vaqtning o‘zida ACL maqolasi + 70 ming Stars + tijoriy joriy etish misollari + kodsiz GUIga ega yagona freymvork
Modellar qamrovi eng keng (GPT-2 dan Llama 4 gacha, sof matndan multimodalgacha)
Xitoy hamjamiyati ekotizimi eng kuchli (HuggingFace mirror’i + ModelScope integratsiyasi)
Sakkiz. SWOT tahlili
8.1 Kuchli tomonlar (Strengths)
Kuchli tomon|Batafsil tavsif
🔬 Akademik nufuz|ACL 2024 maqolasi, 500+ akademik iqtibos
🎯 Juda past kirish to‘sig‘i|Bir qatorli buyruq bilan nozik sozlash, Web UI orqali kodsiz ishlash
🌐 Modellarning eng keng qamrovi|100+ model, 60+ seriya, matn/ko‘rish/video/audio
🇨🇳 Xitoy hamjamiyati ekotizimi|ModelScope/OpenMind mirror’lari, xitoy tilidagi ko‘plab qo‘llanmalar
🔧 Sanoat darajasidagi vositalar zanjiri|Docker/tarqatilgan/API joylashtirishning barchasi mavjud
💾 Videoxotirani maksimal optimallashtirish|QLoRA 4-bit iste’molchi GPU’da 70B modelni ishga tushiradi
8.2 Zaif tomonlar (Weaknesses)
Zaif tomon|Batafsil tavsif
👤 Bir kishiga kuchli bog‘liqlik|hiyouga commitlarning 72% ini amalga oshirgan (2,188/3,042), Bus Factor = 1
📚 Hujjatlar tarqoq|README juda uzun (68KB), Wiki/ReadTheDocs/hamjamiyat maqolalaridagi ma’lumotlar parchalangan
🐛 Issue’lar to‘planishi|Faqat 57 ta ochiq Issue mavjud, biroq Issue bo‘limidagi muhokamalar hajmi juda katta
🏗️ v0/v1 ikki yo‘nalishga bo‘lingan|Ikki arxitekturani saqlash xarajati yuqori, v1 uzoq vaqt barqarorlashmagan
📦 Paket bog‘liqliklari murakkab|CUDA/PyTorch/FlashAttn versiyalari matritsasida xato qilish juda oson
🔒 Akademik loyiha xususiyati|To‘liq stavkali operatsion jamoa yo‘q, uzoq muddatli barqarorlik shubha ostida
8.3 Imkoniyatlar (Opportunities)
Imkoniyat|Batafsil tavsif
🚀 Agentlarni nozik sozlash|Function Calling / Tool Use nozik sozlashiga talab keskin oshmoqda
🎥 Multimodal kengayish|Video/Audio/3D modellarini nozik sozlash uchun istiqbolli bozor
☁️ Bulutli native SaaS|LLaMA Factory Online yopilgan bo‘lsa-da, korporativ boshqariladigan xizmatlarga talab saqlanib qolmoqda
🏢 Korporativ ta’lim bozori|Katta modellarni nozik sozlash kurslari va sertifikatlash tizimi
🔗 MCP integratsiyasi|AI Agent infratuzilmasi uchun nozik sozlash backend’i
8.4 Tahdidlar (Threats)
Tahdid|Batafsil tavsif
🏢 Yirik kompaniyalarning ichki freymvorklari|Alibaba PAI va Huawei ModelArts integratsiyalashgan yechimlarni taqdim etadi
🔄 HF rasmiy raqobati|HuggingFace TRL/peft ekotizimi tobora takomillashmoqda
📉 Nozik sozlashga talabning qisqarishi|Prompt Engineering + RAG nozik sozlash holatlarining bir qismini almashtirmoqda
👨🎓 Asoschining bitirishi|Doktor Zheng Yaowei o‘qishni tugatgach, loyihaga xizmat ko‘rsatish darajasi pasayishi mumkin
To‘qqiz. Xatarlarni baholash
Xavf toifasi|Xavf darajasi|Izoh
Bus Factor|🔴 Yuqori xavf|Yagona asosiy dasturchi commitlarning 72 foizini amalga oshirgan, u ketgan taqdirda loyiha to‘xtab qolish xavfi juda yuqori
Texnik qarz|🟡 O‘rta xavf|v0/v1 ikki arxitekturasi, 68KB README, hujjatlarning tarqoqligi
Bog‘liqliklar zanjiri|🟡 O‘rta xavf|CUDA/PyTorch/FlashAttn versiyalari matritsasini yuritish xarajati yuqori
Tijoratlashtirish|🟢 Past xavf|Apache-2.0 litsenziyasi, tijoriy cheklovlar yo‘q
Hamjamiyat salomatligi|🟢 Sog‘lom|72 ming Stars, faol global hamjamiyat, korxonalar tomonidan keng qo‘llanadi
O‘n. Texnik jihatlar va innovatsiyalar
10.1 “Standartlashtirilgan tezyurar yo‘l” arxitekturasi
An’anaviy fine-tuning jarayonida turli modellar alohida moslashtirilishi kerak. LLaMA Factory shablonlarni ro‘yxatdan o‘tkazish mexanizmini monkey‑patch texnologiyasi bilan birlashtirib, moslashtirish xarajatlarini sezilarli kamaytiradi.
# Yangi model qo‘shish uchun atigi 3 qadam kerak:
# 1. template.py faylidagi TEMPLATES lug‘atida Prompt shablonini ro‘yxatdan o‘tkazing
# 2. patcher.py fayliga model mosligi patchini qo‘shing (zarur bo‘lsa)
# 3. mm_plugin.py fayliga multimodal qo‘llab-quvvatlashni qo‘shing (zarur bo‘lsa)
10.2 To‘rt qatlamli parametrlarni sozlash tizimi
YAML/JSON konfiguratsiya fayli
  → parser.py tahlili
    → ModelArguments (model tanlovi, kvantlash)
    → DataArguments (ma’lumotlar to‘plami, shablon, oldindan qayta ishlash)
    → FinetuningArguments (LoRA rank/target, o‘qitish usuli)
    → TrainingArguments (HF’dan meros oladi, taqsimlangan o‘qitish/jurnallar/checkpoint)
10.3 Ma’lumotlar quvurini standartlashtirish
Ushbu vosita Alpaca va ShareGPT kabi ikki asosiy ma’lumot formatini qo‘llab-quvvatlaydi, 50 dan ortiq oldindan tayyorlangan ma’lumotlar to‘plamini avtomatik o‘zgartira oladi hamda JSON, JSONL, CSV, Parquet, Arrow kabi fayl formatlari bilan mos keladi.
10.4 Bosqichma-bosqich kvantlashni qo‘llab-quvvatlash
16 bitli to‘liq aniqlikdan 2 bitli QLoRA’gacha bo‘lgan olti xil aniqlik darajasi qo‘llab-quvvatlanadi; undan A100 server klasterlarida ham, oddiy noutbuklarda ham foydalanish mumkin.
O‘n bir. Raqobatchilarni taqqoslash matritsasi
Mezon|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
Model qo‘llab-quvvatlovi|100+ seriya|Barcha HF|LLaMA/Qwen/Mistral|Asosiy seriyalar
GUI|✅ LLaMA Board|❌|❌|❌
Kodsiz ishlash|✅ CLI + YAML|❌ Kodlash kerak|❌ Kodlash kerak|Faqat YAML
O‘qitish paradigmalari|8 ta|4 ta (SFT/DPO/PPO/GRPO)|3 ta|5 ta
Kvantlash chuqurligi|2-16bit|4-16bit|4-16bit|4-16bit
Multimodallik|✅ Rasm/video/audio|❌|❌|❌
Xitoycha ekotizim|✅ ModelScope + 魔搭|⚠️ VPN kerak|⚠️ VPN kerak|❌
Ilmiy maqola|ACL 2024|-|-|-
Inferens dvigateli|vLLM/SGLang/HF|Faqat HF|Faqat HF|vLLM/HF
O‘rganish egri chizig‘i|Juda past|O‘rta|Past|O‘rta-yuqori
O‘n ikki. Joriy etish bo‘yicha amaliy jihatlar
12.1 Tezkor boshlash (3 qadam)
# 1-qadam: O‘rnatish
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# 2-qadam: Web UI’ni ishga tushirish
llamafactory-cli webui

# 3-qadam: Brauzerda localhost:7860 manzilini oching, model → ma’lumotlar to‘plami → o‘qitishni tanlang!
12.2 Ishlab chiqarish muhiti uchun tavsiyalar
# Docker orqali joriy etish (tavsiya etiladi)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# API orqali joriy etish (OpenAI bilan mos)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Windows foydalanuvchilari uchun eslatmalar
PyTorch’ning GPU versiyasini qo‘lda o‘rnatish kerak:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA uchun Windows’ga maxsus bitsandbytes oldindan kompilyatsiya qilingan versiyasini o‘rnatish kerak
Windows’da FlashAttention-2’ni qo‘lda kompilyatsiya qilish kerak
Serializatsiya xatolarining oldini olish uchun
dataloader_num_workers: 0ni sozlang
O‘n uch. Kelajak istiqbollari
v1 arxitekturasini barqarorlashtirish: eksperimental tarmoq 2026-2027 yillarda asosiy arxitekturaga aylanishi, modullilik darajasi esa oshishi kutilmoqda
Agent fine-tuning’ini chuqurlashtirish: Tool Use / Function Calling fine-tuningi standart funksiyaga aylanadi
Inferens modellarini (Reasoning) fine-tuning qilish: DeepSeek-R1 distillyatsiyasi + GRPO fine-tuningi (EasyR1 loyihasi)
Bulutga xos xosting: LLaMA Factory Online yopilgach, uchinchi tomon xosting yechimlari paydo bo‘lishi mumkin
Multimodal o‘qitishni birlashtirish: matn/rasm/video/audio’ni yagona freymvorkda fine-tuning qilish
O‘n to‘rt. Baholash va xulosa
Mezon|Baho|Sharh
Texnik arxitektura|9.5/10|Modulli dizayn, ikki arxitekturaning rivoji, boy dvigatellar matritsasi
Funksional to‘liqlik|10/10|8 ta o‘qitish paradigmasi × 6 ta fine-tuning usuli × 100+ model
Qulaylik|10/10|Bir qatorli buyruq orqali fine-tuning + kodsiz Web UI, sohadagi eng yaxshilardan
Hujjatlar sifati|7.5/10|README batafsil, ammo juda uzun; tarqoqlik jiddiy
Hamjamiyat faolligi|9.5/10|72K Stars, Xitoy hamjamiyatida fenomenal mashhurlik
Ishlab chiqarishga tayyorlik|9.0/10|Docker/API/taqsimlangan tizim to‘liq, korxonalarda keng sinovdan o‘tgan
Barqaror rivojlanish|6.5/10|Bus Factor=1, akademik loyiha xususiyati, uzoq muddatli istiqbol noaniq
Innovatsionlik|8.5/10|ACL maqolasi, shablonlarni ro‘yxatdan o‘tkazish mexanizmi, to‘rt qatlamli parametrlar tizimi
Umumiy baho: 9.
Bir jumlalik xulosa
LLaMA Factory — ACL 2024 maqolasi asosida yaratilgan va GitHub’da taxminan 72 000 ta yulduz bilan hamjamiyat e’tirofiga sazovor bo‘lgan, ochiq kodli katta til modellari fine-tuning freymvorkidir. Freymvork “algoritm‑model‑ma’lumotlarni ajratish” dizayn tamoyiliga amal qiladi, kodsiz buyruq qatori interfeysi (CLI) va Web UI’ni taqdim etadi hamda 100 dan ortiq modelni fine-tuning qilishni qo‘llab-quvvatlaydi. Shu tariqa katta til modellarini fine-tuning qilishning texnik chegarasini sezilarli pasaytiradi. Undan katta til modellari asosidagi ilovalarni amaliyotga joriy etish uchun infratuzilma sifatida foydalanish mumkin.