

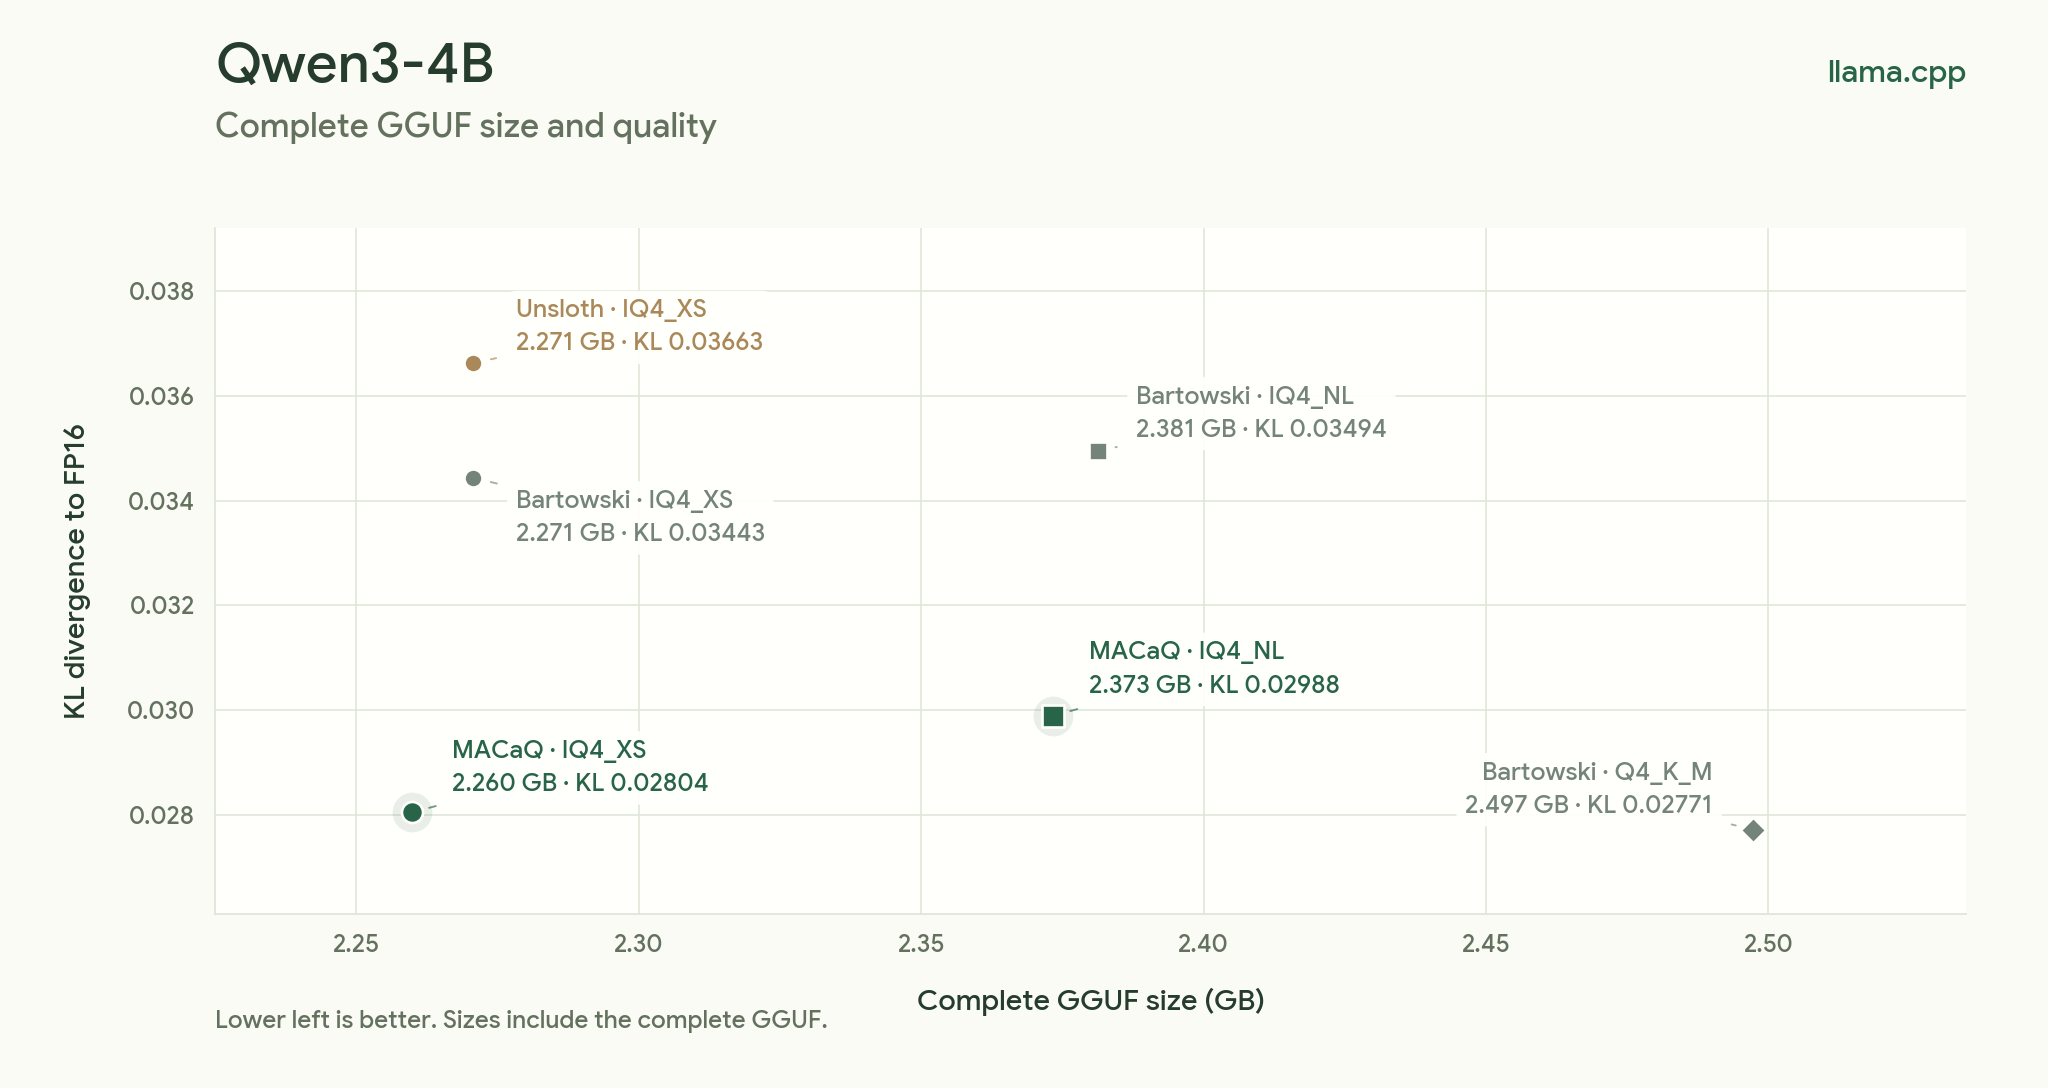
MACaQ zamonaviy AI modellarining xotira va hisoblash talablarini kamaytirish uchun mo‘ljallangan, modelga bog‘liq bo‘lmagan kalibrlangan kvantlash loyihasidir. U llama.cpp, vLLM, Diffusers va PyTorch orqali matn, tasvir, video va audio jarayonlarini qo‘llab-quvvatlaydi.
Loyiha amaliy inferens mosligini saqlagan holda, kalibrlangan past aniqlikdagi og‘irliklar va aktivatsiyalarga e’tibor qaratadi. README ma’lumotlariga ko‘ra, MACaQ 122 milliard parametrli modelni 32,5 GB qurilma xotirasidan foydalanib, 64 daqiqada kvantlashi mumkin. Ayrim taqqoslashlarda u MR-GPTQ va DuQuant++ ga qaraganda pastroq perplexity ko‘rsatadi yoki kvantlash uchun ancha kam vaqt sarflab, Llama-3-8B bilan taqqoslanadigan perplexity natijasini beradi.
To‘g‘ri MACaQ backendini tanlang
Modelingiz va joylashtirish maqsadingizga mos backendni tanlashdan boshlang. Har bir backend uchun alohida muhit va Python 3.12 dan foydalaning.
- Diffusers: tasvir, video va audio generatsiyasi modellarini W4A4 safetensors checkpointlariga kvantlaydi.
- llama.cpp: matn modellarini 2, 3 yoki 4 bitli GGUF fayllariga kvantlaydi va ularni, jumladan CPU da ham, mahalliy ishga tushiradi.
- vLLM: matn modellarini W4A4 yoki faqat og‘irlik formatlarida generatsiya yoki HTTP orqali xizmat ko‘rsatish uchun kvantlaydi.
- PyTorch: nutq generatsiyasi modellarini W4A4 checkpointlariga kvantlaydi va WAV audio yaratadi.
Repository har bir backend uchun o‘rnatish, kalibrlash, kvantlash va generatsiya bo‘yicha alohida ko‘rsatmalarni o‘z ichiga oladi. Boshlashdan oldin tanlagan backendingiz qo‘llanmasini oching:
- Diffusers o‘rnatilishi va ish jarayonlari
- llama.cpp o‘rnatilishi va ish jarayonlari
- vLLM o‘rnatilishi va xizmat ko‘rsatish
- PyTorch nutq jarayonlari
Muhitni tayyorlang
Python 3.12 dan foydalaning va ishlatmoqchi bo‘lgan backend uchun ajratilgan muhit yarating. Muhitlarni alohida saqlash llama.cpp, vLLM, Diffusers va PyTorch o‘rtasidagi bog‘liqlik ziddiyatlarining oldini olishga yordam beradi.
MACaQ repositorysini klonlang va uning katalogiga kiring.
Tanlangan backend uchun Python 3.12 virtual muhitini yarating.
Ushbu backend README fayliga amal qilib, uning bog‘liqliklari va talab qilinadigan ishga tushirish muhitini o‘rnating.
Backend qo‘llanmasida ko‘rsatilgan asl model, kalibrlash ma’lumotlari va chiqish katalogini tayyorlang.
Aniq o‘rnatish buyruqlari backend va model oilasiga bog‘liq, shuning uchun barcha ish jarayonlariga bitta umumiy o‘rnatish buyrug‘ini qo‘llash o‘rniga, havoladagi README faylidan foydalaning.
Diffusers yordamida generativ modellarni kvantlang
Diffusers backend’i diffusion transformerlarini qayta ishlaydi va kvantlangan safetensors checkpointlarini saqlaydi. U tasvir, video, tasvirdan videoga va audio generatsiyasini qo‘llab-quvvatlaydi.
Repository black-forest-labs/FLUX.2-klein-4B, Wan-AI/Wan2.2-TI2V-5B-Diffusers va ylacombe/stable-audio-1.0 kabi modellar uchun ish jarayonlarini taqdim etadi. Tasvirdan videoga modellar uchun kalibrlashda shartlovchi tasvirlardan foydalanish mumkin, bu kvantlash jarayoni mo‘ljallangan kirish namunasini aks ettirishini ta’minlaydi.
Diffusers qo‘llanmasini oching va tasvir, video yoki audio ish jarayonini tanlang.
Backend talablarini maxsus Python 3.12 muhitiga o‘rnating.
Asl modelni yuklab oling yoki aniqlang hamda tanlangan retsept uchun zarur kalibrlash kirishlarini tayyorlang.
W4A4 safetensors checkpointini saqlash uchun hujjatlashtirilgan kvantlash buyrug‘ini bajaring.
Tasvir, video yoki audio natijasini yaratish uchun mos generatsiya buyrug‘idan foydalaning.
llama.cpp yordamida matn modellarini kvantlang
llama.cpp backend’i matn generatsiyasi uchun ixcham GGUF fayllarini yaratadi. U 2, 3 va 4 bitli GGUF formatlarini qo‘llab-quvvatlaydi hamda olingan modeldan matn yaratish uchun ishga tushirish muhitini o‘z ichiga oladi.
Repository Qwen/Qwen3-4B kabi zich modellar, Qwen/Qwen3.8-27B kabi gibrid modellar va Qwen/Qwen3-30B-A3B hamda Qwen/Qwen3-Coder-30B-A3B-Instruct kabi ekspertlar aralashmasi modellarini hujjatlashtiradi. Unda Qwen3.6-35B-A3B va Qwen3.8-Flash-Next uchun retseptlar ham mavjud.
Standart kvantlash ish jarayoni
llama.cpp qo‘llanmasini oching va modelingiz arxitekturasiga mos retseptni tanlang.
llama.cpp backend’i va uning bog‘liqliklarini maxsus Python 3.12 muhitiga o‘rnating.
Tanlangan retseptda tasvirlangan asl Hugging Face modelini va kalibrlash matnini tayyorlang.
Hujjatlashtirilgan MACaQ kvantlash ish jarayonini bajaring va GGUF chiqishini saqlang.
Matn yaratish uchun birga berilgan ishga tushirish muhitidan yoki mos llama.cpp o‘rnatmasidan foydalaning.
Modelga xos tafsilotlar uchun backend README faylidagi dense, hybrid, mixture-of-experts yoki Flash-Next bo‘limiga murojaat qiling. Ushbu retseptlar model arxitekturalari o‘rtasidagi farqlarni hisobga oladi.
GGUF modelini ishga tushirish
GGUF fayli yaratilgach, uni llama.cpp buyruqlar qatori klienti yordamida ishga tushiring:
llama cli -m models/model-macaq-r.ggufModelni llama.cpp orqali ham server sifatida ishga tushirishingiz mumkin:
llama serve -m models/model-macaq-r.ggufMavjud GGUF fayllarini MACaQ-R bilan takomillashtirish
MACaQ-R mavjud kvantlangan GGUF faylidagi og‘irlik kodlarini uning asl formatlari va blok masshtablarini saqlagan holda takomillashtiradi. Natijadagi fayl standart llama.cpp o‘rnatmasi bilan mosligicha qoladi.
Bu kvantlangan modelga ega bo‘lganingizda va GGUF formatini o‘zgartirmasdan uning sifatini yaxshilash yoki muayyan ish yuklamasiga moslashtirishni xohlaganingizda foydalidir. README faylida Hugging Face saytida Qwen3.6-35B-A3B MACaQ-R modeli keltirilgan va u ko‘rsatilgan bir xil hajmdagi taqqoslangan Unsloth UD-Q4_K_XL fayliga nisbatan pastroq KL divergentsiyasiga ega ekani qayd etilgan.
Kvantlangan MoE GGUF faylini takomillashtirish uchun kvantlangan model, unga mos original Hugging Face modeli, FP16 teacher fayli, kalibrlash matni, chiqish yo‘li va ishchi katalogni ko‘rsating:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
Takomillashtirish tugagach, chiqish faylini standart llama.cpp yordamida yuklang:
llama cli -m models/model-macaq-r.ggufAktivatsiya transformatsiyalarini ham o‘z ichiga olgan to‘liq MACaQ ish jarayoni uchun jamlangan runtime qo‘llanmasidan foydalaning.
vLLM bilan modellarni kvantlash va server sifatida ishga tushirish
vLLM backend generatsiya yoki HTTP orqali xizmat ko‘rsatish uchun ixcham matn modeli checkpointlarini yaratadi. W4A4 standart inferensiya rejimi bo‘lib, backend faqat og‘irliklarni kvantlashni ham qo‘llab-quvvatlaydi.
vLLM qo‘llanmasini oching va hybrid matn modeli yoki text mixture-of-experts modeli uchun ish jarayonini tanlang.
vLLM backendini alohida Python 3.12 muhitiga o‘rnating.
Tanlangan retsept talab qiladigan manba model va kalibrlash ma’lumotlarini tayyorlang.
Ixcham checkpoint yaratish uchun hujjatlashtirilgan kvantlash buyrug‘ini ishga tushiring.
Checkpointni lokal generatsiya uchun yuklang yoki hujjatlashtirilgan HTTP serverni ishga tushiring.
README faylida Qwen3.8-27B taqqoslovi keltirilgan: MACaQ W4A4 perplexity qiymati bo‘yicha 2.8994 natijaga erishadi, BF16 esa 2.8463 natija beradi. Shu bilan birga, ko‘rsatilgan test sozlamalarida prefill va decode o‘lchovlari tezroq ekani qayd etilgan.
PyTorch bilan nutq generatorlarini kvantlash
PyTorch backend nutq generatsiyasiga mo‘ljallangan va W4A4 checkpointlarini saqlaydi. Checkpoint saqlangach, uni kalibrlashni takrorlamasdan yuklash mumkin.
Hujjatlashtirilgan ish jarayonlari Qwen3-TTS va Chatterbox Turboni qamrab oladi.
PyTorch qo‘llanmasini oching va nutq modelini tanlang.
Kerakli PyTorch bog‘liqliklarini alohida Python 3.12 muhitiga o‘rnating.
Modelga xos ko‘rsatmalar asosida kalibrlash va kvantlashni ishga tushiring.
W4A4 checkpointini saqlang.
Saqlangan checkpointni yuklang va qayta kalibrlamasdan WAV audio yarating.
MACaQ’dan Ascend uskunasi bilan foydalanish
MACaQ W4A4 dense va guruhlangan matritsali ko‘paytirish yadrolari CANN bilan bog‘liq pull requestlar orqali mavjud. README fayli ops-nn 12568-pull requestidagi PTO-ISA yadrolari hamda ops-tilelang 44-pull requestidagi CCE backendli TileLang yadrolariga havola beradi.
Mos CANN, PyTorch va torch_npu versiyalari uchun ushbu loyihalardagi yig‘ish ko‘rsatmalariga amal qiling. To‘liq modelni ishga tushirish Ascend inferensiya runtime’i bilan integratsiyani talab qiladi.
Yaxshiroq ish jarayonlari uchun amaliy maslahatlar
- Backendni joylashtirish maqsadiga moslang. Portativ lokal matn inferensiyasi uchun GGUF va llama.cpp, matn orqali xizmat ko‘rsatish uchun vLLM, multimodal generatsiya uchun Diffusers, nutq modellari uchun esa PyTorch’ni tanlang.
- Modelga xos retseptlardan foydalaning. Dense, hybrid va mixture-of-experts modellari turli tayyorlash va kvantlash bosqichlarini talab qilishi mumkin.
- Kalibrlash ma’lumotlarini foydalanish holatiga moslang. Masalan, Diffusers image-to-video ish jarayoni kalibrlash vaqtida shartlovchi tasvirlardan foydalanadi.
- Muhitlarni ajrating. README har bir backend va Python 3.12 uchun alohida muhitdan foydalanishni aniq tavsiya qiladi.
- Faqat fayl hajmini emas, sifatni ham taqqoslang. Loyiha kvantlangan modellarni FP16 yoki boshqa kvantlash usullariga nisbatan baholash uchun perplexity va KL divergentsiyasi taqqoslovlaridan foydalanadi.
- GGUF mavjud bo‘lsa, MACaQ-R’dan foydalaning. U standart llama.cpp mosligini saqlagan holda mavjud kvantlangan faylni takomillashtirishi mumkin.
Xulosa
MACaQ GGUF matn modellaridan tortib Diffusers tasvir, video va audio modellari, vLLM xizmat ko‘rsatish chekpointlari hamda PyTorch nutq generatorlarigacha bo‘lgan turli AI ish yuklamalarida yagona kvantlash yondashuvini taqdim etadi. Backendga xos README faylidan boshlang, ajratilgan muhitda Python 3.12 dan foydalaning, kalibrlash uchun model retseptiga amal qiling va hosil bo‘lgan chekpointni mo‘ljallangan runtime bilan tekshiring.
Tadqiqot yoki texnik hujjatlar uchun MACaQ maqolasiga qarang. Loyiha Apache License 2.0 asosida chiqarilgan.