

DeepSelect nima?
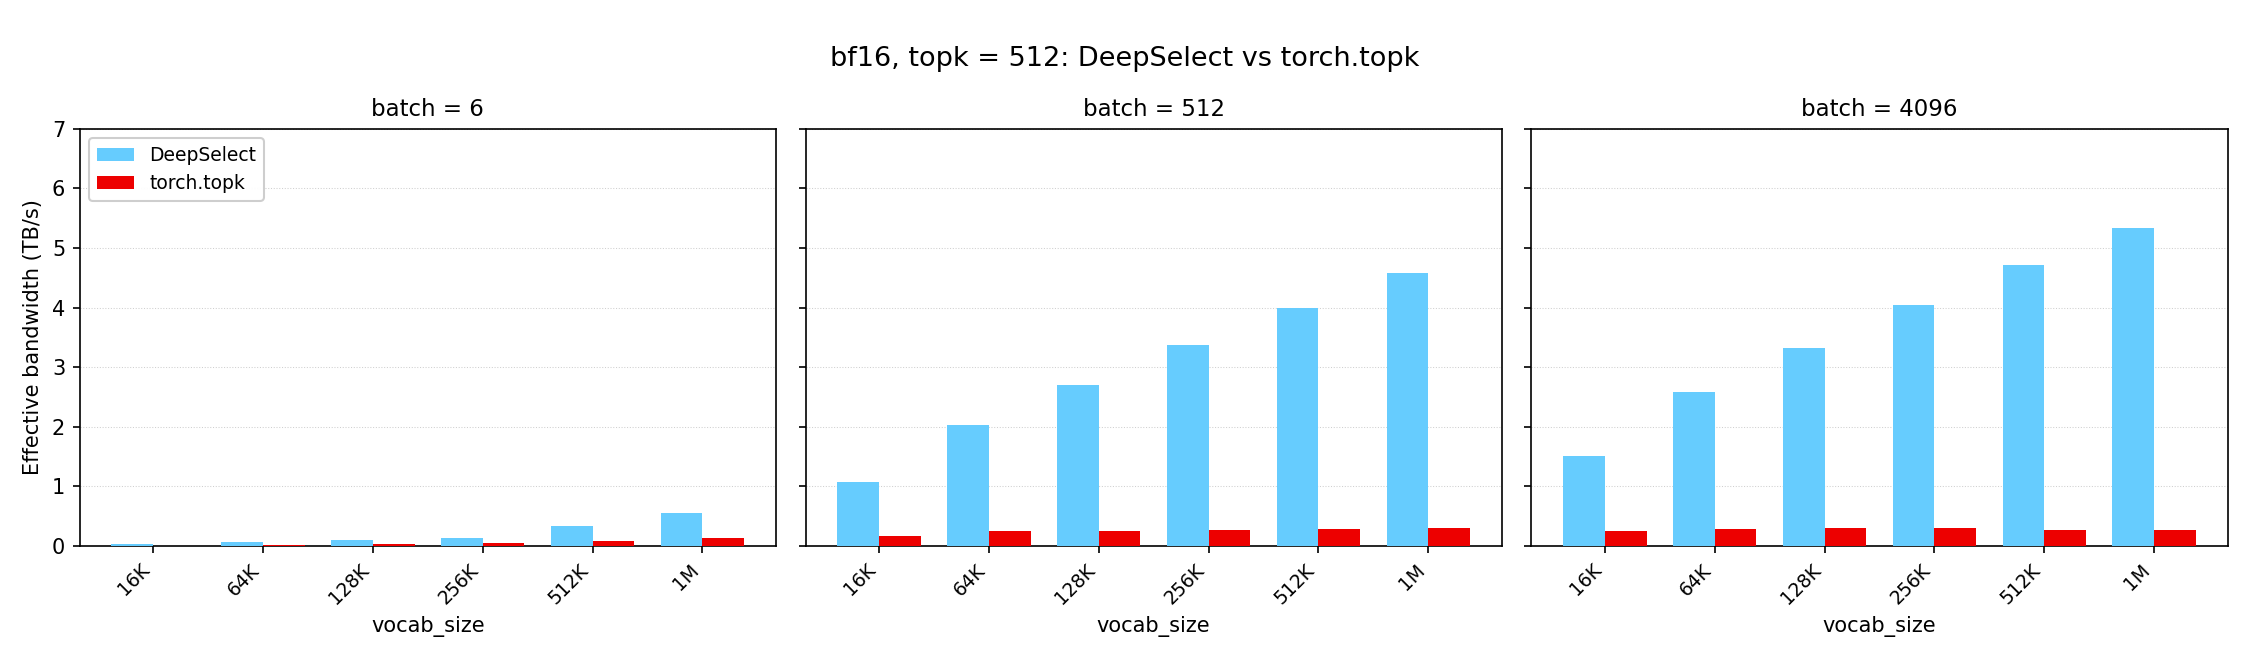
DeepSelect — DeepSeek Sparse Attention va samplingda ishlatiladigan TopK yadrosining yuqori unumdorlikka ega amalga oshirilishi. Loyiha README fayliga ko‘ra, kutubxona qo‘llab-quvvatlaydigan ish yuklamalarida u oddiy torch.topk bilan solishtirganda 2–20 baravar tezlashuvni ta’minlay oladi.
Har qanday TopK konfiguratsiyasini optimallashtirishga urinish o‘rniga, DeepSelect ikkita holatga e’tibor qaratadi: torch.bfloat16 kirishlaridan foydalanadigan Lightning Indexer ish yuklamasi va torch.float32 kirishlaridan foydalanadigan sampling ish yuklamasi.
Qo‘llab-quvvatlanadigan ish yuklamalari
Lightning Indexer holati
- Kirish turi:
torch.bfloat16 - Batch hajmi: 1 dan boshlab, kichik va katta batchlar uchun optimallashtirilgan
- Lug‘at hajmi: 1 dan boshlab, kichik va katta lug‘atlar uchun optimallashtirilgan
- TopK hajmi: kichik va
4096dan katta emas
Yaxshiroq unumdorlik uchun natijalarni tartiblash zarur bo‘lmasa, sorted_index parametrini o‘chirilgan holda qoldiring. Qiymatlar kerak bo‘lmasa, ularni chiqarishni o‘tkazib yuborish uchun return_value=False ni belgilang.
Sampling holati
- Kirish turi:
torch.float32 - Batch hajmi: 1 dan boshlab
- Lug‘at hajmi: taxminan 128K
- TopK hajmi: kichik va
4096dan katta emas
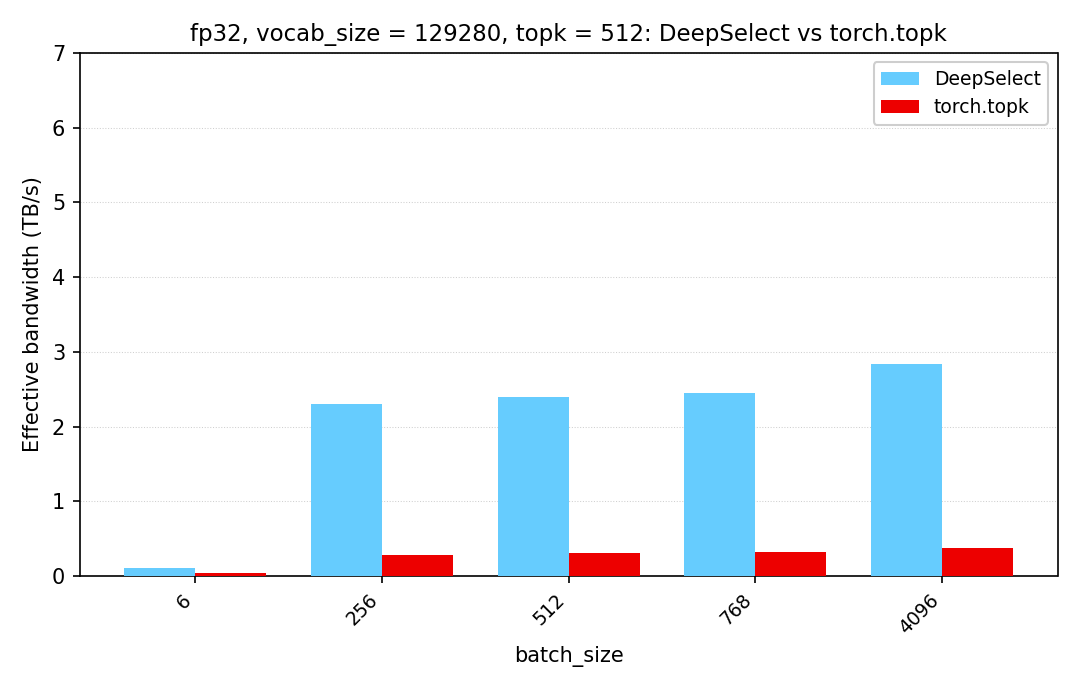
Repository unumdorlikni suzuvchi nuqtali amallar o‘tkazuvchanligi bilan emas, samarali xotira o‘tkazuvchanligi bilan o‘lchaydi, chunki TopK suzuvchi nuqtali arifmetik amallarni bajarmaydi. Uning benchmarki unumdorlikni ayni kirishdagi torch.topk ga nisbatan ko‘rsatadi.
Asosiy imkoniyatlar
- DeepSeek Sparse Attention va sampling ish yuklamalari uchun maxsus TopK yadrolari
- Tegishli maqsadli holatlarda
torch.bfloat16vatorch.float32kirishlarini qo‘llab-quvvatlash torch.int32yokitorch.int64indeks chiqishini sozlash- Faqat indekslar kerak bo‘lganda ortiqcha xarajatni kamaytirish uchun ixtiyoriy qiymat chiqishi
- Har bir qator uchun eksklyuziv yuqori chegara orqali o‘zgaruvchan uzunlikdagi qatorlar
- Indekslar uchun foydalanuvchi boshqaradigan chiqish buferlari
- O‘rnatilgan NaN tekshiruvi
O‘rnatish
Repositoryni klonlang, uning submodullarini ishga tushiring va paketni loyiha katalogidan o‘rnating:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
Misollarda CUDA tensorlaridan foydalaniladi, shuning uchun kirishlarni device="cuda" da yarating.
TopK dan asosiy foydalanish
PyTorch va DeepSelect ni import qiling, ikki o‘lchamli kirish tensorini yarating va deep_select.topk ni chaqiring:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
Kirish (batch_size, vocab_size) shakliga ega bo‘lishi kerak. Uning oxirgi o‘lchami uzluksiz bo‘lishi, qator stride’i esa deep_select.get_stride_requirement()[0] baytning karrali qiymati bo‘lishi kerak.
Qaytariladigan qiymatlar x bilan bir xil ma’lumot turiga ega bo‘ladi. Indekslar indices_type orqali tanlangan turdan foydalanadi; bu torch.int32 yoki torch.int64 bo‘lishi mumkin. sorted_index=True bo‘lganda, har bir qatordagi qaytarilgan indekslar o‘sish tartibida joylashtiriladi.
Faqat indekslarni qaytarish
Agar keyingi kodga tanlangan qiymatlar kerak bo‘lmasa, qiymat chiqishini o‘chiring:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README faylida qiymat chiqishini o‘tkazib yuborish taxminan 10% tezroq ekani qayd etilgan. Tartiblash talab qilinmasa, tartiblangan chiqishni so‘rashdan saqlaning, chunki tartiblash qo‘shimcha xarajat keltirib chiqaradi.
Stride tekislanishini boshqarish
DeepSelect kirish va chiqish qatorlariga tekislanish talablari qo‘yadi. Ularni ish vaqtida tekshiring:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
Agar kirish qatorining stride’i talab qilinadigan kirish tekislanishining karrali qiymati bo‘lmasa, tensorni DeepSelect ga uzatishdan oldin to‘ldiring. Oxirgi o‘lcham uzluksiz bo‘lib qolishi kerak.
DeepSelect sukut bo‘yicha ikkala chiqishni ham ajratadi. Ularning stride’lari deep_select.get_stride_requirement()[1] baytga tekislanadi, shu sababli qaytarilgan tensorlar uzluksiz bo‘lmasligi mumkin. Chiqishlardan foydalanadigan kod standart uzluksiz stride’lar mavjud deb hisoblamasligi kerak.
Mavjud indeks buferidan foydalanish
Indekslarni chaqiruvchi boshqaradigan buferga yozish kerak bo‘lganda, API output_idx= parametrini qabul qiladi. Bu bufer bir xil chiqish stride talablariга javob berishi kerak. Maxsus buferni sozlashdan oldin funksiyaning to‘liq imzosini deep_select/interface.py faylidan ko‘ring.
O‘zgaruvchan uzunlikdagi qatorlar bilan ishlash
Har bir qator uchun eksklyuziv yuqori chegarani belgilash uchun end dan foydalaning. Bu bir xil batch ichidagi qatorlar turli yaroqli uzunliklarga ega bo‘lganda foydalidir:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
Bu yerda birinchi qator barcha 129280 ta elementdan foydalanishi mumkin, ikkinchi qator esa dastlabki 100000 ta element bilan cheklanadi. Agar qator so‘ralgan TopK hajmidan qisqa bo‘lsa, DeepSelect chiqishlarini value_oob_fill_value va idx_oob_fill_value bilan to‘ldiradi.
NaN bilan ishlash
NaN tekshiruvi har doim yoqilgan. Standart holatda abort_when_nan_found=True bo‘ladi, shuning uchun yadro NaN aniqlaganida trap() funksiyasini chaqiradi va ishni to‘xtatadi. Yaroqli uzunligi so‘ralgan TopK hajmiga teng yoki undan kichik bo‘lgan qatorlarda NaN tekshirilmaydi.
Agar NaN qiymatlar bo‘lishi mumkin bo‘lsa, ayniqsa standart to‘xtatish xatti-harakati saqlanganda, yadroni ishga tushirishdan oldin kirish ma’lumotlarini tekshiring yoki tozalang.
Unumdorlik va ilg‘or maslahatlar
- Qo‘llab-quvvatlanadigan TopK diapazonida qoling. DeepSelect kichik TopK qiymatlarini, jumladan
4096gacha bo‘lgan qiymatlarni qo‘llab-quvvatlaydi. Kattaroq qiymatlar qo‘llab-quvvatlanmaydi. - Mo‘ljallangan ish yuklamasiga moslang. Loyiha tavsiflagan Lightning Indexer ssenariysi uchun
torch.bfloat16dan, namuna olish ssenariysi uchun esatorch.float32dan foydalaning. - Iloji bo‘lsa, saralashni o‘tkazib yuboring. Indeks yoki qiymat bo‘yicha tartiblash unumdorlikka ta’sir qiladi, shuning uchun uni faqat keyingi ishlov berish talab qilganda so‘rang.
- Iloji bo‘lsa, qiymatlarni o‘tkazib yuboring. Faqat indekslardan foydalanilsa,
return_value=Falseni o‘rnating. - Tekislashni erta tekshiring. Mos kelmaydigan tensorlarni unumdorlik muhim bo‘lgan siklda tuzatish o‘rniga tensor shakllari va to‘ldirishni
get_stride_requirement()asosida rejalashtiring. - Chiqishlar uzluksiz bo‘ladi deb taxmin qilmang. DeepSelect chiqish qatorlarining stride qiymatlarini tekislaydi, natijada olingan tensorlar uzluksiz bo‘lmasligi mumkin.
- Haqiqiy shaklni sinang. TopK unumdorligi kirish turi, batch hajmi, lug‘at hajmi va TopK hajmiga bog‘liq. Ilova ishlatadigan aniq konfiguratsiyani sinang.
Taqdim etilgan benchmarkni ishga tushirish
Repozitoriy test skriptida unumdorlik rejimini o‘z ichiga oladi:
python3 tests/test.py --perf-onlyBu benchmark bir xil kirish ma’lumotlarida DeepSelect va torch.topk ni taqqoslaydi hamda samarali xotira o‘tkazuvchanligi yordamida nisbatni hisobot qiladi.
Xulosa
DeepSelect mos keluvchi DeepSeek Sparse Attention va namuna olish ish yuklamalari uchun maxsus TopK yadrolarini taqdim etadi. Tekislangan ikki o‘lchamli CUDA tensoridan boshlang, topk qiymatini 4096 yoki undan kichik saqlang va zarur bo‘lmaganda saralash yoki qiymat chiqarishni o‘chiring. Ishlab chiqarish integratsiyasida stride talablarini tekshiring, uzluksiz bo‘lmasligi mumkin bo‘lgan chiqishlarni hisobga oling va ilovangiz foydalanadigan aniq tensor shakllarini sinang.