

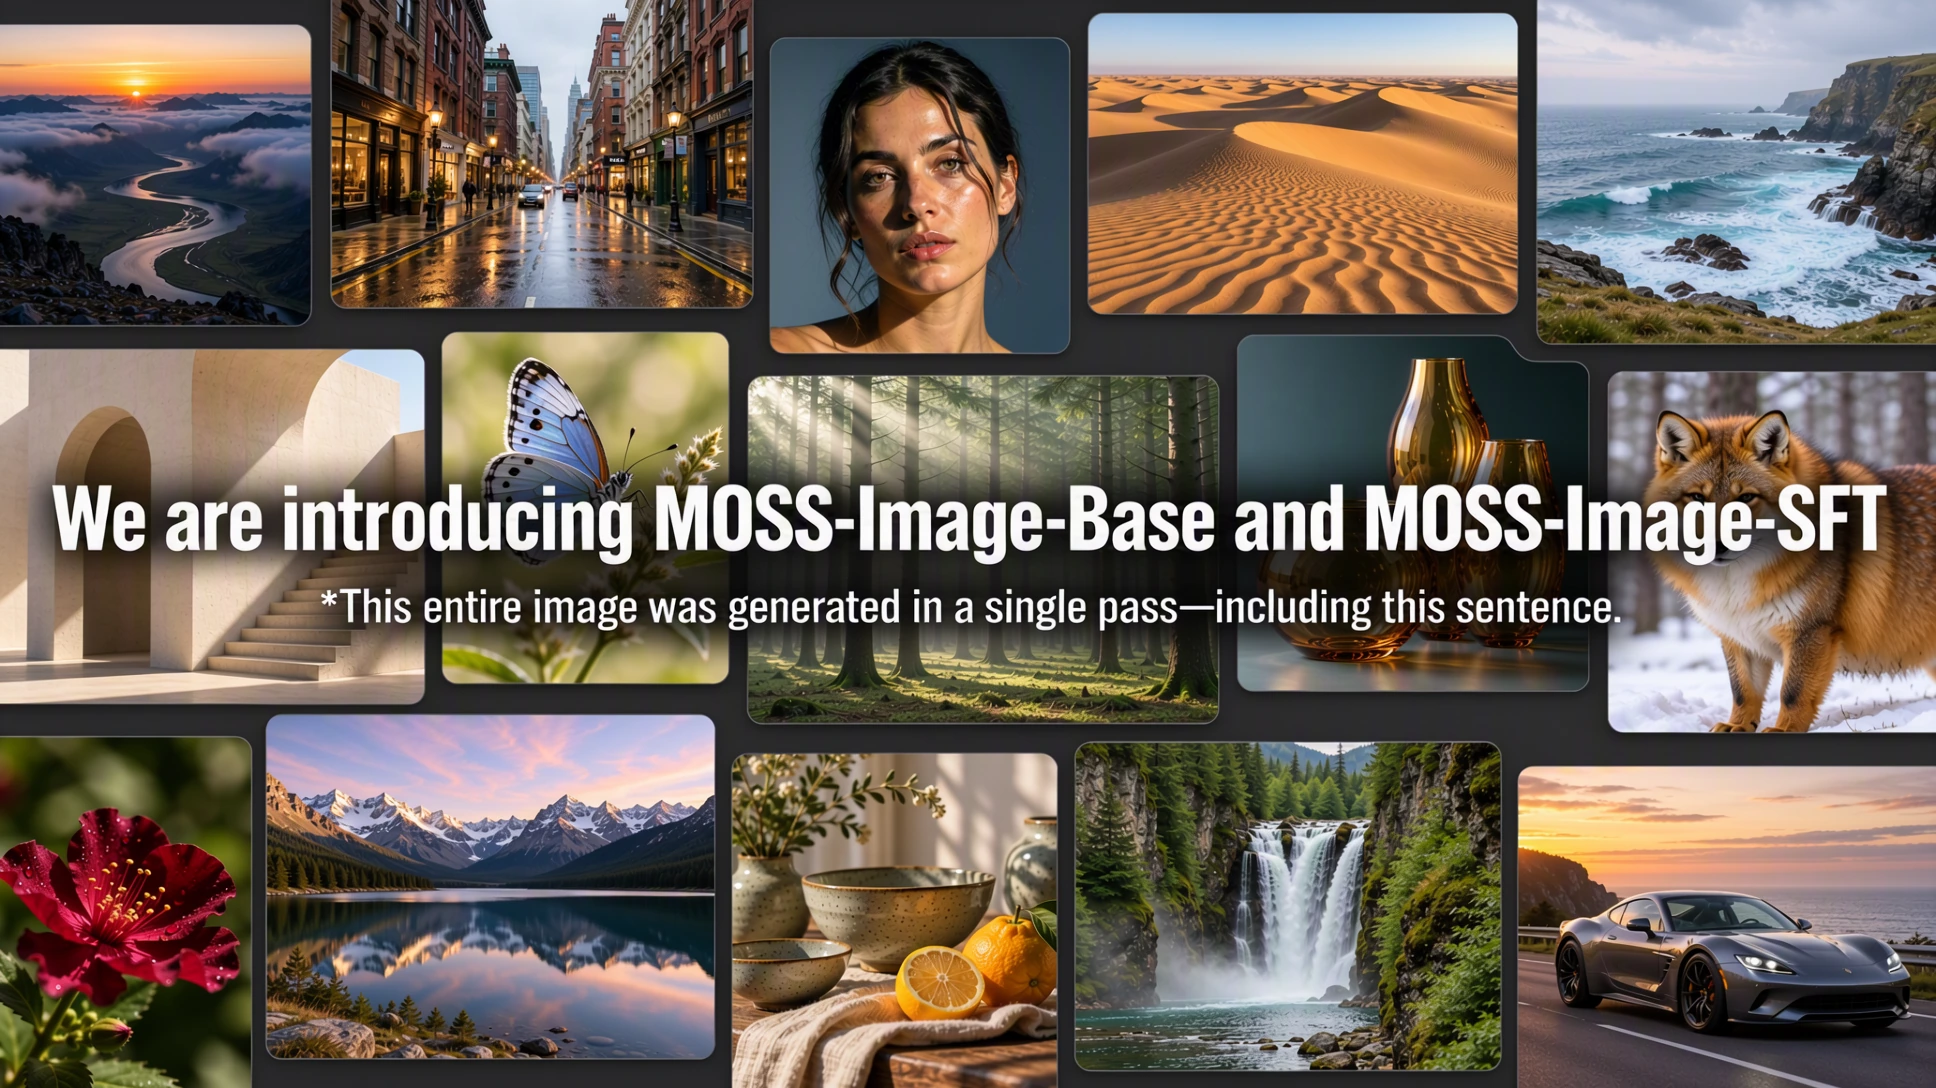
MOSS-Image nima?
MOSS-Image — OpenMOSS jamoasi tomonidan yaratilgan ochiq tasvir generatsiyasi loyihasi. U asosiy matndan tasvir yaratish modeli va nazorat ostida nozik sozlangan modelni, shuningdek, maxsus Diffusers pipeline'ini, Gradio interfeysini, mahalliy ComfyUI plaginini hamda batafsil promptlar tayyorlash vositalarini taqdim etadi.
Loyiha tasviriy elementlarni o‘qilishi mumkin bo‘lgan matn bilan birlashtiruvchi kompozitsiyalar uchun mo‘ljallangan. U 4K gacha tokenlardan iborat promptlarni qo‘llab-quvvatlaydi va animedan fotorealistik tasvirlargacha bo‘lgan uslublarni yaratishi mumkin. Uning 5B asosiy arxitekturasi nisbatan ixcham va samarali tasvir generatsiyasini ta’minlashga mo‘ljallangan.
Asosiy imkoniyatlar
- Joylashuvni boshqarish: Tuzilgan JSON kiritmasi va chegaralovchi qutilar yordamida matn hamda tasviriy elementlarni joylashtiring.
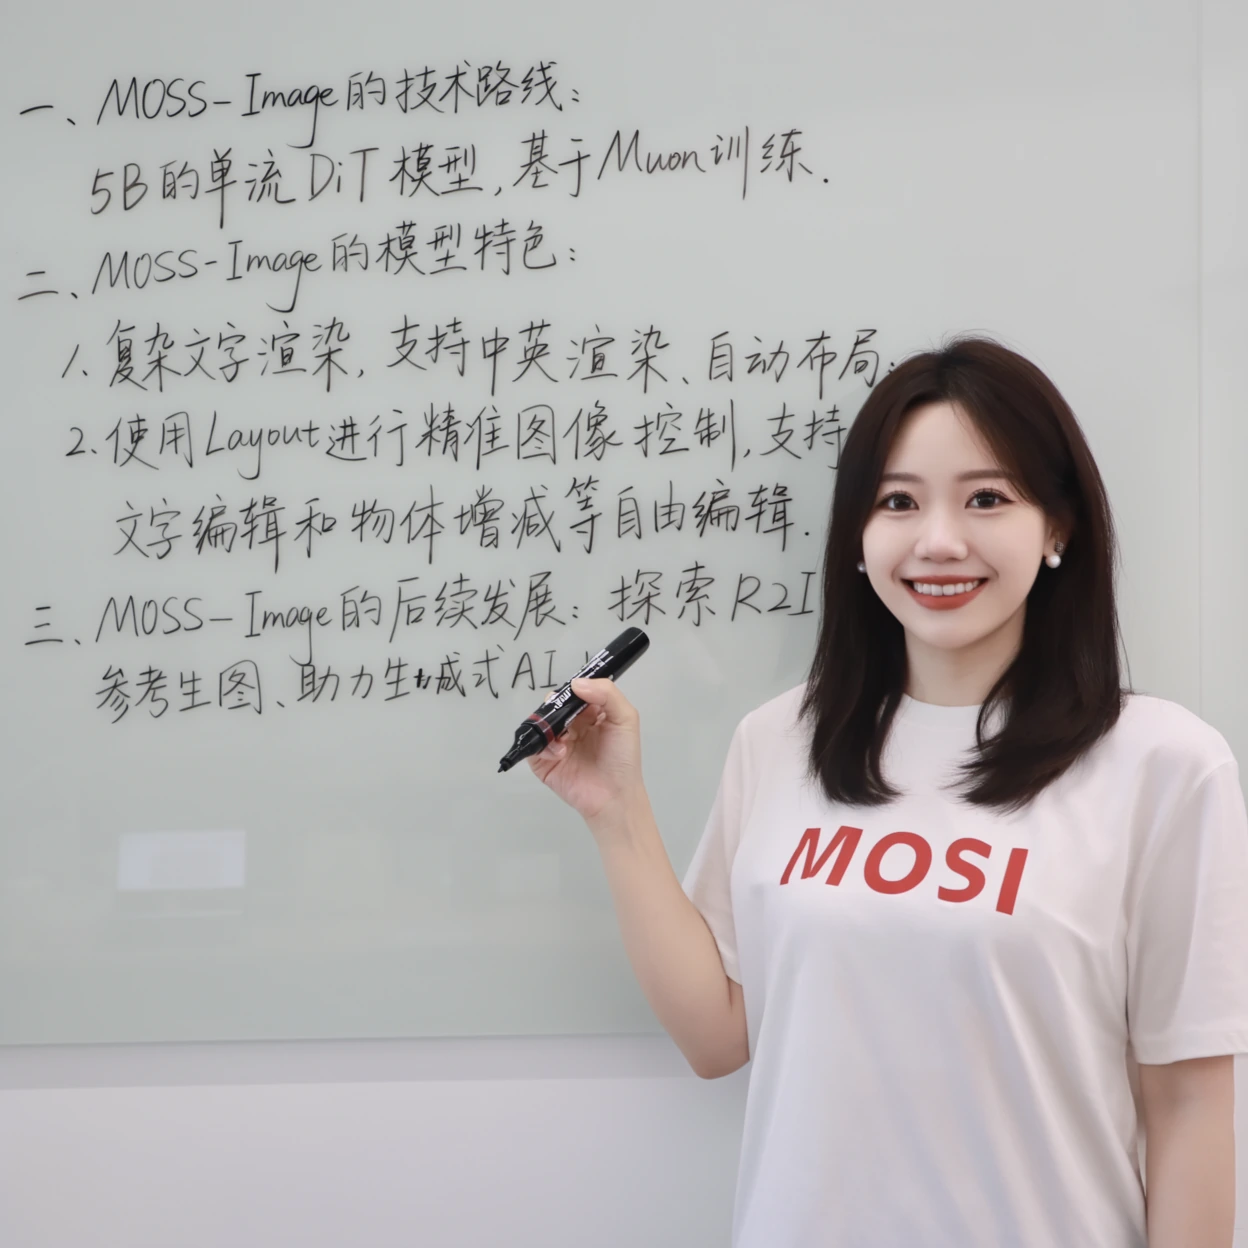
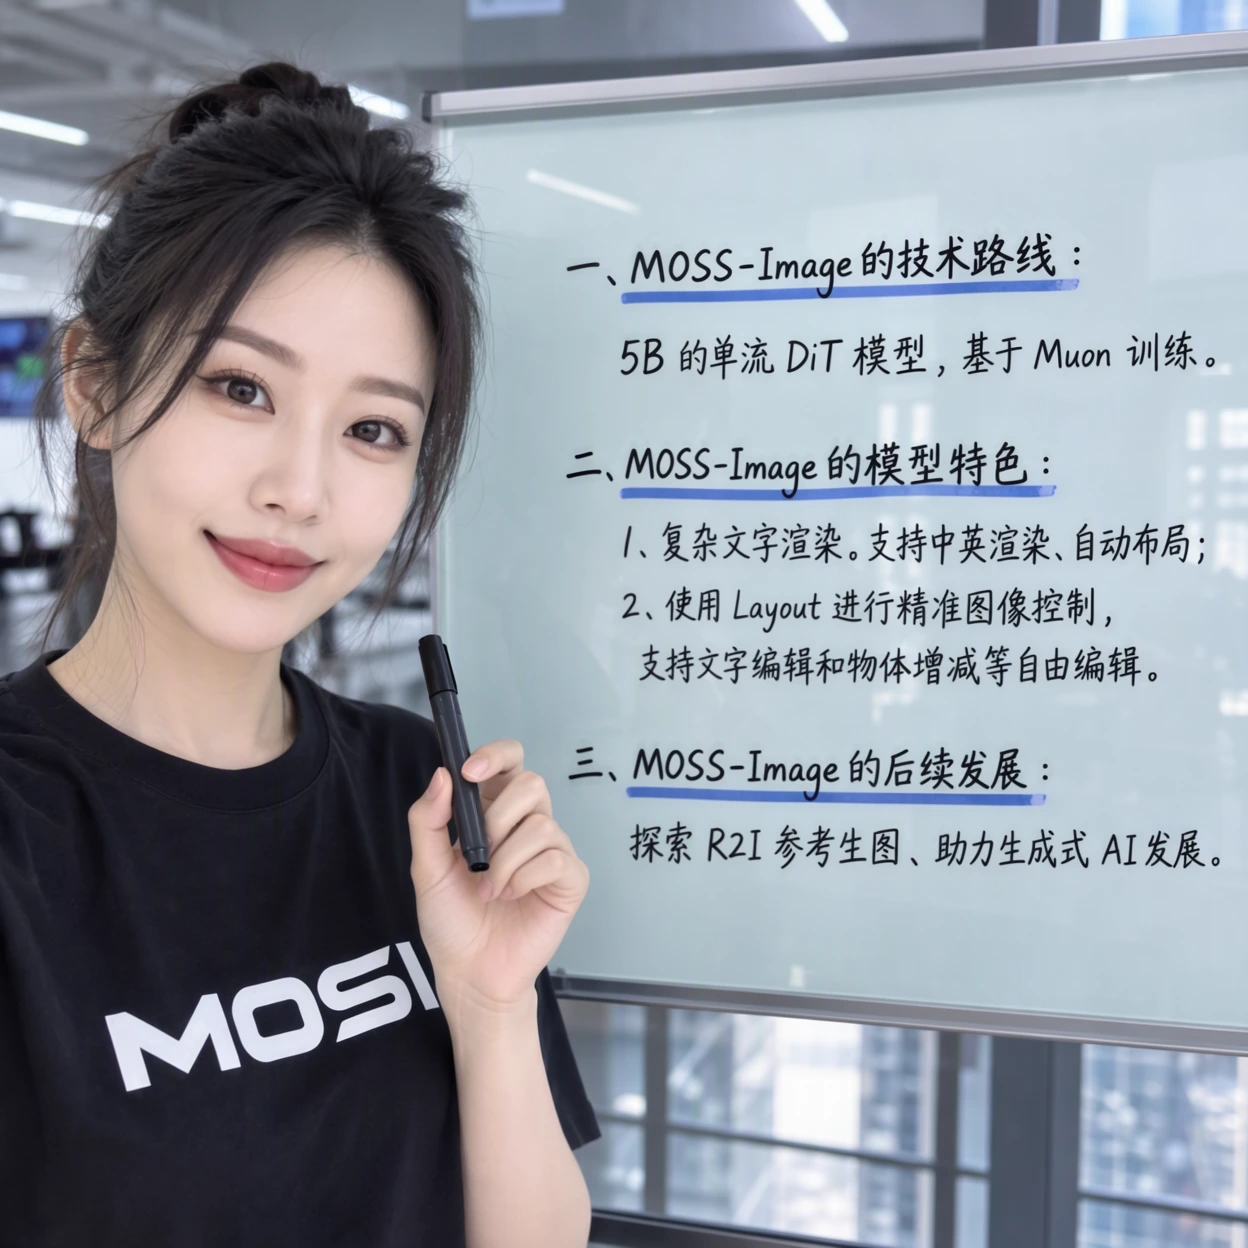
- Matnni tasvirlash: Plakatlar, qaydlar, doskalar va boshqa tasvir kompozitsiyalari ichida aniq matn yarating.
- Uzun promptlar: 4K gacha tokenlardan iborat matnli promptlarni yuboring.
- Bir nechta uslub: Anime uslubidagi va fotorealistik tasvirlar yarating.
- Nozik sozlashni qo‘llab-quvvatlash: Asosiy modelni maxsus vazifalar va sohalarga moslang.
- Samarali arxitektura: 5B asosiy arxitektura yordamida tasvirlar yarating.
- Bir nechta interfeys: Python, Gradio, ComfyUI yoki alohida prompt-enhancer ko‘nikmasidan foydalaning.
Modelni tanlang
MOSS-Image ikki xil variantda mavjud:
- MOSS-Image-Base: Asosiy matndan tasvir yaratish modeli. Uning og‘irliklari Hugging Face va ModelScope'da mavjud.
- MOSS-Image-SFT: Saralangan ma’lumotlar asosida asosiy modeldan nozik sozlangan versiya. Uning og‘irliklari Hugging Face va ModelScope'da mavjud.
Loyiha taqdim etgan taqqoslashda SFT modeli aniqroq matn guruhlanishi va tartibliroq doska joylashuvini yaratadi. Asl umumiy maqsadli checkpoint kerak bo‘lsa yoki uni nozik sozlashni rejalashtirsangiz, Base modelidan boshlang. Tuzilgan matn taqdimoti ayniqsa muhim bo‘lsa, SFT modelini tanlang.
MOSS-Image'ni o‘rnating
Repozitoriyni klonlang, uning katalogiga kiring, virtual muhit yarating, uni faollashtiring va talablarni o‘rnating:
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python -m venv .venv
source .venv/bin/activate

pip install -r requirements.txt
Misollarda CUDA ishlatiladi va pipeline pipe.to("cuda") yordamida GPU'ga ko‘chiriladi. Inference'ni ishga tushirmoqchi bo‘lgan GPU platformasi uchun PyTorch muhitingiz sozlanganiga ishonch hosil qiling.
Python yordamida tasvir yarating
MOSS-Image Diffusers orqali o‘zining maxsus pipeline'i yordamida yuklanadi. Quyidagi misol modeldan qo‘lda yozilgan xitoycha eslatma mavjud oshxona sahnasini yaratishni so‘raydi:
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-Base",
    custom_pipeline="pipeline_moss_image",
    trust_remote_code=True,
    torch_dtype={"default": torch.bfloat16, "vae": torch.float32},
)
pipe.scheduler = type(pipe.scheduler).from_config(pipe.scheduler.config)
pipe.to("cuda")

prompt = (
    "A wide view of a refrigerator beside a kitchen counter with a fruit bowl. "
    "A small sticky note on the refrigerator door is handwritten in Chinese:“\n"
    "记得买牛奶和鸡蛋!\n牛奶两盒,鸡蛋一打。\n顺便带一袋面包。”"
)

image = pipe(
    prompt,
    height=1456,
    width=1456,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("refrigerator_note.png")
Muhim argumentlarni tushuning
custom_pipeline="pipeline_moss_image"MOSS-Image pipeline'ini tanlaydi.trust_remote_code=TrueDiffusers'ga modelning maxsus pipeline implementatsiyasini yuklashga ruxsat beradi.torch_dtypesukut bo‘yicha bfloat16'dan foydalanadi, VAE uchun esa float32'ni saqlab qoladi.heightvawidthchiqish o‘lchamlarini belgilaydi.num_inference_steps=50loyiha tavsiya qilgan standart sampling sozlamasidan foydalanadi.guidance_scale=3.0tavsiya etilgan classifier-free guidance qiymatini qo‘llaydi.uncond_skip_layers=[22]22-qavatda manfiy tarmoq qatlamini tashlab ketishni yoqadi.manual_seed(42)bir xil konfiguratsiya bilan takroriy ishga tushirishlarni yanada takrorlanuvchan qiladi.
Gradio interfeysini ishga tushiring
Ixtiyoriy foydalanuvchi interfeysi bog‘liqliklarini o‘rnating va qo‘shilgan dasturni ishga tushiring:
pip install -e '.[ui]'
python gradio_app.py --model OpenMOSS-Team/MOSS-Image-Base
Gradio ko‘rsatgan mahalliy manzilni oching, ijobiy prompt kiriting, tasvir o‘lchamlarini tanlang va generatsiyani boshlang. Nozik sozlangan checkpointni sinash uchun model argumentini OpenMOSS-Team/MOSS-Image-SFT bilan almashtiring.
Tavsiya etilgan sampling sozlamalari
- Sampler: Flow-matching Euler
- Qadamlar: 50
- CFG: 3
- Shift: 5
- Qatlamlarni tashlab ketish: 22-qavatdagi manfiy tarmoqni tashlab ketish
- Python API manfiy prompti: Bo‘sh
Bular loyihada hujjatlashtirilgan standart sozlamalar bo‘lib, amaliy boshlang‘ich nuqtani taqdim etadi. Qo‘shimcha prompt va sampling tavsiyalari uchun repozitoriyning ingliz tilidagi foydalanuvchi qo‘llanmasi bilan tanishing.
JSON maketlari yordamida kompozitsiyani boshqaring
Oddiy promptlar tasvirda nimalar bo‘lishi kerakligini tasvirlaydi, ammo har bir element qayerda joylashishini aniq belgilamaydi. Buning o‘rniga MOSS-Image umumiy sahna, alohida matn yoki obyekt elementlari hamda ularning chegaralovchi qutilarini tasvirlaydigan JSON maketini qabul qilishi mumkin.
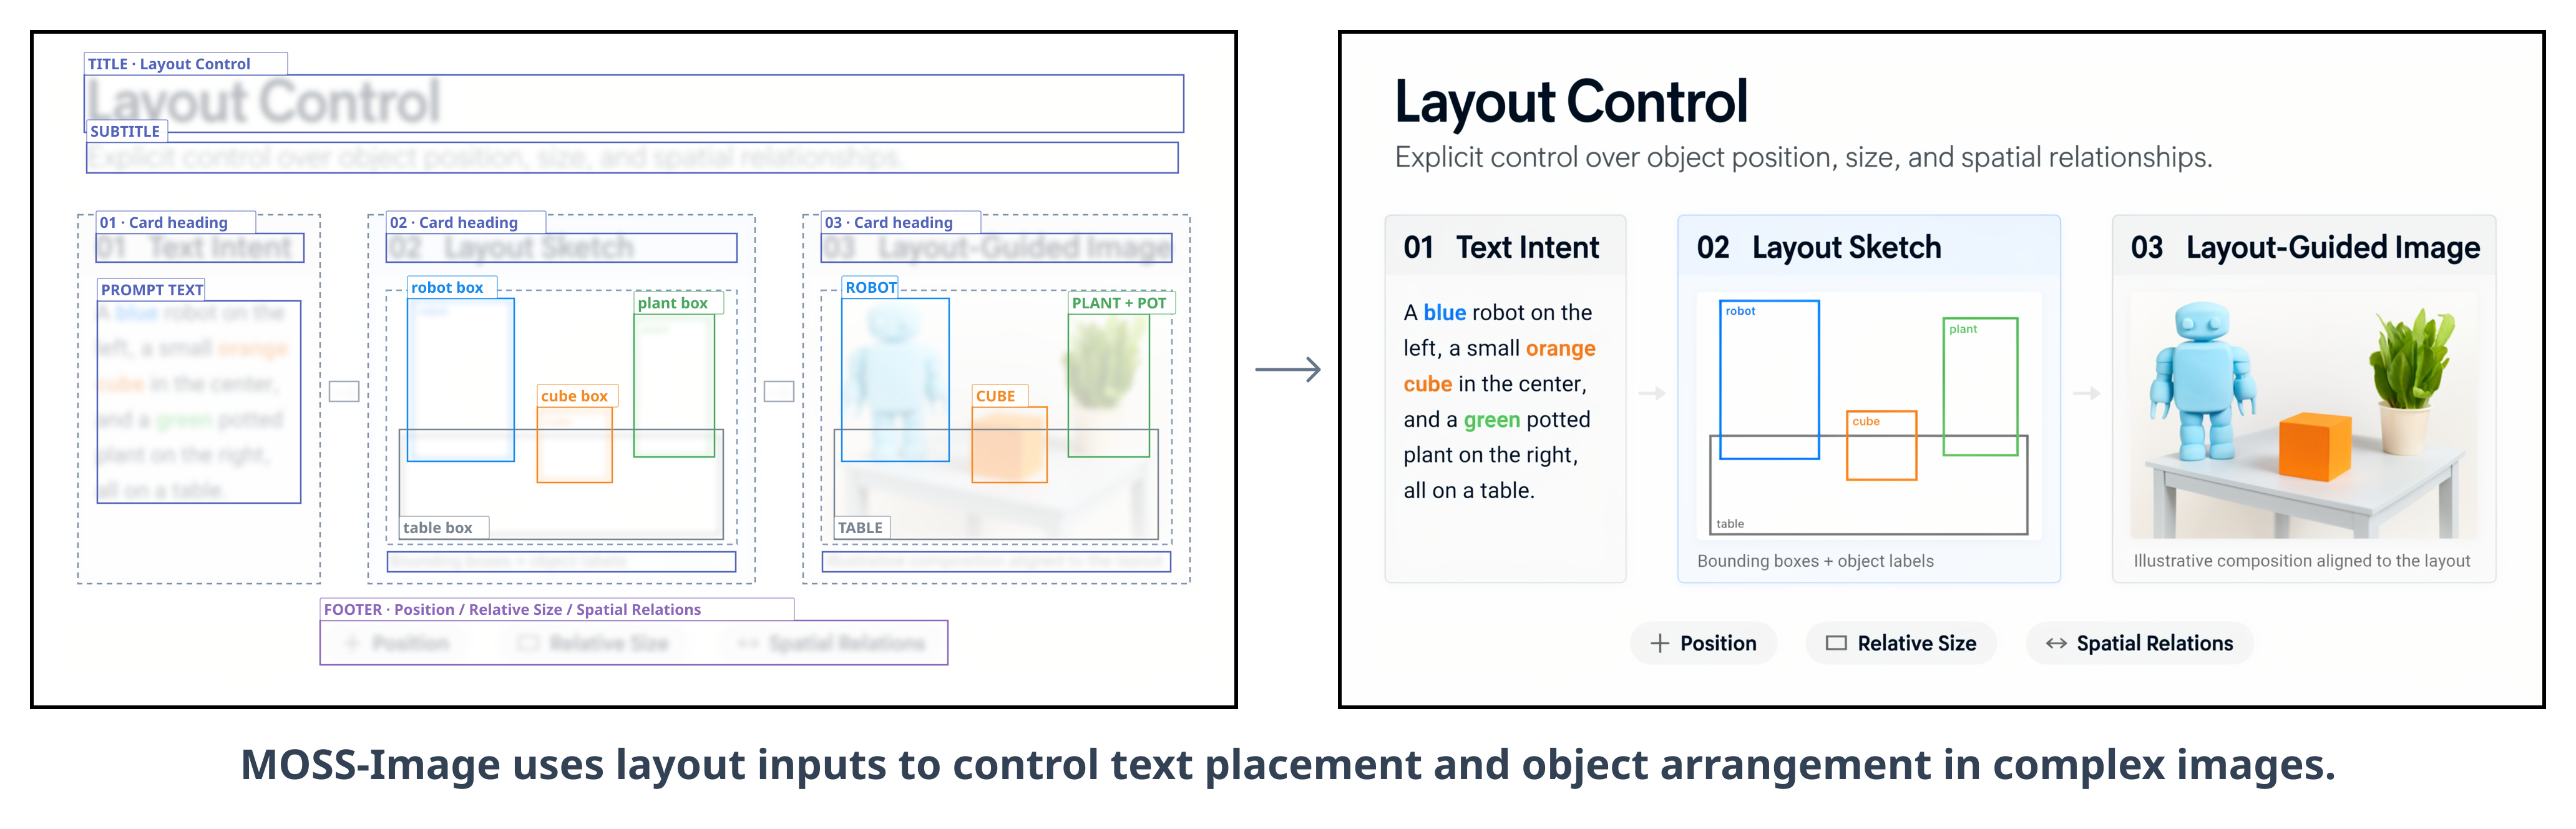
Quyidagi maket krem rangli fon, ko‘k tog‘ tasviri va yuqorida joylashgan EXPLORE sarlavhasiga ega minimalist 1024 ga 1024 o‘lchamli sayohat posterini tasvirlaydi. Uni Python orqali yuklamoqchi bo‘lsangiz, layout.json nomi bilan saqlang yoki to‘g‘ridan-to‘g‘ri Gradio’ning Prompt maydoniga joylashtiring.
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "Krem rangli fon, ko‘k tog‘ tasviri va yuqorida EXPLORE sarlavhasiga ega minimalist sayohat posteri."
  },
  "items": [
    {
      "label": "text",
      "caption": "Yuqorida markazlashtirilgan katta, to‘q ko‘k rangli bosh harflardagi sarlavha.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "Pastki markazda joylashgan yassi ko‘k tog‘ tasviri.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Maket formati qanday ishlaydi
summary.captionto‘liq sahna va uning vizual uslubini tasvirlaydi.itemsmustaqil joylashtiriladigan matn va obyekt elementlarini o‘z ichiga oladi.labelelementni matn yoki obyekt sifatida belgilaydi.captionelementning ko‘rinishi va vazifasini tasvirlaydi.textmatn elementi ko‘rsatishi kerak bo‘lgan aniq so‘zlarni o‘z ichiga oladi.bboxelementning joylashuvi va o‘lchamini belgilaydi.bbox_format: "yxyx"har bir quti[y_min, x_min, y_max, x_max]tartibida berilishini anglatadi.bbox_coord_space: "abs_centralized"koordinatalar canvas markazidan hisoblanishini anglatadi.
1024 ga 1024 o‘lchamli canvasda ikkala o‘q ham -512 dan +512 gacha davom etadi. x koordinatasi o‘ng tomonga, y koordinatasi esa pastga qarab ortadi. Oddiy canvas koordinatalarini o‘girish uchun x qiymatlaridan canvas kengligining yarmini, y qiymatlaridan esa canvas balandligining yarmini ayiring.
Har doim maket tayyorlangan o‘lchamlarga mos generatsiya o‘lchamlaridan foydalaning. O‘lchamlar mos kelmasa, koordinatalar tizimi o‘zgaradi va elementlar mo‘ljallangan joyidan siljishi mumkin.
Python orqali maket yuborish
JSON faylini yuklang, uni satr sifatida serializatsiya qiling va shu satrni pipeline prompti sifatida uzating:
import json
import torch

with open("layout.json", "r", encoding="utf-8") as file:
    layout = json.load(file)

layout_prompt = json.dumps(layout, ensure_ascii=False)

image = pipe(
    layout_prompt,
    height=1024,
    width=1024,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("travel_poster.png")
To‘liq promptni qayta yozmasdan kompozitsiyani o‘zgartirishingiz mumkin. Element matni, izohi yoki chegaralovchi qutisini tahrirlang va tasvirni qayta generatsiya qiling. README’da ushbu tuzilmali yondashuv boshqariladigan tahrirlash va foydalanuvchiga qulay maket vositalarini ham qo‘llab-quvvatlashi mumkinligi qayd etilgan.
GPU xotirasini boshqaring
Gradio interfeysi Advanced sozlamalarida uchta xotira rejimini taqdim etadi:
- GPU resident: To‘g‘ridan-to‘g‘ri foydalanish uchun modelni to‘liq GPU’da saqlaydi.
- Component: Zaruratga ko‘ra model komponentlarini CPU va GPU o‘rtasida ko‘chiradi.
- Sequential fallback: Inference jarayonini sekinlashtirish evaziga xotira sarfini kamaytiradi.
Agar model mavjud GPU xotirasiga sig‘masa, Sequential rejimini tanlang yoki chiqish tasviri o‘lchamini kamaytiring. DiT kompilyatsiyasi sukut bo‘yicha o‘chirilgan va Sequential rejimida mavjud emas.
MOSS-Image’dan ComfyUI bilan foydalaning
Repozitoriy ComfyUI uchun mahalliy MOSS-Image plaginini o‘z ichiga oladi. Uni o‘rnatish uchun ComfyUI Manager’da MOSS-Image nomini qidiring. Loyiha boshlang‘ich nuqta sifatida import qilinishi mumkin bo‘lgan namunaviy workflowni ham taqdim etadi.
Loyiha hozirda rasmiy ComfyUI repozitoriysiga integratsiya qilish ustida ishlamoqda. Ungacha repozitoriyning ComfyUI’ni o‘rnatish va undan foydalanish bo‘yicha ko‘rsatmalariga amal qiling.
Prompt Enhancer yordamida ilg‘or prompting
To‘plamga kiritilgan MOSS-Image Prompt Enhancer oddiy tasvir g‘oyasini batafsil izoh yoki fazoviy maket promptiga aylantiradi. U mahalliy fayl va Python vositalariga ega GPT-6 oilasidagi agentlar uchun ishlab chiqilgan.
skills/moss-image-prompt-enhancerjildini agentingizning skills katalogiga o‘rnating.- Tasvir g‘oyasi bilan
$moss-image-prompt-enhancerni ishga tushiring. - Batafsil izoh yoki Layout chiqishini xohlashingizni belgilang.
- Maket yaratishda mo‘ljallangan canvas o‘lchamlarini ko‘rsating.
- Kompilyatsiya qilingan chiqishni MOSS-Image’ning positive prompt maydoniga joylashtiring.
- Layout chiqishi uchun tasvirni kompilyatsiya paytida ishlatilgan canvas o‘lchamlari bilan bir xil o‘lchamda generatsiya qiling.
Qo‘shilgan skript piksel koordinatalaridagi eskizlarni markazlashtirilgan butun sonli koordinatalardan foydalanadigan ixcham JSON formatiga aylantiradi. U faqat promptlarni tayyorlaydi va tasvir yaratish xizmatiga murojaat qilmaydi.
Amaliy maslahatlar
- Hujjatlashtirilgan standart qiymatlardan boshlang: Tajriba o‘tkazishdan oldin 50 qadam, CFG 3, shift 5 va 22-qatlamda manfiy tarmoqni o‘tkazib yuborishdan foydalaning.
- So‘ralgan matnni aniq ko‘rsating: Promptga yoki elementning
textmaydoniga aynan kerakli matnni kiriting. - Murakkab dizaynlar uchun tuzilmaviy maketlardan foydalaning: Plakatlar, diagrammalar va matni ko‘p sahnalar alohida tavsiflangan elementlar hamda chegaralovchi qutilardan foyda ko‘radi.
- O‘lchamlarni diqqat bilan moslang: Maket koordinatalari tanlangan kanvasning eni va bo‘yiga bog‘langan.
- Takroriy ishlashda seed qiymatini o‘zgartirmang: Bir xil seed qiymatini saqlash prompt, model va maketdagi o‘zgarishlarni taqqoslashga yordam beradi.
- Xotira cheklanganida tasvir hajmini kamaytiring: Bu loyiha tomonidan aniq tavsiya etilgan yechimlardan biridir.
- Base va SFT’ni taqqoslang: Aniqroq guruhlash va tartibliroq matn maketi ustuvor bo‘lsa, SFT checkpointi ma’qulroq bo‘lishi mumkin.
Xulosa
MOSS-Image umumiy matndan tasvir yaratishni kuchli matn renderingi va tuzilmaviy kompozitsiyani boshqarish imkoniyati bilan birlashtiradi. Python pipeline yoki Gradio interfeysidan boshlashingiz, aniq joylashtirish muhim bo‘lganda esa JSON maketlariga o‘tishingiz mumkin. ComfyUI integratsiyasi, xotira rejimlari va prompt-enhancer ko‘nikmasi modelni vizual ish jarayonlariga moslashtirishning qo‘shimcha usullarini taqdim etadi. Mustaqil pipeline kodi Apache License 2.0 ostida mavjud.