

Tiny Classifiers nima qiladi
tiny-classifiers kichik, muayyan vazifaga mo‘ljallangan matn klassifikatorlarini o‘qitish uchun amaliy retseptdir. U 17 million parametrli Ettin-17M encoder modelidan foydalanadi, uning barcha og‘irliklarini fine-tuning qiladi va natijani standart Hugging Face modeli sifatida saqlaydi.
Loyiha bank xabarlarini yo‘naltirish, yangiliklarni toifalash, foydalanuvchi maqsadini aniqlash, sentimentni aniqlash yoki huquqiy hujjatlarni oldindan belgilangan toifalarga ajratish kabi klassifikatsiya vazifalari uchun mo‘ljallangan. Agar sizda yetarli darajada belgilangan namunalar bo‘lmasa, kattaroq til modeli o‘qituvchi sifatida ishlashi va o‘qitish to‘plamiga belgi qo‘yishi mumkin.
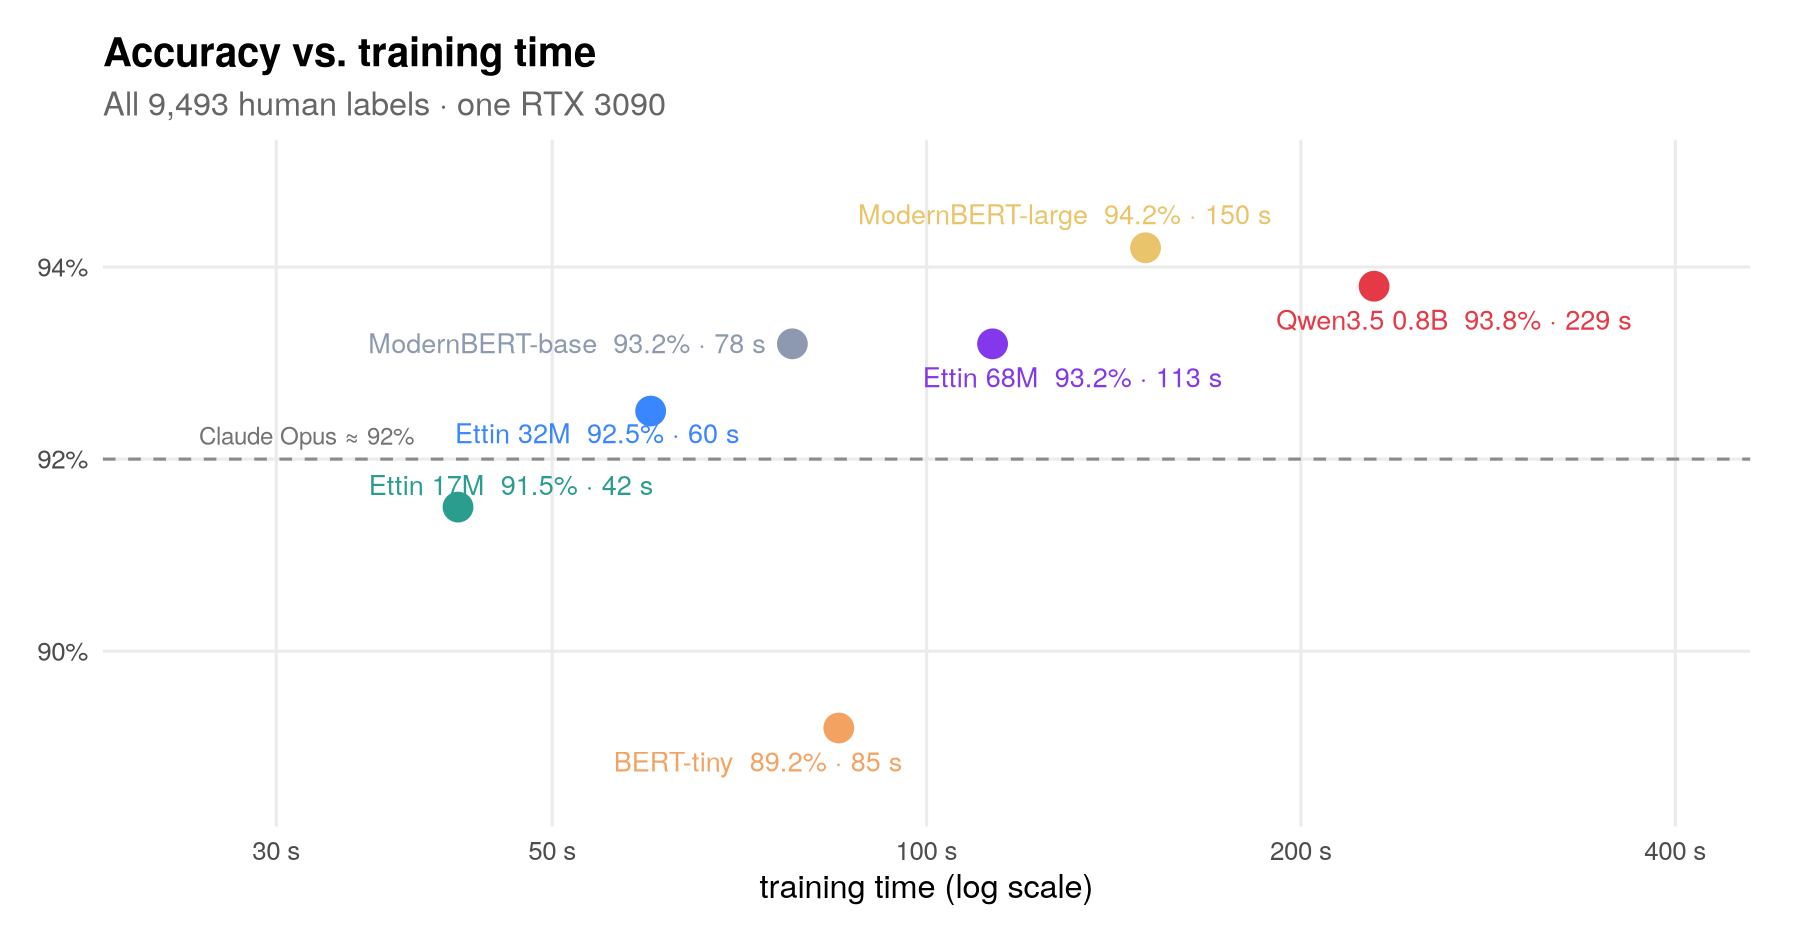
Repositorydagi Banking77 tajribasida Ettin-17M 91.5% aniqlikka erishdi, Claude Opus esa 92% natija ko‘rsatdi. O‘qitish bitta gaming GPU’da 42 soniya davom etdi, inferens esa har bir xabar uchun taxminan 5 millisekund vaqt oldi. O‘qitish noutbuk CPU’sida taxminan 11 daqiqada va telefon GPU’sida taxminan 21 daqiqada ham ishladi.
Banking77 aniqligining o‘qitish vaqti bilan taqqoslanishi.
Asosiy xususiyatlar
- Kichik lokal model: Ettin-17M 17 million parametrga ega va har bir toifa uchun bittadan ball hosil qiladi.
- Inson yoki o‘qituvchi belgilari: Tasdiqlangan belgilar bilan o‘qiting yoki aks holda belgilanmagan xabarlarga Kimi K3 orqali belgi qo‘ydiring.
- GPU va CPU’da o‘qitish: O‘qitish skripti har ikkala muhitni ham qo‘llab-quvvatlaydi.
- Standart model chiqishi: O‘qitilgan klassifikatorlarni Hugging Face
transformerspipeline’i orqali yuklash mumkin. - Davom ettiriladigan belgilash: Belgilash skripti qayta urinishlar, moslashuvchan parallellik, sekin so‘rovlarni zaxira so‘rov bilan qoplash va provayder budjetlarini qo‘llab-quvvatlaydi.
- Ichki baholash: O‘qitish jarayoni test aniqligini hisobot qiladi, o‘qituvchi orqali belgi qo‘yishda esa o‘qituvchining belgilangan test to‘plamidagi aniqligini o‘lchash mumkin.
- Xarajat tahlili: Zararni qoplash skripti belgilash va o‘qitish API orqali klassifikatsiya uchun to‘lashdan qachon arzonroq bo‘lishini taxmin qiladi.
- Qayta ishlatiladigan ma’lumot tayyorlash: Loyiha o‘nta ommaviy klassifikatsiya ma’lumotlar to‘plamini yagona izchil tuzilma yordamida tayyorlay oladi.
O‘qitish retsepti qanday ishlaydi
Ettin-17M Johns Hopkins tomonidan ishlab chiqilgan ochiq encoder bo‘lib, BERT uslubidagi modellar bilan bog‘liq. Matnni tokenma-token hosil qiladigan generativ modeldan farqli ravishda, u to‘liq kirish ma’lumotini o‘qiydi va mavjud har bir toifaga ball belgilaydi.
Repository har bir toifa uchun bittadan chiqish qo‘shadi va modelning barcha og‘irliklarini fine-tuning qiladi. Standart retseptda batch hajmi 32, o‘rganish tezligi 1e-4 bo‘lgan AdamW, 0.01 weight decay, undan keyin cosine decay keladigan 5% warm-up, 1.0 gradient clipping va cross-entropy loss ishlatiladi.
Taxminan 9,500 ta xabar uchun o‘qitish olti marta takrorlanadi. Faqat 2,000 ta misol bilan esa bir xil miqdordagi optimallashtirish qadamlari ishlatiladi, bu taxminan 28 marta takrorlanishga teng. README ushbu sozlamalar har bir vazifa uchun alohida moslashtirilmaganini ta’kidlaydi.
O‘rnatish va sozlash
1. uv’ni o‘rnating
Skriptlar kerakli muhitni yaratish va bog‘liqliklarni birinchi ishga tushirishda avtomatik o‘rnatish uchun uv dasturidan foydalanadi. Operatsion tizimingiz uchun berilgan ko‘rsatmalar orqali uv’ni o‘rnating, so‘ng repository’ning ildiz katalogida terminal oching.
2. Ommaviy ma’lumotlar to‘plamlarini tayyorlang
Tayyorlash skriptini ishga tushiring:
uv run recipe/prepare.pyBu Banking77, CLINC150, ingliz va fransuz tillaridagi MASSIVE, TREC, AG News, SST-5, Financial PhraseBank, LEDGAR hamda Hugging Face Hub’dan tvitlardagi nafrat nutqi ma’lumotlar to‘plamini yuklab oladi.
Har bir vazifa uchun skript data/tasks/ ichida katalog yaratadi. U vazifa ta’rifini, 2,000 ta o‘qitish xabarini, har bir toifa uchun 150 tagacha namunani o‘z ichiga olgan kattaroq o‘qitish bo‘linmasini va test to‘plamini yaratadi.
3. Belgilash provayderini sozlang
Agar o‘qituvchi modeli belgilarni yaratishini istasangiz, qo‘llab-quvvatlanadigan bir yoki bir nechta provayder uchun API kalitini o‘rnating:
export OPENROUTER_API_KEY=...Retsept Fireworks, Together, DeepInfra va Parasail provayderlariga tegishli kalitlarni ham taniydi. Ma’lumot yuborish yoki yaratilgan javoblardan o‘qitish uchun foydalanishdan oldin tegishli provayderning amaldagi narxlari, foydalanish siyosati va model shartlarini tekshiring.
Asosiy qo‘llanma: AG News klassifikatorini o‘qitish
1-qadam: Kimi K3 yordamida belgilar yarating
Ma’lumotlar to‘plamlarini tayyorlaganingizdan so‘ng, 2,000 ta AG News o‘qitish xabariga belgi qo‘ying:
uv run recipe/label.py data/tasks/agnewsHisobot berilgan ishga tushirishda Kimi K3 2,000 ta misolga taxminan 20 soniyada va taxminan $1 xarajat bilan belgi qo‘ydi. Amaldagi vaqt va xarajat provayderga qarab o‘zgarishi mumkin. Skriptni davom ettirish mumkin, shuning uchun uzilib qolgan belgilash ishini boshidan boshlash shart emas.
2-qadam: Ettin-17M’ni o‘qituvchi belgilarida fine-tuning qiling
Yaratilgan belgi faylini o‘qitish skriptiga bering va chiqish katalogini tanlang:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsSkript klassifikatorni fine-tuning qiladi, uni test to‘plamida baholaydi, test aniqligini chiqaradi va Hugging Face bilan mos modelni models/agnews ostida saqlaydi.
3-qadam: Inson belgilari asosidagi bazaviy modelni o‘qiting
Ma’lumotlar to‘plamining asl inson belgilari asosida o‘qitish uchun o‘qituvchi belgisi argumentisiz xuddi shu o‘qitish skriptini ishga tushiring:
uv run recipe/train.py data/tasks/agnewsBu taqqoslash bilim distillatsiyasi jarayonida qancha unumdorlik yo‘qotilganini ko‘rsatishga yordam beradi. Repository’dagi qo‘llanma ishga tushirishida inson belgilari 89.2% aniqlikni, Kimi K3 belgilari 85.1% ni, Qwen3.8-27B belgilari esa 81.8% ni ta’minladi.
4-qadam: Yangi matnni tasniflash
Saqlangan modelni Hugging Face pipeline yordamida yuklang:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
Natija bashorat qilingan yorliq va uning ballini o‘z ichiga olgan ro‘yxatdan iborat. Bu misol uchun kutilayotgan kategoriya Sci/Tech. Hisobotga ko‘ra, AG News modeli xabarni CPU’da taxminan 6 millisekundda qayta ishlagan.
Tiny Classifiers’ni o‘z ma’lumotlaringiz bilan ishlating
1. Vazifa katalogini yarating
data/tasks/agnews/ bilan bir xil tuzilishga ega jild yarating. Har bir maxsus vazifa uchun task.json, train.jsonl va test.jsonl fayllari kerak.
2. Kategoriyalarni belgilang
task.json faylida nom, bitta ko‘rsatma jumlasi va yorliqlarning to‘liq ro‘yxati bo‘lishi kerak:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}Bir-biridan farq qiladigan va mazmunli yorliq nomlaridan foydalaning. Ko‘rsatma model yoki o‘qituvchi bajarishi kerak bo‘lgan tasniflash qarorini aniq bayon qilishi lozim.
3. O‘qitish va test yozuvlarini qo‘shing
Har bir satrga bittadan JSON obyekti saqlang. Yorliqli yozuv quyidagi tuzilishga ega:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}Agar o‘qituvchi model o‘qitish ma’lumotlarini yorliqlasa, train.jsonl faylidagi yozuvlarda label maydoni bo‘lmasligi mumkin:
{"id":"msg-002","text":"The application closes whenever I upload a file."}O‘qituvchi va talaba aniqligini o‘lchash uchun test yozuvlarida tekshirilgan yorliqlar bo‘lishi kerak. Loyiha modelni ishlab chiqarishda ishlatishdan oldin bir necha yuzta test xabarini qo‘lda tekshirishni tavsiya qiladi.
4. Yorliqlang, o‘qiting va baholang
Standart buyruqlarda katalogingizni ko‘rsating:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
--labels parametrini olib tashlab, inson yorliqlari asosida ham to‘g‘ridan-to‘g‘ri o‘qitishingiz mumkin. Ettin-17M o‘rniga boshqa enkoderdan foydalanish uchun modelni o‘qitish skriptining --model parametri orqali uzating.
Fine-tuning qachon foyda berishini o‘lchang
Vazifalarni tayyorlaganingizdan so‘ng zararsizlik nuqtasi tahlilini ishga tushiring:
uv run recipe/breakeven.pyBu skript pul va vaqtni hisobga olgan holda yorliqlash hamda o‘qitishga ketgan boshlang‘ich xarajatlar qoplanishi uchun nechta xabar tasniflanishi kerakligini baholaydi. Jev zero-shot tasniflash API’si bilan taqqoslaganda, repozitoriy vazifaga qarab zararsizlik nuqtasi taxminan 50,000 dan 500,000 tagacha xabar oralig‘ida ekanini aniqlagan.
Hajmingiz kichik yoki noaniq bo‘lsa, API oddiyroq tanlov bo‘lishi mumkin. Vazifa barqaror, baholash ma’lumotlari mavjud va tasniflash hajmi yuqori bo‘lganda fine-tuning yanada jozibador bo‘ladi.
Ilg‘or maslahatlar
Yorliqlar sifatini ustuvor qo‘ying
Tajribalar yorliqlar model hajmidan muhimroq ekanini ko‘rsatdi. Ko‘proq yorliqlangan misollar qo‘shilgani sari o‘rganish egri chiziqlari yaxshilanishda davom etdi. O‘qituvchi tomonidan o‘qitilgan talaba odatda o‘qituvchisidan bir necha aniqlik punktiga past natija ko‘rsatdi, inson yorliqlari esa bu chegarani oshirishi mumkin edi.
Ikki ma’noli kategoriyalarni ko‘rib chiqing, tizimli yorliqlash xatolarini tuzating va arxitekturani o‘zgartirish yoki ko‘plab giperparametrlarni sozlashdan oldin namunaviy misollar qo‘shing.
O‘qituvchini alohida baholang
Vazifani yomon bajarayotgan o‘qituvchining kamchiliklarini talaba ishonchli tarzda qoplay olmaydi. O‘nta vazifa natijalari o‘qituvchining o‘zi kuchsizroq bo‘lgan joylarda o‘qituvchi yorliqlagan modellar natijasi pasayganini ko‘rsatdi. Inson tomonidan tekshirilgan test to‘plamini saqlang va ancha katta to‘plamni yorliqlash uchun pul sarflashdan oldin o‘qituvchi aniqligini o‘lchang.
Tajribadagi o‘zgaruvchanlikni hisobga oling
README tasodifiy seedlar sababli taxminan ±0.5 foiz punkt, test to‘plami hajmi sababli esa ±1.5–2 punkt o‘zgarishni qayd etadi. Nashr qilingan jadvallarda uchta ishga tushirish natijasining o‘rtachasi ishlatilgan. Kichik aniqlik farqlari joriy etish qarorlariga ta’sir qilganda, takroriy ishga tushirishlar va yetarlicha katta test to‘plamlaridan foydalaning.
Litsenziyalar va provayder shartlariga rioya qiling
O‘qituvchi modelining litsenziyasi va provayder shartlari bunga ruxsat bergandagina generatsiya qilingan javoblar asosida o‘qiting. Repozitoriy Kimi K3’dan foydalangan, biroq ayrim modellar va API’lar o‘z chiqishlaridan boshqa modelni o‘qitish uchun foydalanishni taqiqlaydi. Ochiq ma’lumotlar to‘plamlarining ham o‘z litsenziyalari bor; repozitoriy ularni qayta tarqatmaydi, balki yuklab oladi.
Muqobil qurilmalarni sinab ko‘ring
Asosiy o‘qitish skripti CPU va GPU’da ishlashni qo‘llab-quvvatlaydi. Repozitoriyda Chrome orqali WebGPU va jax-js yordamida o‘qitadigan alohida telefon varianti ham mavjud. Telefon ish jarayonini maxsus implementatsiya sifatida ko‘ring va loyiha phone/ katalogidagi ko‘rsatmalarga amal qiling.
Hujjatlashtirilgan NixOS muammosini chetlab o‘ting
Agar NixOS’da o‘qitish /sbin/ldconfig topilmagani sababli ishlamasa, o‘qitishni ishga tushirishdan oldin CUDA kutubxonasi yo‘lini belgilang:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libXulosa
tiny-classifiers yorliqlangan matnni tezkor lokal klassifikatorga aylantirish uchun ixcham ish jarayonini taqdim etadi: vazifani tayyorlang, inson yoki o‘qituvchi yorliqlarini oling, Ettin-17M’ni fine-tuning qiling, tekshirilgan misollar asosida baholang va lokal inferensiya iqtisodiy jihatdan API’dan ustun keladimi-yo‘qmi, baholang.
Eng muhim saboq ishonchli yorliqlar va baholash ma’lumotlariga sarmoya kiritishdir. Ular mavjud bo‘lgach, 17 million parametrli enkoder kuchli tasniflash aniqligi, millisekund darajasidagi inferensiya va har bir xabar uchun katta modelga murojaat qilmasdan bashorat qilinadigan lokal ishlatish xarajatlarini ta’minlay oladi.