

Rekurrent Loop Transformer nima?
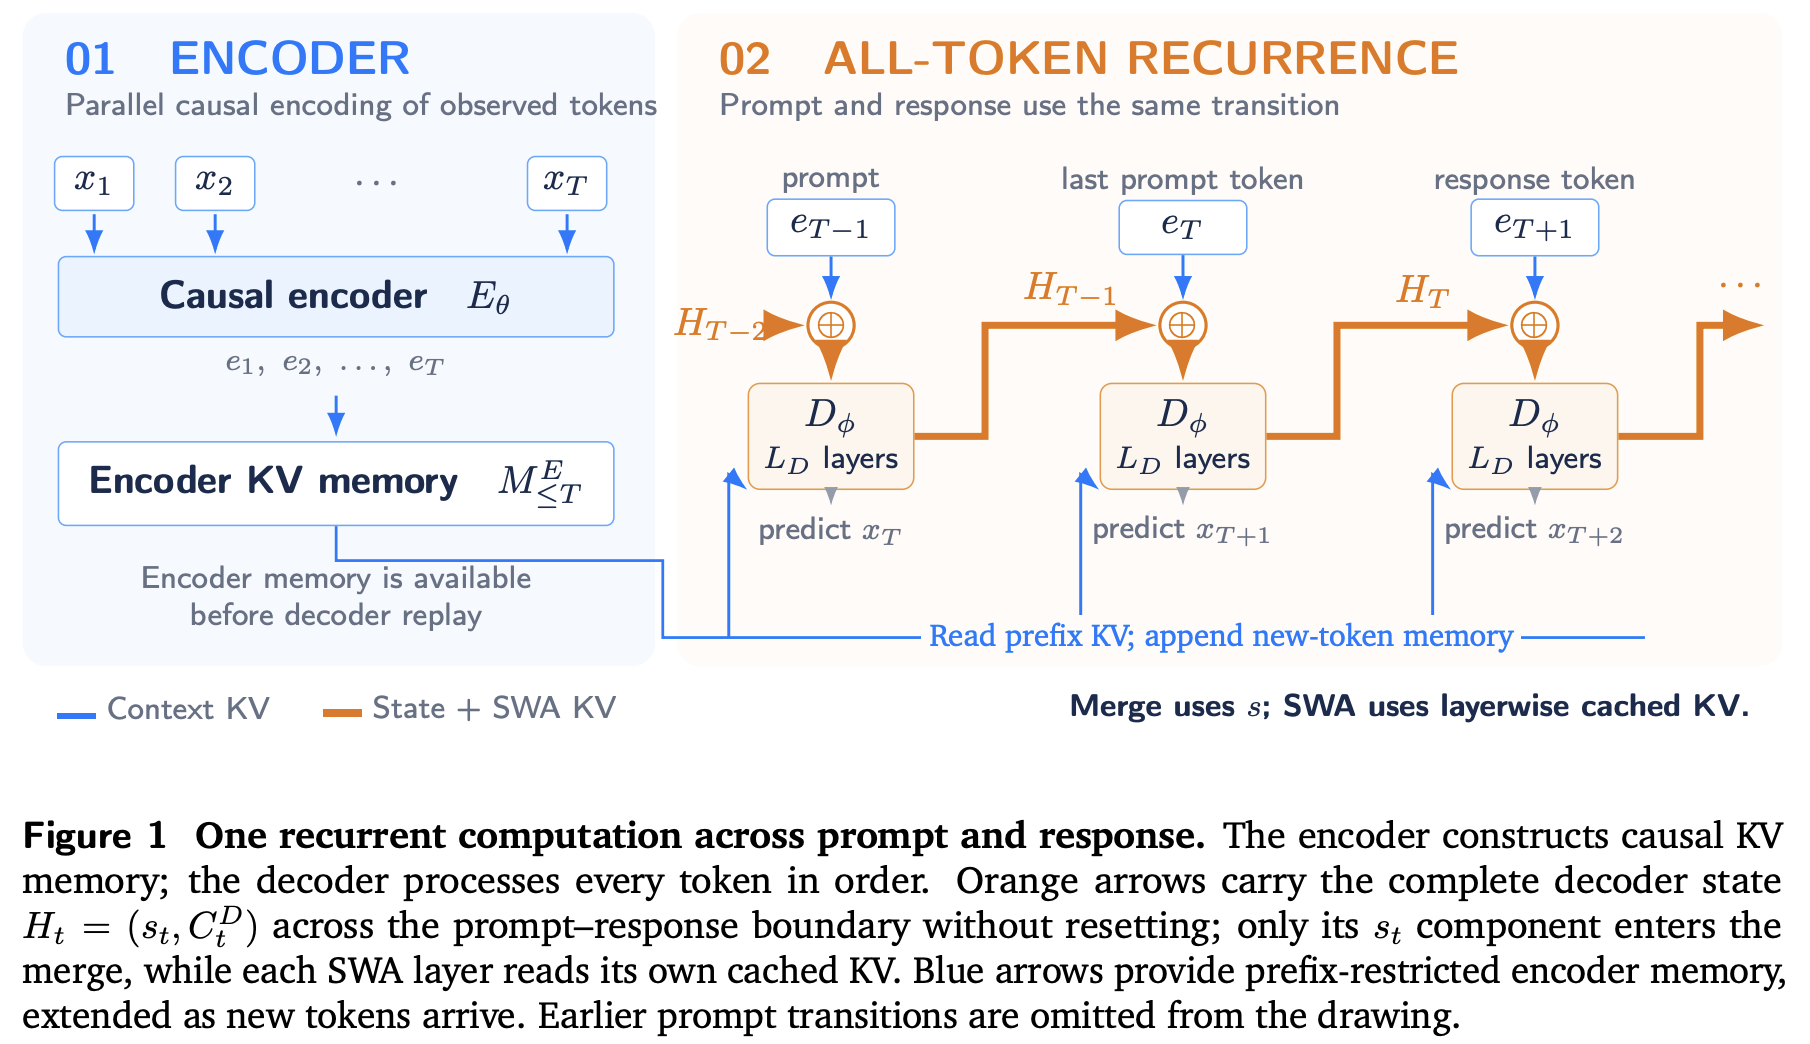
Rekurrent Loop Transformer (RLT) — ketma-ketlikdagi har bir token orqali yashirin hisoblashni davom ettirish uchun ishlab chiqilgan tadqiqot arxitekturasi. Sababiy encoder global key–value xotirasini hosil qiladi, rekurrent decoder esa bu xotirani siljuvchi oyna attention'i va oldingi yakuniy yashirin holatdan olingan teskari aloqa bilan birlashtiradi.
Bu kengaytiriladigan vaqtinchalik hisoblash yo‘lini yaratadi. Agar decoder'da L_D qatlam bo‘lsa, t ta tokenni qayta ishlash tL_D ta decoder bloklari orqali rekurrent yo‘l hosil qiladi, garchi model har bir token uchun faqat o‘zgarmas miqdordagi bloklarni ishga tushirsa ham.
Ushbu loyihada “cheksiz vaqtinchalik chuqurlik” hisoblash yo‘li ketma-ketlik uzunligi bilan o‘sishi mumkinligini anglatadi. Bu model bitta token ichida cheksiz hisoblash bajaradi degani emas.
Asosiy dizayn tamoyillari
1. Vaqt davomida yashirin mantiqiy xulosa
Bir token uchun decoder'ning yakuniy chiqishi keyingi token uchun kirishga aylanadi. Natijada model prompt va generatsiya qilingan javob bo‘yicha yashirin holatni uzluksiz tarqatishi mumkin, prompt–javob chegarasini qayta boshlanish nuqtasi sifatida ko‘rmaydi.
2. Model va apparatni birgalikda loyihalash
Taklif etilgan dizayn bir nechta optimallashtirish imkoniyatlarini taqdim etadi:
- Ma’lum tokenlar bo‘yicha sababiy encoder hisoblashlarini parallellashtirish
- Mustaqil ketma-ketliklar bo‘yicha batch qayta ishlash
- Encoder hosil qilgan xotiradan qayta foydalanish
- Rekurrent decoder bajarilishi atrofida aktivatsiyalarni checkpoint qilish
Bular dizayn imkoniyatlari va tadqiqot maqsadlaridir. Hisobot katta ko‘lamli apparat tezlashuvlarini o‘lchaganini da’vo qilmaydi.
3. O‘qitish va reinforcement learning uchun umumiy semantika
Oldindan o‘qitish, nazorat ostidagi fine-tuning, sampling va joriy siyosat asosidagi reinforcement learning replay jarayonlarining barchasi bir xil to‘liq holat o‘tishidan foydalanadi. Bu holat prompt rekurrentligini, shuningdek decoder'ning qatlamlar bo‘yicha siljuvchi oyna key–value keshlarini ham o‘z ichiga oladi.
Arxitektura qanday ishlaydi
x_t tokeni uchun sababiy encoder e_t ko‘rinishini va encoder hosil qilgan global M_≤t xotirani yaratadi. Decoder holati rekurrent chiqish hamda qatlamlar bo‘yicha siljuvchi oyna attention keshidan iborat:
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
Holat o‘tishi quyidagicha:
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
Keyingi token taqsimoti yakuniy rekurrent chiqishdan hisoblanadi:
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))Kontekstning uch shakli
- Global encoder konteksti: Decoder cross-attention encoder xotirasini faqat joriy pozitsiya orqali o‘qiydi va shu tariqa sababiy xususiyatni saqlaydi.
- Mahalliy decoder xotirasi: Siljuvchi oyna attention'i decoder'ning yaqindagi key–value yozuvlari va joriy token yozuvini o‘qiydi.
Wo‘lchamli oyna joriy tokenni o‘z ichiga oladi, shu sababli keyingi yangilash uchun ko‘pi bilanW - 1ta tarixiy yozuv qoladi. - Vaqtinchalik teskari aloqa: Oldingi yakuniy decoder chiqishi joriy encoder ko‘rinishi bilan birlashtiriladi.
Ketma-ketlik promptdan javobga o‘tganda na rekurrent chiqish, na decoder keshi qayta tiklanadi.
Model konfiguratsiyasining aniq ko‘rinishi
Hisobot 48 ta encoder qatlami va 48 ta decoder qatlami bo‘lgan konfiguratsiyani tasvirlaydi. Mos attention va feed-forward og‘irliklari bosqichlar o‘rtasida umumiy ishlatiladi. Decoder bloklari qo‘shimcha ravishda encoder xotirasi bo‘yicha cross-attention bajaradi, shuning uchun qatlamlar sonining bir xil bo‘lishi suzuvchi nuqtali amallar soni ham bir xil degani emas.
O‘rnatish va repository sozlamalari
README hujjatlashtirilgan dasturiy paketdan ko‘ra arxitektura hisobotini taqdim etadi. Unda bog‘liqlik talablari, o‘rnatish buyrug‘i, ochiq training skripti yoki ishga tushiriladigan API keltirilmagan. Shunga qaramay, maqola va yordamchi materiallarni o‘qish uchun repository'ni klonlashingiz mumkin:
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformer
Ichidagi Recurrent_Looped_Transformer.pdf faylidan boshlang. Shuningdek, loyiha veb-saytiga kirib, prefill–decode kernel nomuvofiqligi haqidagi izohni ko‘rib chiqishingiz mumkin.
README bajariladigan implementatsiyani hujjatlashtirmagani sababli, repository tavsifidan paketni o‘rnatish ko‘rsatmalari yoki darhol ishga tushiriladigan model kodini xulosa qilib bo‘lmaydi.
Asosiy foydalanish: RLT bajarilish modeliga amal qilish
Hisobotni qo‘llashning eng foydali usuli — undan implementatsiya rejasi sifatida foydalanish. Quyidagi konseptual pseudokod bitta holat o‘tishini umumlashtiradi; u repository taqdim etgan API emas:
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
Promptni oldindan to‘ldirish
- Ma’lum prompt tokenlari bo‘yicha sababiy encoderni batch sifatida ishga tushiring.
- Decoder orqali har bir prompt tokeni bo‘yicha rekurrent qayta ishlashni bajaring.
- Ushbu rekurrent jarayon davomida decoder'ning siljuvchi oyna key–value keshini yarating.
- Generatsiya uchun yakuniy rekurrent chiqish va keshni saqlab qoling.
Promptni oldindan to‘ldirish paytida faqat enkoderni ishga tushirish hisobotda tasvirlangan to‘liq RLT holatini qayta tiklamaydi.
Avtoregressiv generatsiya
- Keyingi token taqsimotini hisoblash uchun oldingi holatdan foydalaning.
- Shu taqsimotdan token tanlang.
- Tanlangan tokenni bosqichma-bosqich enkodlang.
- Ushbu tokenni rekurrent dekoder orqali aynan bir marta o‘tkazing.
- Rekurrent chiqish va sirpanuvchi oyna keshining ikkalasini ham yangilang.
Bu tartib generatsiya qilingan tokenni ikki marta qayta ishlashning oldini oladi va treningda ishlatiladigan holat o‘tishi semantikasini saqlaydi.
Oldindan trening va nazoratli nozik sozlash
Oldindan trening vaqtida enkoder sababiy tarzda ishlaydi, rekurrent dekoder esa vaqt bo‘yicha to‘liq orqaga tarqatishdan foydalanadi. Har bir yaroqli keyingi token nishoni bilan nazorat qilinadi.
Nazoratli nozik sozlash vaqtida holat barcha kontekst tokenlari asosida yangilanadi, biroq yo‘qotish faqat assistant nishonlariga qo‘llanadi. Tokenlari nazorat qilinmasa ham, prompt rekurrent holatni shakllantirishda ishtirok etadi.
Joriy siyosat bo‘yicha mustahkamlovchi o‘qitish replayi
Joriy siyosat replayi joriy model og‘irliklari ostidagi to‘liq ketma-ketlik tarixini qayta tiklashi kerak. Bunga rekurrent chiqishlar, enkoder xotirasi va dekoderning barcha sirpanuvchi oyna keshlari kiradi.
- Joriy parametrlar yordamida enkoder tasvirlari va xotirasini qayta yarating.
- Rekurrent holat va dekoder keshlarini qayta tiklash uchun barcha oldingi tokenlarni replay qiling.
- Harakat tokenini iste’mol qilishdan oldin uning ehtimolini baholang.
- Keyingi holatga o‘tish uchun harakatni bir marta iste’mol qiling.
Parametrlarga bog‘liq keshlar og‘irliklar yangilangandan keyin eskiradi, shuning uchun aniq replay ularni qayta yaratishni talab qiladi. To‘liq gradientlar rekurrent chiqishlar, dekoderning key–value yozuvlari va enkoder xotirasi orqali o‘tadi. Ushbu komponentlardan birortasini uzish gradientning taxminiy hisoblanishiga olib keladi.
Xatti-harakat log-ehtimolliklari aynan namuna olishda ishlatilgan taqsimotga mos kelishi kerak. Aniq muhimlik bo‘yicha namuna olish qo‘shimcha ravishda qo‘llab-quvvatlash qamrovini talab qiladi. Umumiy bajarilish semantikasi prompt chegaralaridagi strukturaviy nomuvofiqlikni kamaytiradi, biroq yadrolar o‘rtasidagi sonli tenglikni yoki xolis off-policy maqsadini kafolatlamaydi.
Dastlabki sintetik natijalar
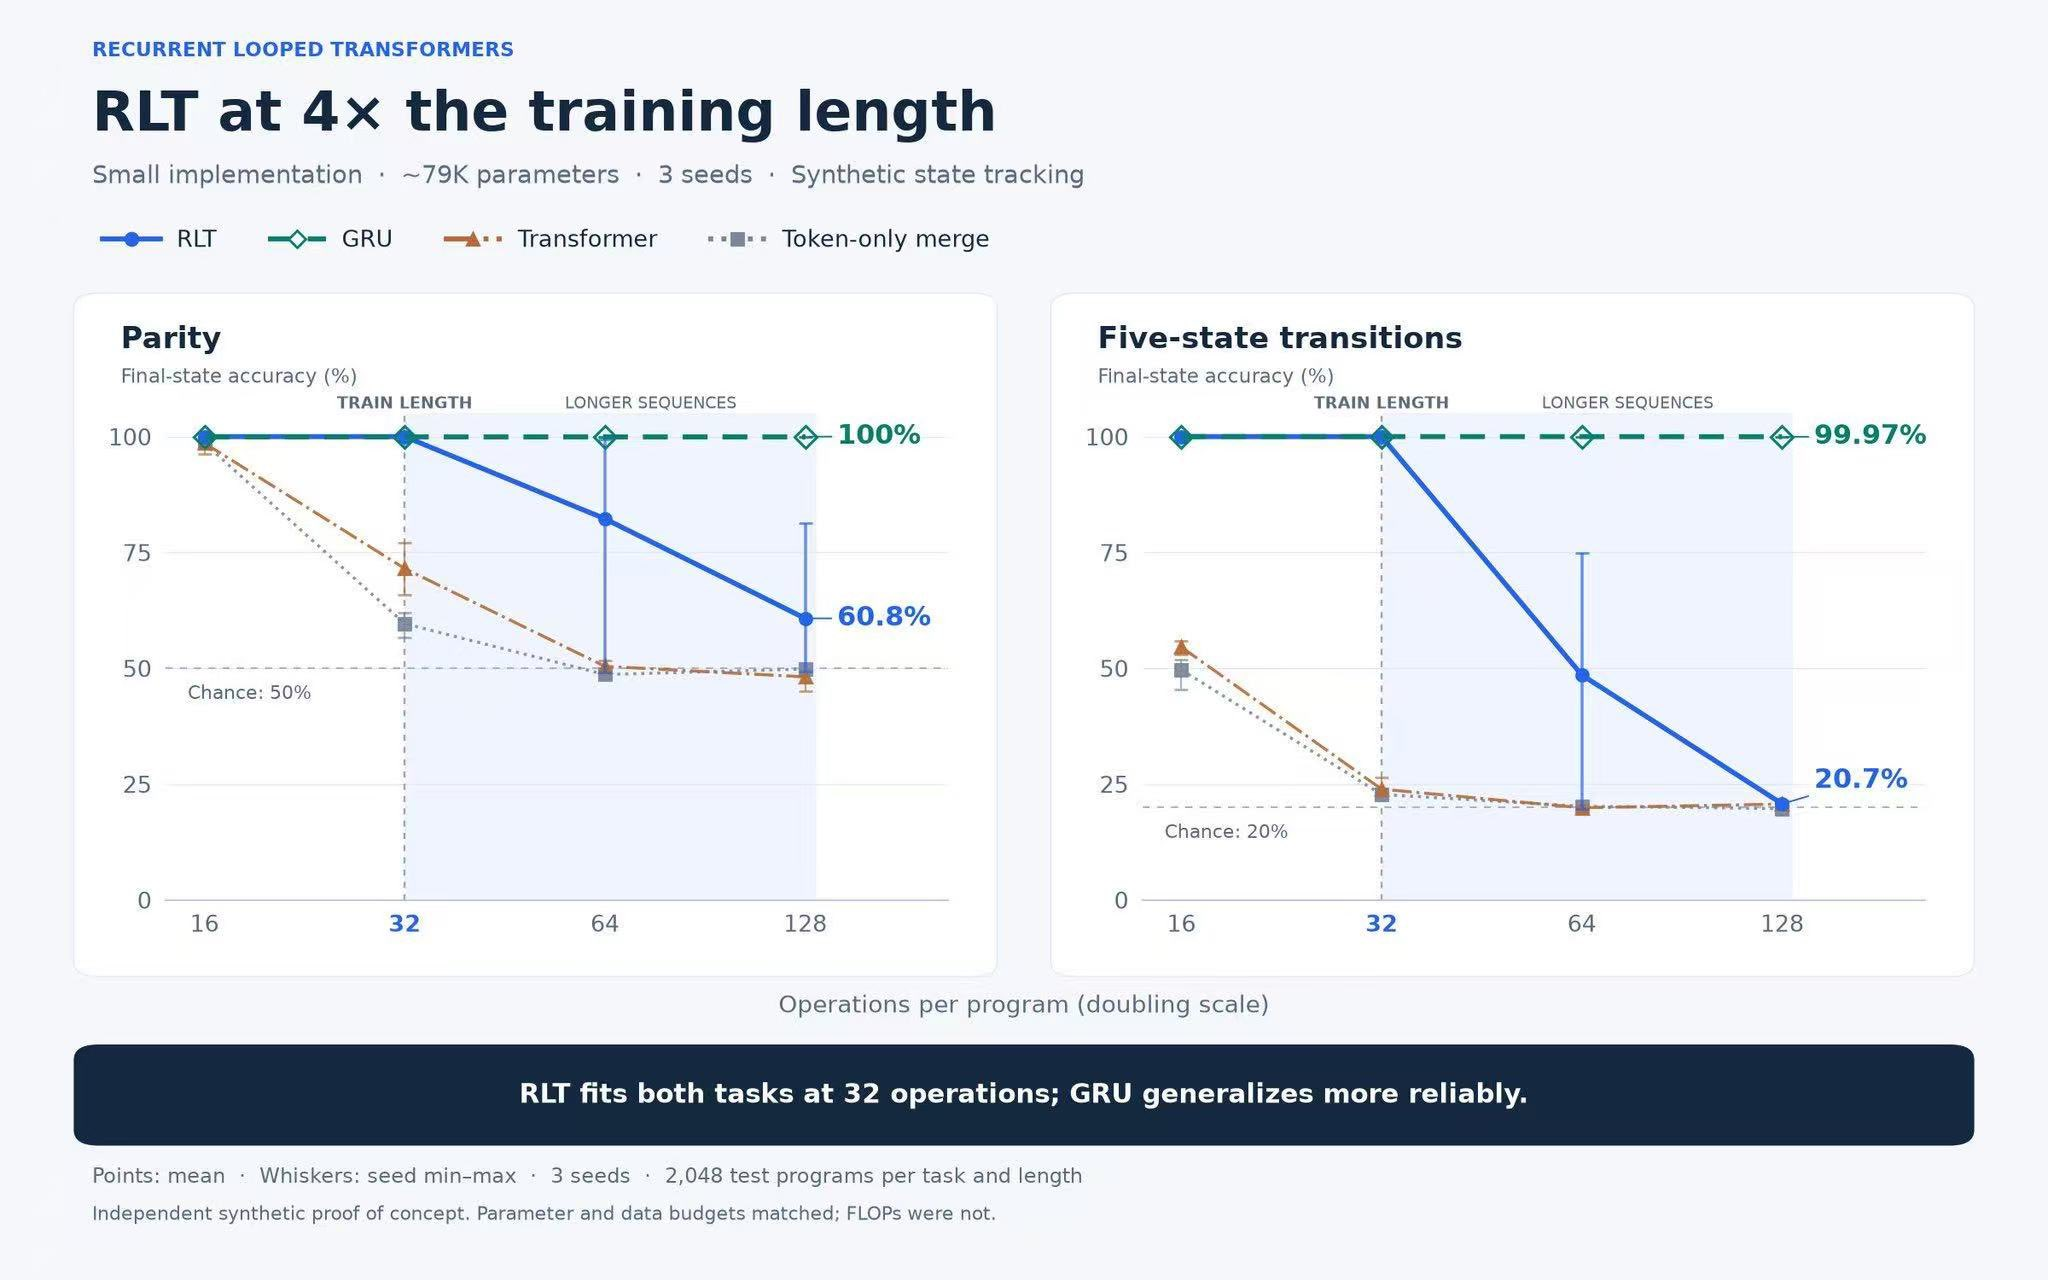
README taxminan 79 000 ta parametr va uchta tasodifiy urug‘ ishlatilgan kichik dastur yordamida o‘tkazilgan, holatni kuzatishga oid mustaqil konsepsiya isboti tajribalarini bayon qiladi. Modellar 32 ta amaldan iborat ketma-ketliklarda o‘qitildi va 128 tagacha amal bo‘yicha baholandi; har bir vazifa va uzunlik uchun 2 048 tadan test dasturi ishlatildi.
Paritet vazifasi
- 32 ta amalda RLT yakuniy holat aniqligida taxminan 100% ga erishdi.
- 64 ta amalda bu ko‘rsatkich taxminan 82% bo‘ldi.
- 128 ta amalda u 60,8% ga yetdi.
- Paritet uchun tasodifiy aniqlik 50% ni tashkil etadi.
Besh holatli o‘tish vazifasi
- 32 ta amalda RLT yakuniy holat aniqligida taxminan 100% ga erishdi.
- 64 ta amalda bu ko‘rsatkich taxminan 49% bo‘ldi.
- 128 ta amalda u 20,7% ga yetdi.
- Bu vazifa uchun tasodifiy aniqlik 20% ni tashkil etadi.
Natijalar RLT trening uzunligida ikkala vazifaga ham moslashganini, biroq uzunroq ketma-ketliklarda uning aniqligi pasayganini ko‘rsatadi. Taxminiy deb belgilangan qiymatlar asl rasmdan o‘qilgan, 128 amalli RLT qiymatlari esa son bilan ko‘rsatilgan.
Parametr va ma’lumotlar budjetlari tenglashtirilgan, biroq suzuvchi nuqtali amallar budjetlari tenglashtirilmagan. Bu tajribalar sintetik namoyishlar bo‘lib, keng ko‘lamli mulohaza yuritish yaxshilangani, apparat tezlashuvi yoki mustahkamlovchi o‘qitish masshtablanishiga dalil emas.
Ilg‘or amalga oshirish bo‘yicha maslahatlar
- To‘liq holatni bo‘linmas deb qarang:
s_tvaC_t^Dning ikkalasini ham saqlang. Faqat rekurrent vektorni tiklash hujjatlashtirilgan o‘tishni qayta hosil qilmaydi. - Javob chegaralarida holatni tiklamang: Prompt rekurrent aloqasi va uning dekoder keshi bevosita javob generatsiyasiga o‘tishi kerak.
- Oynani aniq belgilang: Hajmi
Wbo‘lgan sirpanuvchi oyna joriy tokenni o‘z ichiga oladi, shuning uchun keyingi yangilash uchun faqatW - 1ta tarixiy yozuv mavjud bo‘ladi. - Yangilanishlardan keyin keshlarni qayta yarating: Joriy siyosat replayi avvalgi siyosatdan keshlangan qiymatlar o‘rniga joriy og‘irliklar yaratgan keshlarni talab qiladi.
- Namuna olish va replay tartibini moslang: Generatsiya qilingan harakatni oldingi holatdan baholang, so‘ng uni bir marta iste’mol qiling.
- Aniq gradientlar bilan taxminlarni farqlang: Rekurrent holat, dekoder keshlari yoki enkoder xotirasini uzish gradient yo‘lini o‘zgartiradi.
- Hisoblashni alohida o‘lchang: Parametr yoki ma’lumotlar budjetlarining tengligi FLOP’lar tengligini bildirmaydi, ayniqsa dekoder qatlamlari enkoder xotirasi bilan o‘zaro e’tiborni qo‘shgani sababli.
- Sonli xatti-harakatni tekshiring: Yuqori darajadagi umumiy bajarilish semantikasi oldindan to‘ldirish va dekodlash yadrolari o‘rtasidagi farqlarni avtomatik ravishda yo‘q qilmaydi.
Xulosa
Recurrent Looped Transformer global sababiy enkoder xotirasi, dekoderning mahalliy sirpanuvchi oyna e’tibori va tokenlar o‘rtasidagi rekurrent qayta aloqani birlashtiradi. Uning markaziy amalga oshirish qoidasi izchillikdir: har bir prompt va javob tokeni oldindan trening, nozik sozlash, generatsiya va joriy siyosat replayi davomida bir xil to‘liq holat o‘tishida ishtirok etishi kerak.
Dastlabki tajribalar kichik holatni kuzatish vazifalarida uzunlik bo‘yicha foydali umumlashmani ko‘rsatadi, biroq trening uzunligidan tashqarida unumdorlik pasayishda davom etadi. Shu sababli arxitekturani tasdiqlangan keng ko‘lamli mulohaza yuritish tizimi emas, balki tadqiqot taklifi va konsepsiya isboti sifatida ko‘rish kerak.