

Graduate Admissions Agent Benchmark nima qiladi
Graduate Admissions Agent Benchmark magistratura va doktorantura qabuliga oid maslahat berishda agent konfiguratsiyalarini baholaydi. Agent konfiguratsiyasi bajarish tizimini til modeli bilan birlashtiradi va ariza bo‘yicha tavsiyalar, rejalashtirish, qaror qabul qilish hamda yangi talaba ma’lumotlari paydo bo‘lganda maslahatlarni yangilash bo‘yicha sinovdan o‘tkaziladi.
Benchmark hozirda xitoy tilidagi 70 ta topshiriq, 23 ta holat va 83 ta javob bosqichini o‘z ichiga oladi. Har bir topshiriq uchun baholash mezonlari va namunaviy dasturlar mavjud. Ommaviy ma’lumotlar to‘plamidan kirish ruxsatisiz foydalanish mumkin, biroq baholash materiallari natijalar buzilmasligi uchun sinovdan o‘tkazilayotgan agentlardan yopiq saqlanishi kerak.
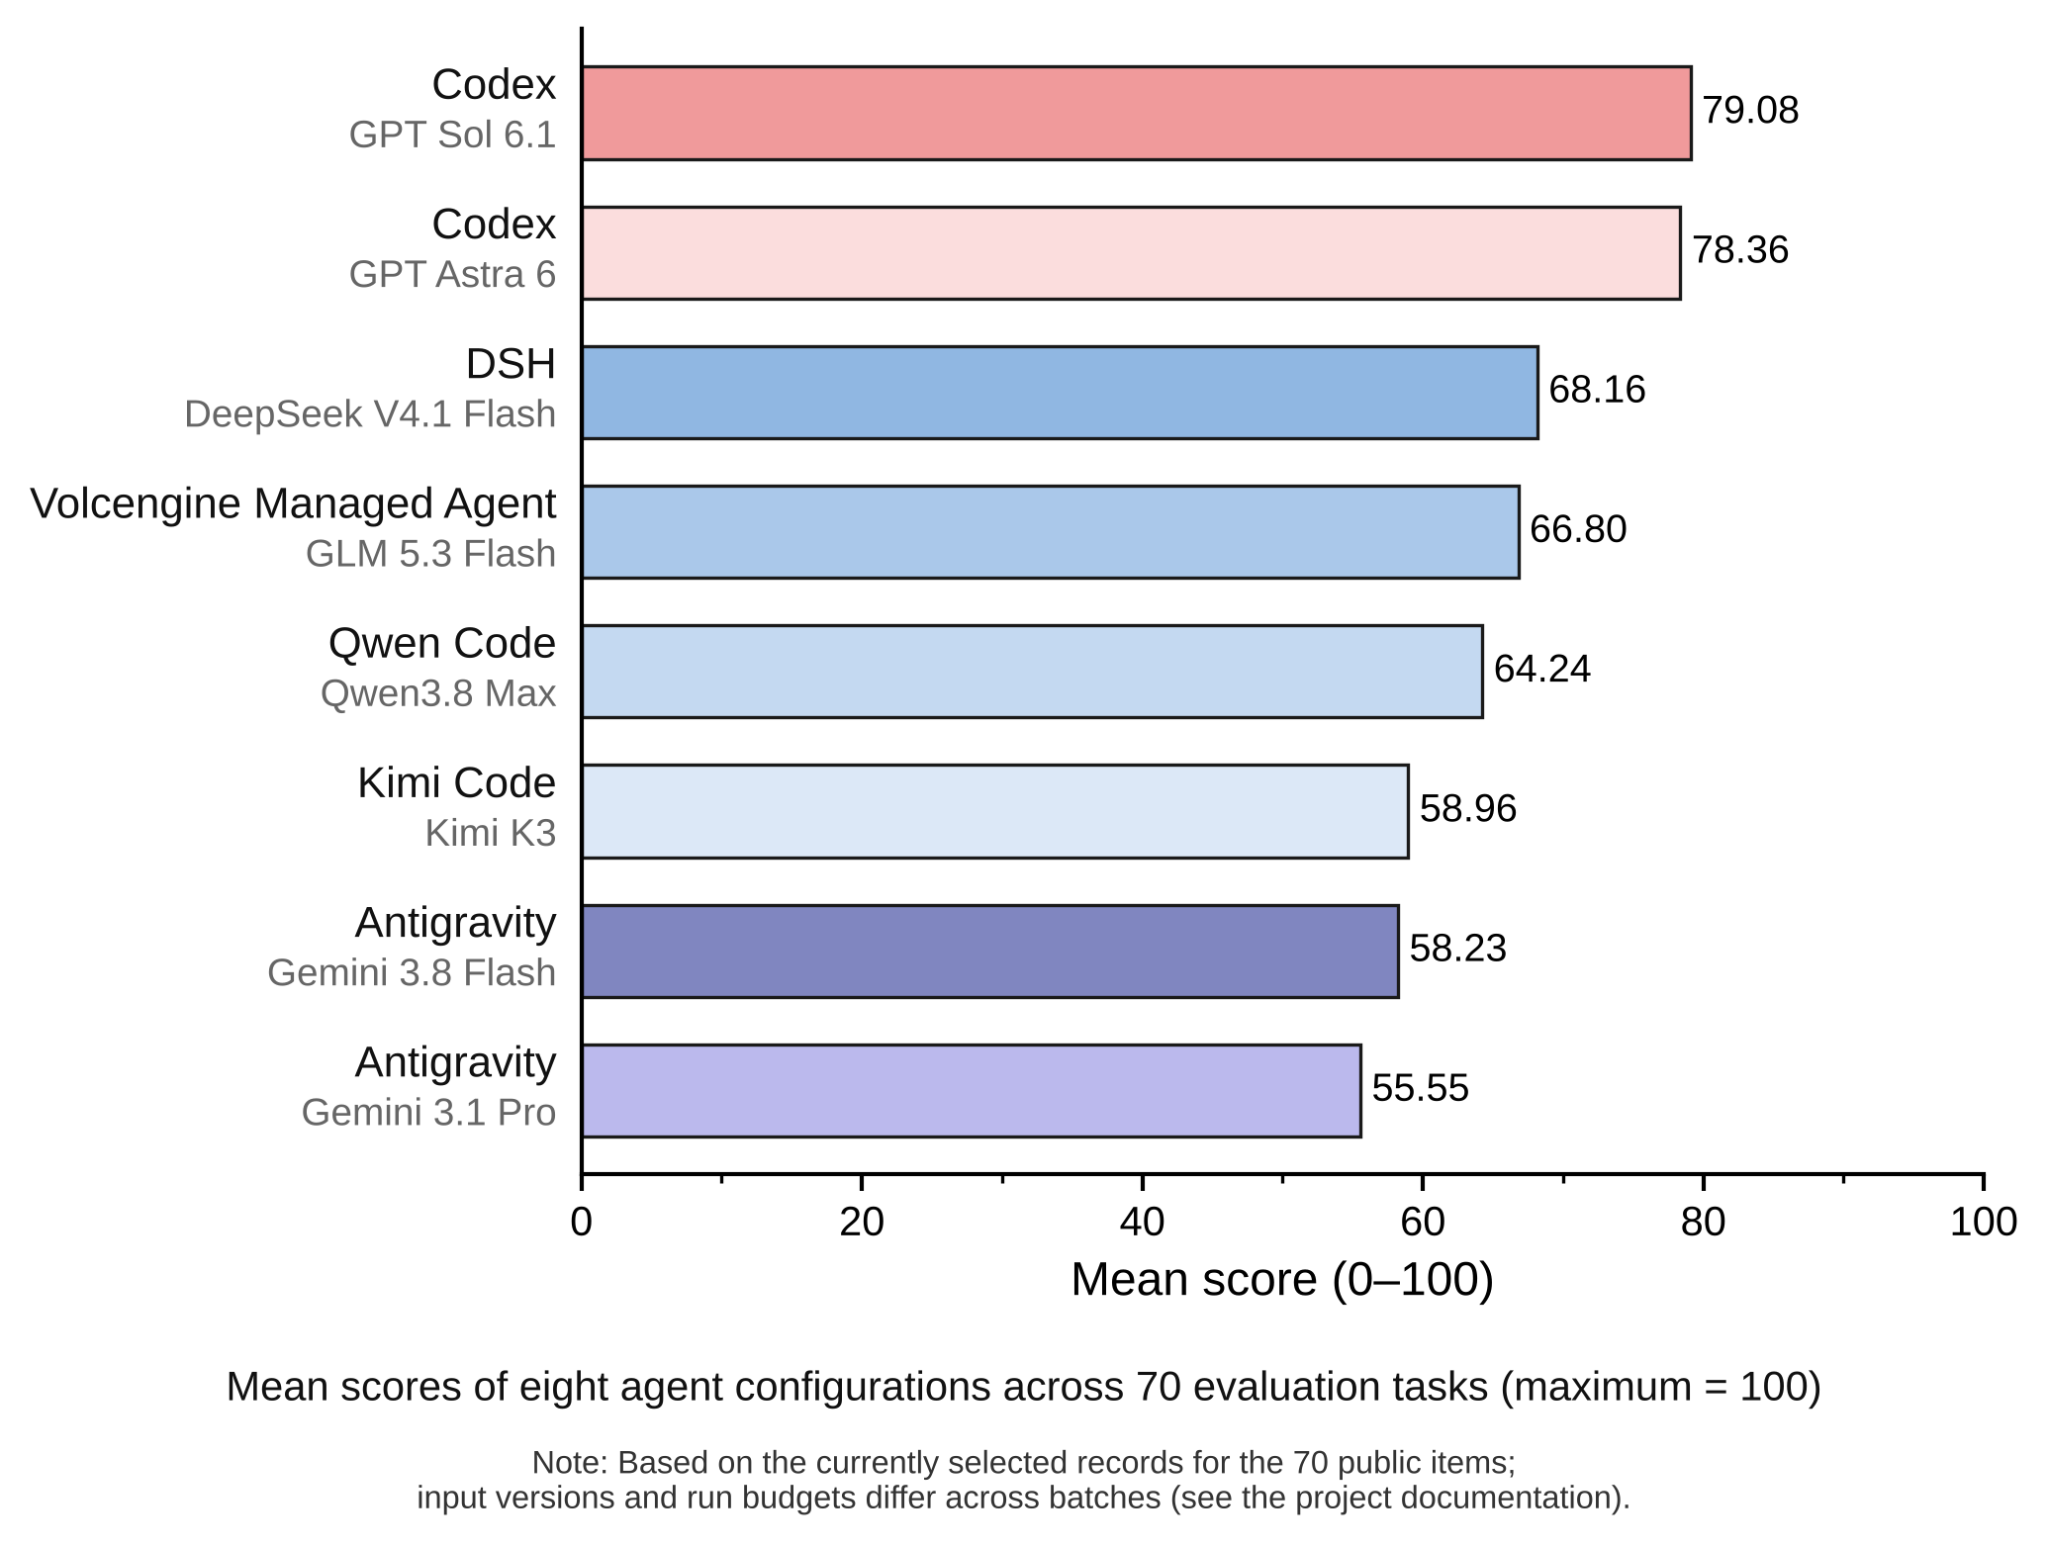
Repozitoriyda shuningdek, sakkizta konfiguratsiya uchun baholash qaydlari e’lon qilingan. Har bir konfiguratsiya joriy 70 ta topshiriqni bajargan, biroq loyiha qaydlariga ko‘ra, ishga tushirishlarda turli kiritish versiyalari va byudjetlar ishlatilgan. Shu sababli reyting jadvalidagi natijalarni mutlaqo bir xil tajribalar sifatida talqin qilmaslik kerak.
Baholash tuzilmasini tushunish
Topshiriqlar to‘plami uchta toifaga bo‘lingan:
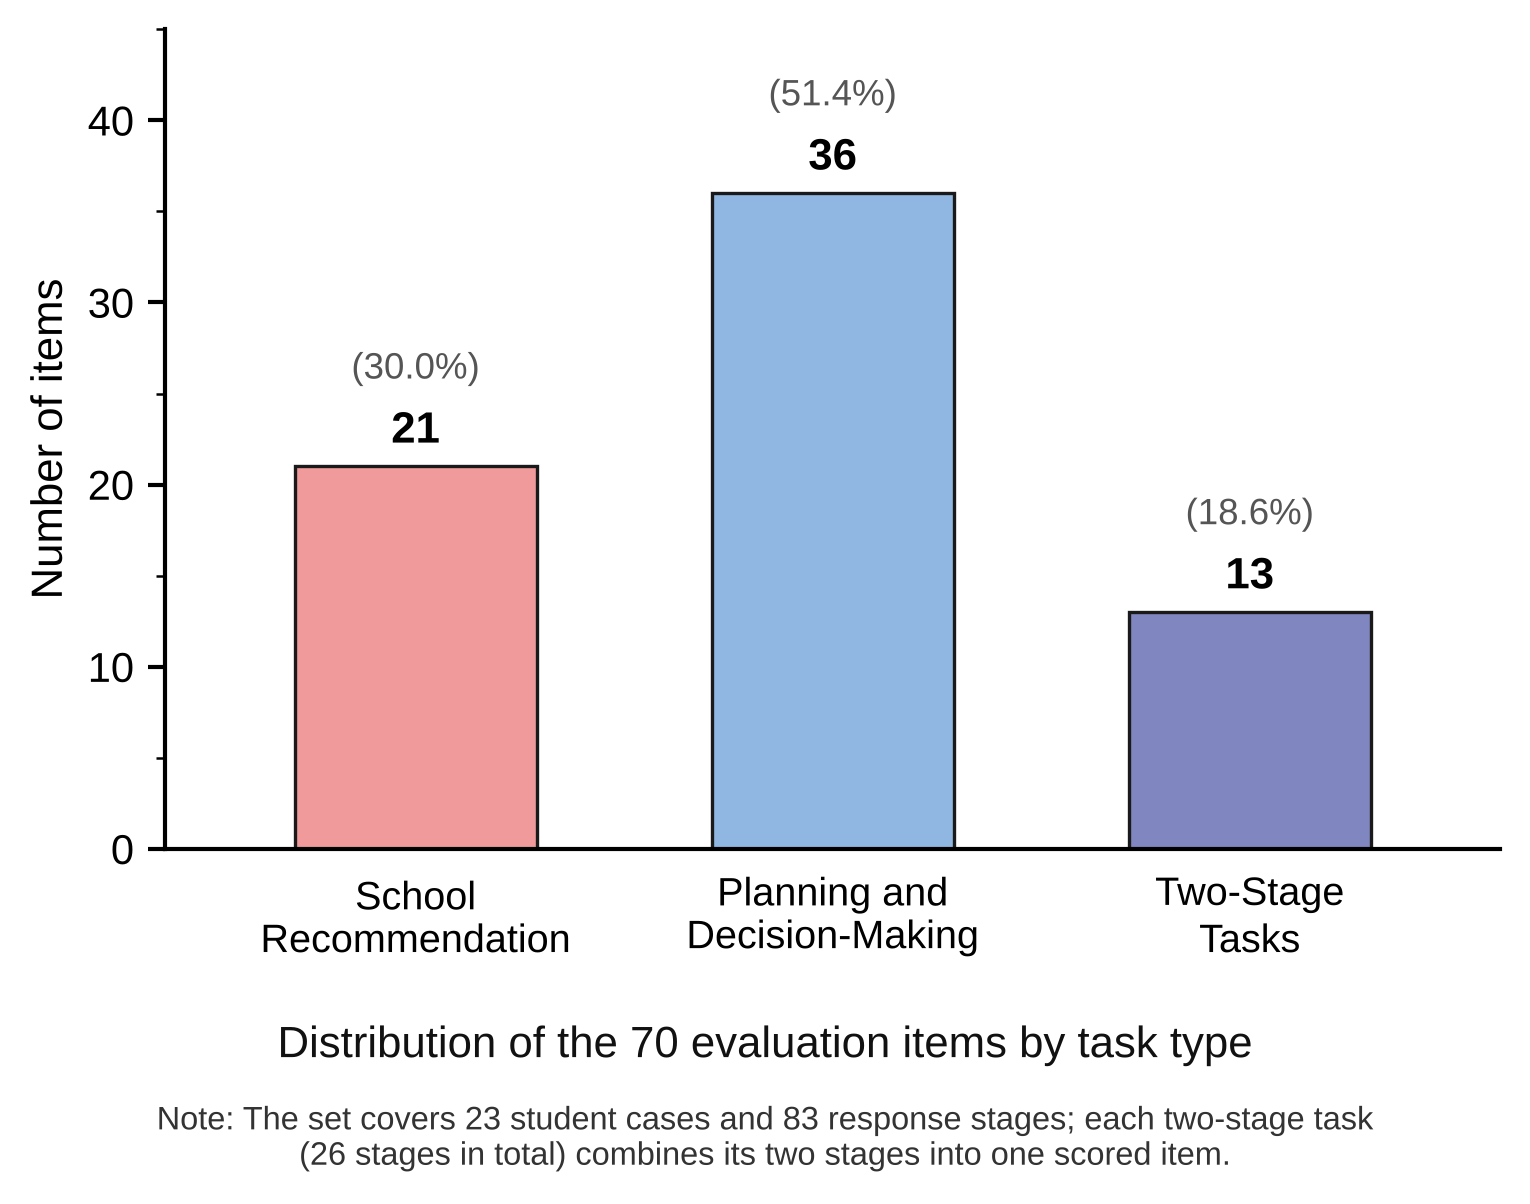
- 21 ta tavsiya topshirig‘i: tavsiya qilingan dasturlar talabaning ma’lumoti va cheklovlariga qanchalik mos kelishini baholaydi.
- 36 ta rejalashtirish va qaror topshirig‘i: tayyorgarlik rejalari, xavflarni baholash va amaliy maslahatlarni tekshiradi.
- 13 ta ikki bosqichli topshiriq: bir sessiyada yangi ma’lumot beradi va agent avvalgi maslahatlarini qayta ko‘rib chiqishini tekshiradi.
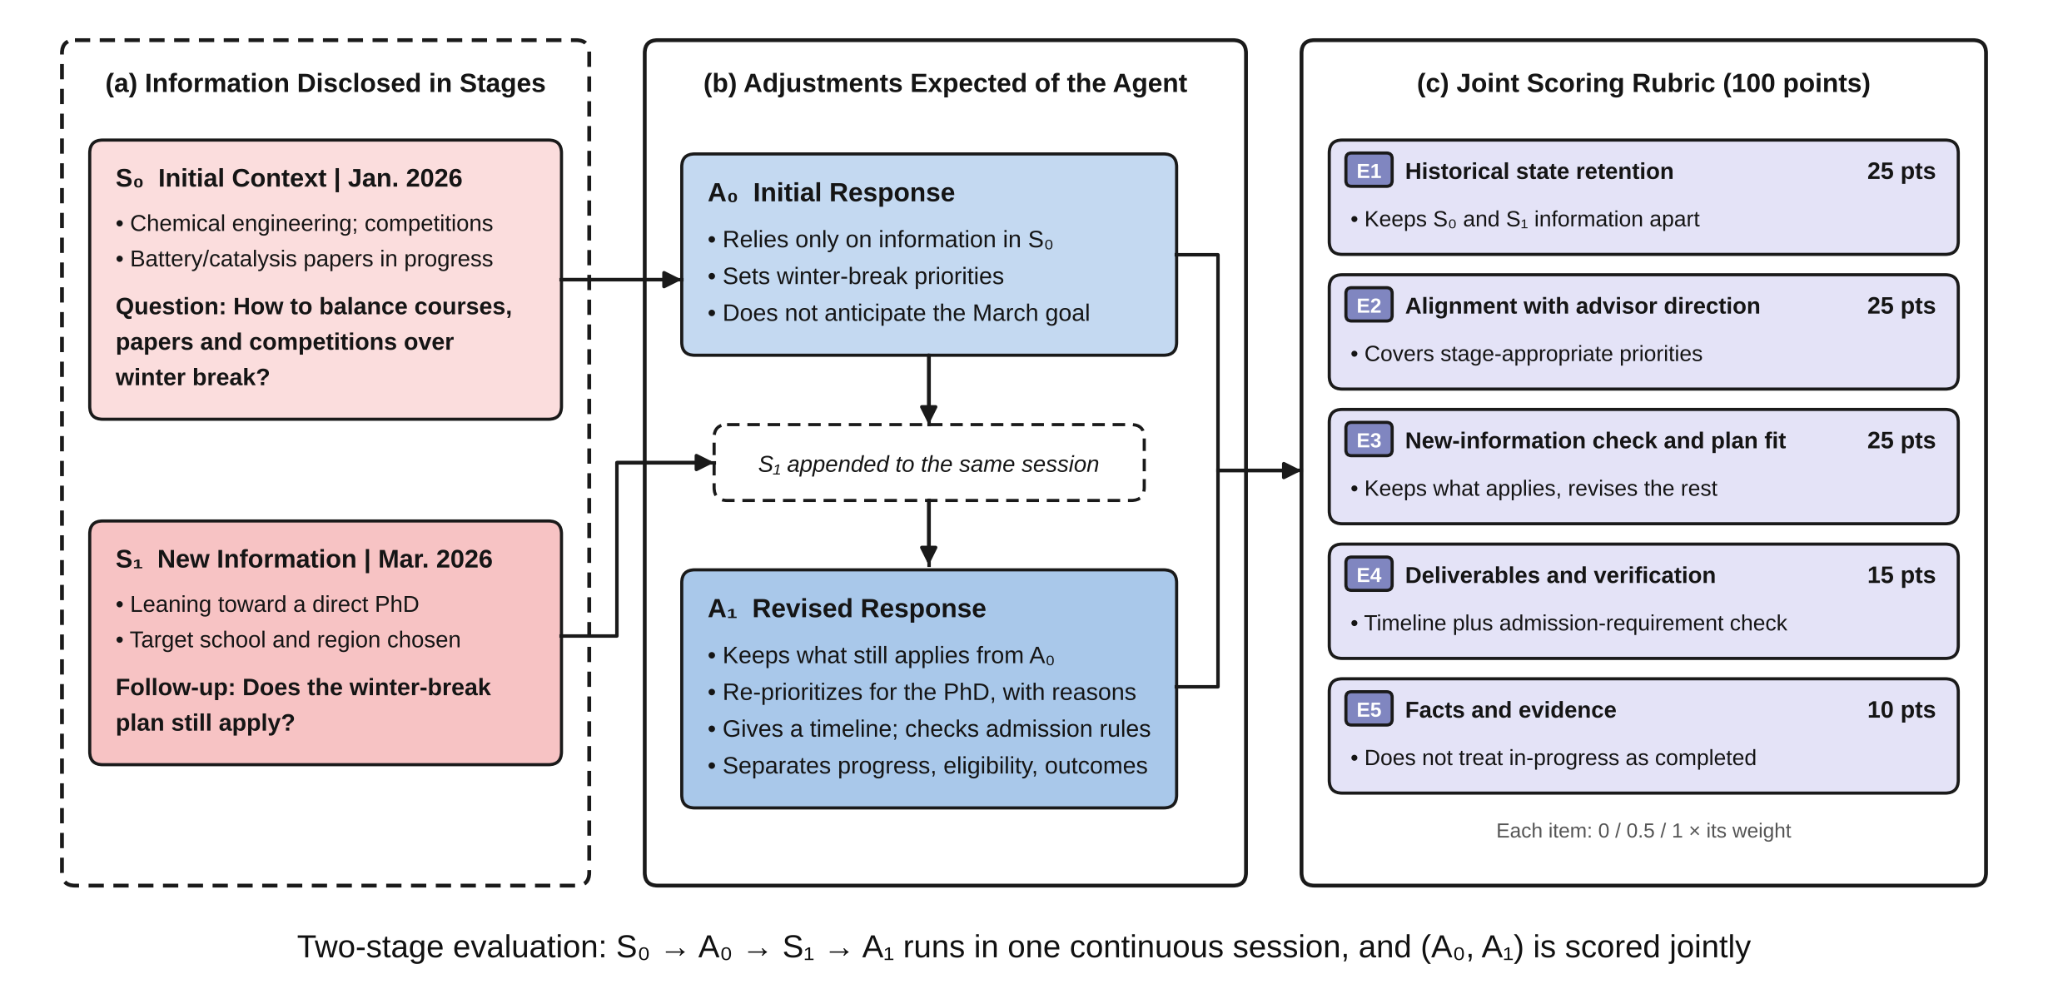
Har bir topshiriq 100 ball bilan baholanadi. Tavsiya topshiriqlarida 70 ball namunaviy dasturga moslikka, 30 ball esa tavsiya sifatiga beriladi. To‘liq javobni alohida baholovchi tekshiradi, mezonlar esa javob berish jarayonidan tashqarida saqlanadi.
Ikki bosqichli topshiriqlar S₀ deb ataladigan dastlabki kontekstdan boshlanadi, so‘ng S₁ deb ataladigan yangilangan ma’lumot taqdim etiladi. Agent bir sessiya davomida dastlabki javob A₀ va qayta ko‘rib chiqilgan javob A₁ ni yaratadi. Har ikki javob birgalikda baholanadi. Ommaviy O03-04 misolida talaba yanvardan martgacha bo‘lgan vaziyatda yo‘nalishini bevosita PhD dasturlariga topshirishga o‘zgartiradi.
Muhitni tayyorlash
Buyruqlarni repozitoriy ildiz katalogidan ishga tushiring. Avtomatlashtirilgan mahalliy bajarish uchun macOS Seatbelt va Python 3.10 yoki undan yangiroq versiyasi talab qilinadi. Kimi obunasi konfiguratsiyasi uchun Python 3.11 yoki undan yangiroq versiyasi kerak.
Freymvork faqat Python standart kutubxonasidan foydalanadi, shuning uchun repozitoriyda pip install bosqichi talab qilinmaydi. Biroq ishga tushirmoqchi bo‘lgan konfiguratsiya uchun rasmiy klientni o‘rnatishingiz va uning obuna orqali kirishi yoki API kalitini tayyorlashingiz kerak.
Mavjud klientlar: Codex, Claude Code, Antigravity, DeepSeek Harness, Qwen Code va Kimi Code. Autentifikatsiya klientga qarab farq qiladi: ayrim konfiguratsiyalar obuna yoki OAuth’dan foydalanadi, DeepSeek va Qwen esa loyiha hujjatlarida ko‘rsatilganidek, API orqali autentifikatsiyadan foydalanadi.
Agent konfiguratsiyasini tanlash
Agent identifikatorlari repozitoriyning joriy reyestridan olinadi: config/agents-cli.example.json. Bu identifikatorlar benchmark konfiguratsiyasi identifikatorlari bo‘lib, modelga bevosita beriladigan argumentlar emas.
gpt-6-astra— GPT Astra 6 bilan Codex uchungpt-6-1-sol— GPT Sol 6.1 bilan Codex uchunclaude-opus-5-5— Claude Opus bilan Claude Code uchunclaude-sonnet-5-5— Claude Sonnet bilan Claude Code uchunantigravity-gemini-3-8-flash-high— Gemini Flash bilan Antigravity uchundeepseek-v4-1-flash— DeepSeek Flash bilan DeepSeek Harness uchunqwen3-8-max-0902— Qwen Max bilan Qwen Code uchunkimi-k3— Kimi K3 bilan Kimi Code uchun
Tezkor ishga tushirish jarayonini bajarish
Benchmark har bir konfiguratsiya uchun bir xil jarayondan foydalanadi. Avval agent identifikatorini AGENT qobiq o‘zgaruvchisiga biriktiring:
AGENT=gpt-6-1-solKeyin mahalliy konfiguratsiyani saqlang:
python3 -m benchmark setup --agent "$AGENT"
Tanlangan klient va autentifikatsiya tayyorligini tekshiring:
python3 -m benchmark cli-check --agent "$AGENT"Tekshiruv ready_for_trial holatini qaytarganda, joriy topshiriq tanlovi yordamida paketni ishga tushiring:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT"
Odatiy holatda paket bajarilishi 70 ta topshiriq va 83 ta bosqichni modelga so‘rov yubormasdan oldindan ko‘rsatadi. Hisobingizdagi limitdan foydalanishga tayyor bo‘lganingizda --execute parametrini qo‘shing:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
  --execute
cli-check muvaffaqiyatli yakunlangach, avval bitta sinov topshirig‘idan boshlang. Bu to‘liq paketni ishga tushirishdan oldin klient, autentifikatsiya rejimi, sandbox va chiqish manzili to‘g‘ri ishlashini tasdiqlashga yordam beradi.
Bir nechta konfiguratsiyani ishga tushirish
Har bir mijozni alohida sozlang va tekshiring, so‘ngra paketli buyruqqa bir nechta --agent parametrlarini uzating. Turli konfiguratsiyalar natijalari bir-birining ustiga yozilmasligi uchun yangi chiqish katalogidan foydalaning.
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
Har bir konfiguratsiyaning autentifikatsiya rejimini reyestrda ko‘rsatilgan mijozga mos holda saqlang. Obunaga asoslangan konfiguratsiya u qo‘llab-quvvatlaydigan obuna orqali kirish usulidan, API konfiguratsiyasi esa talab qilinadigan API ma’lumotlaridan foydalanishi kerak.
Vazifalar va natijalarni ko‘rib chiqish
Vazifalar indeksi config/selections/current.json manzilida mavjud. Savollar, mezonlar va baholash ta’riflari uchun Savollar va baholash, ma’lumotlar formati bo‘yicha qo‘llanma hamda baholash qoidalarini ko‘rib chiqing.
Chop etilgan natijalar bir nechta shaklda mavjud:
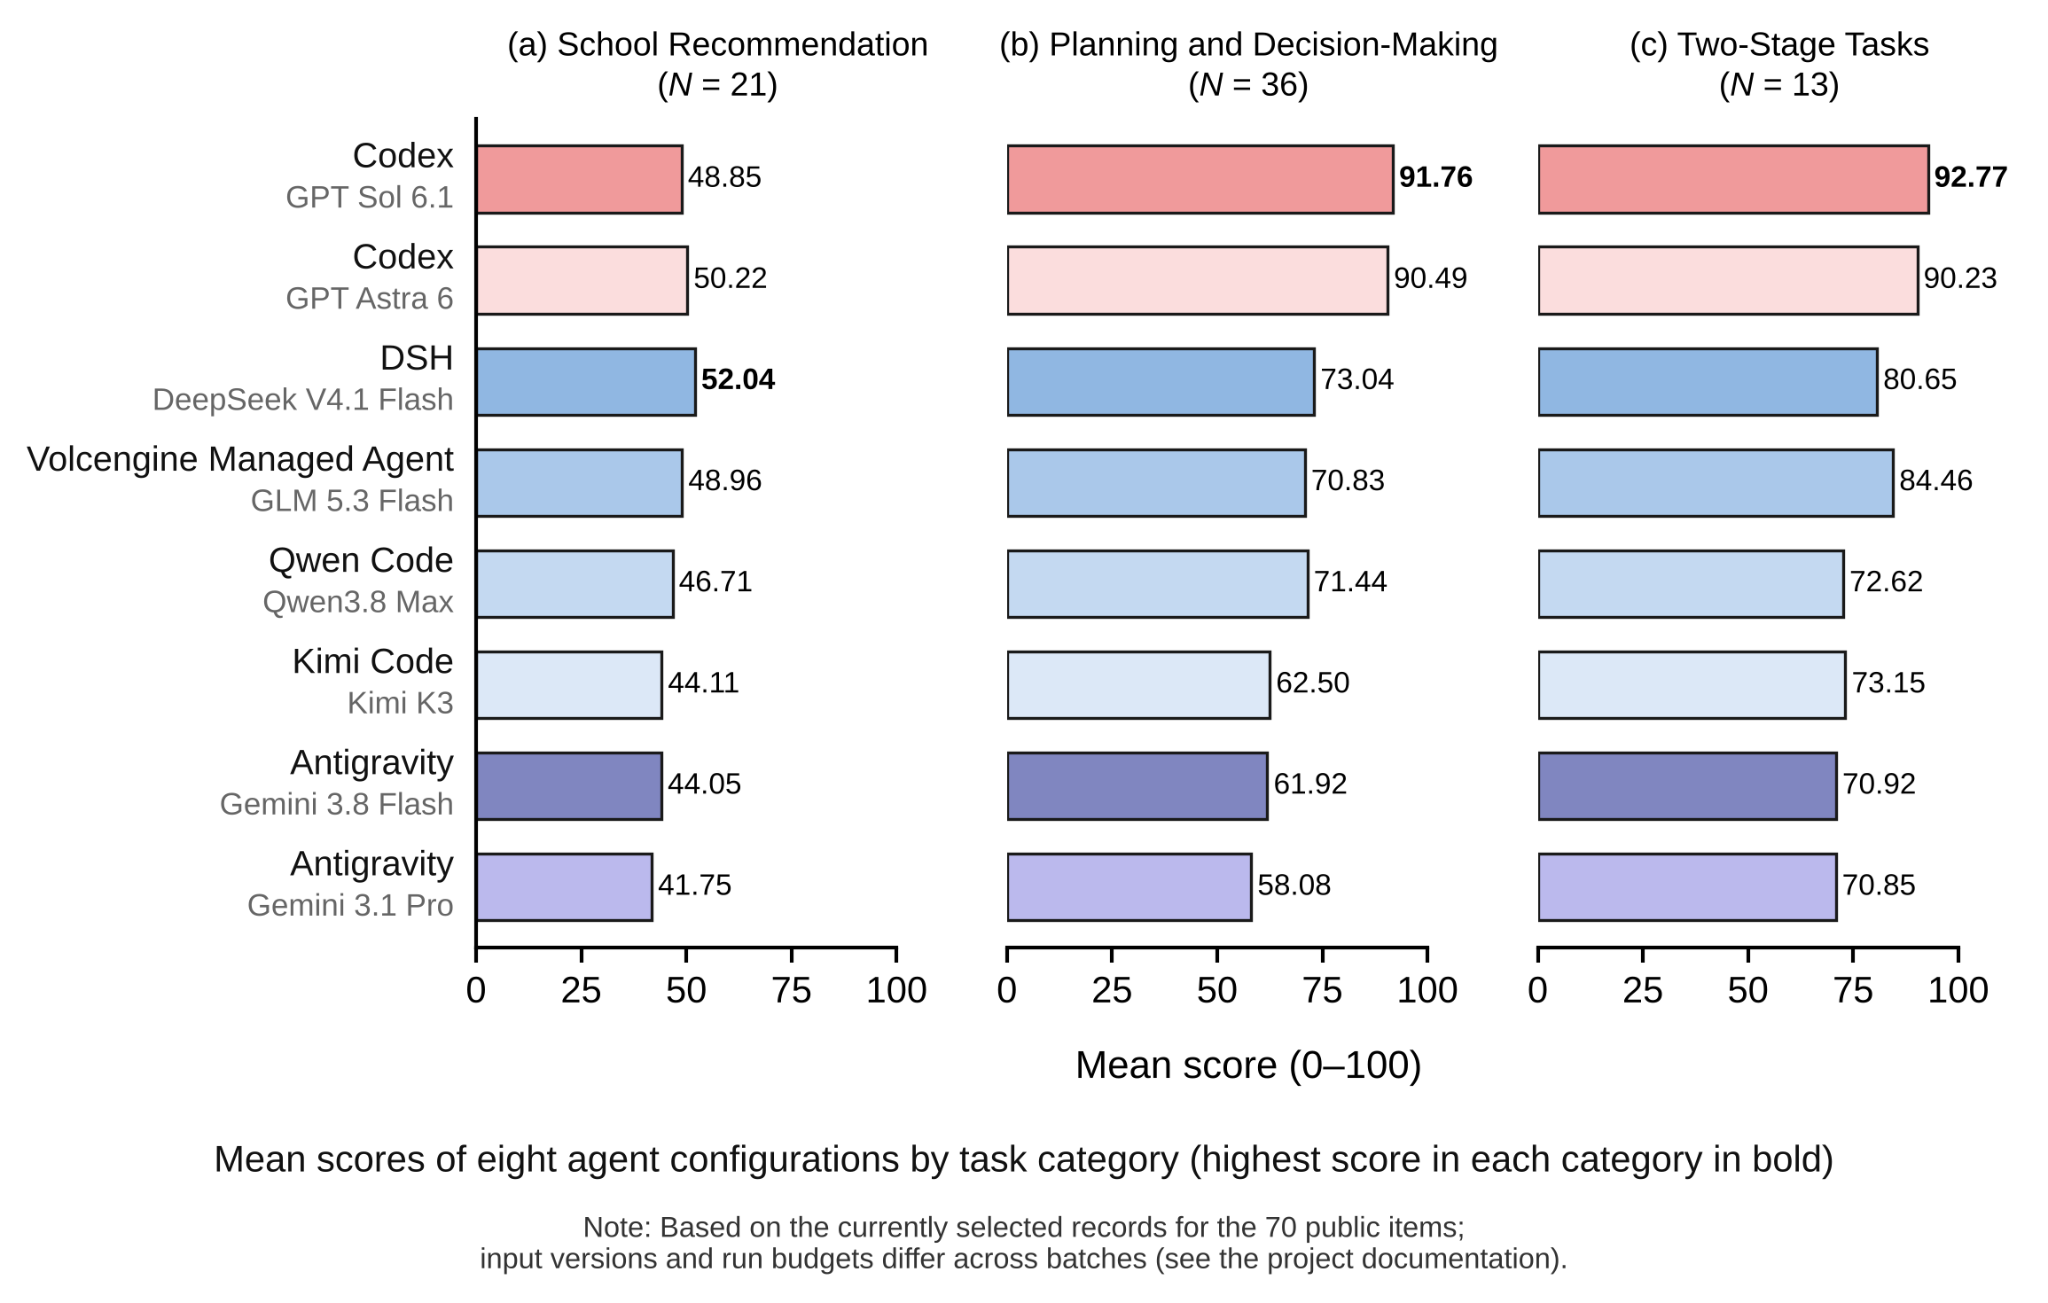
- Umumiy natijalar uchun Natijalar xulosasi.
- Vazifalar darajasidagi batafsil yozuvlar uchun Har bir vazifa natijalari.
- Ommaviy javob matni va baholash ma’lumotlari uchun Konfiguratsiyalar bo‘yicha javoblar va natijalar.
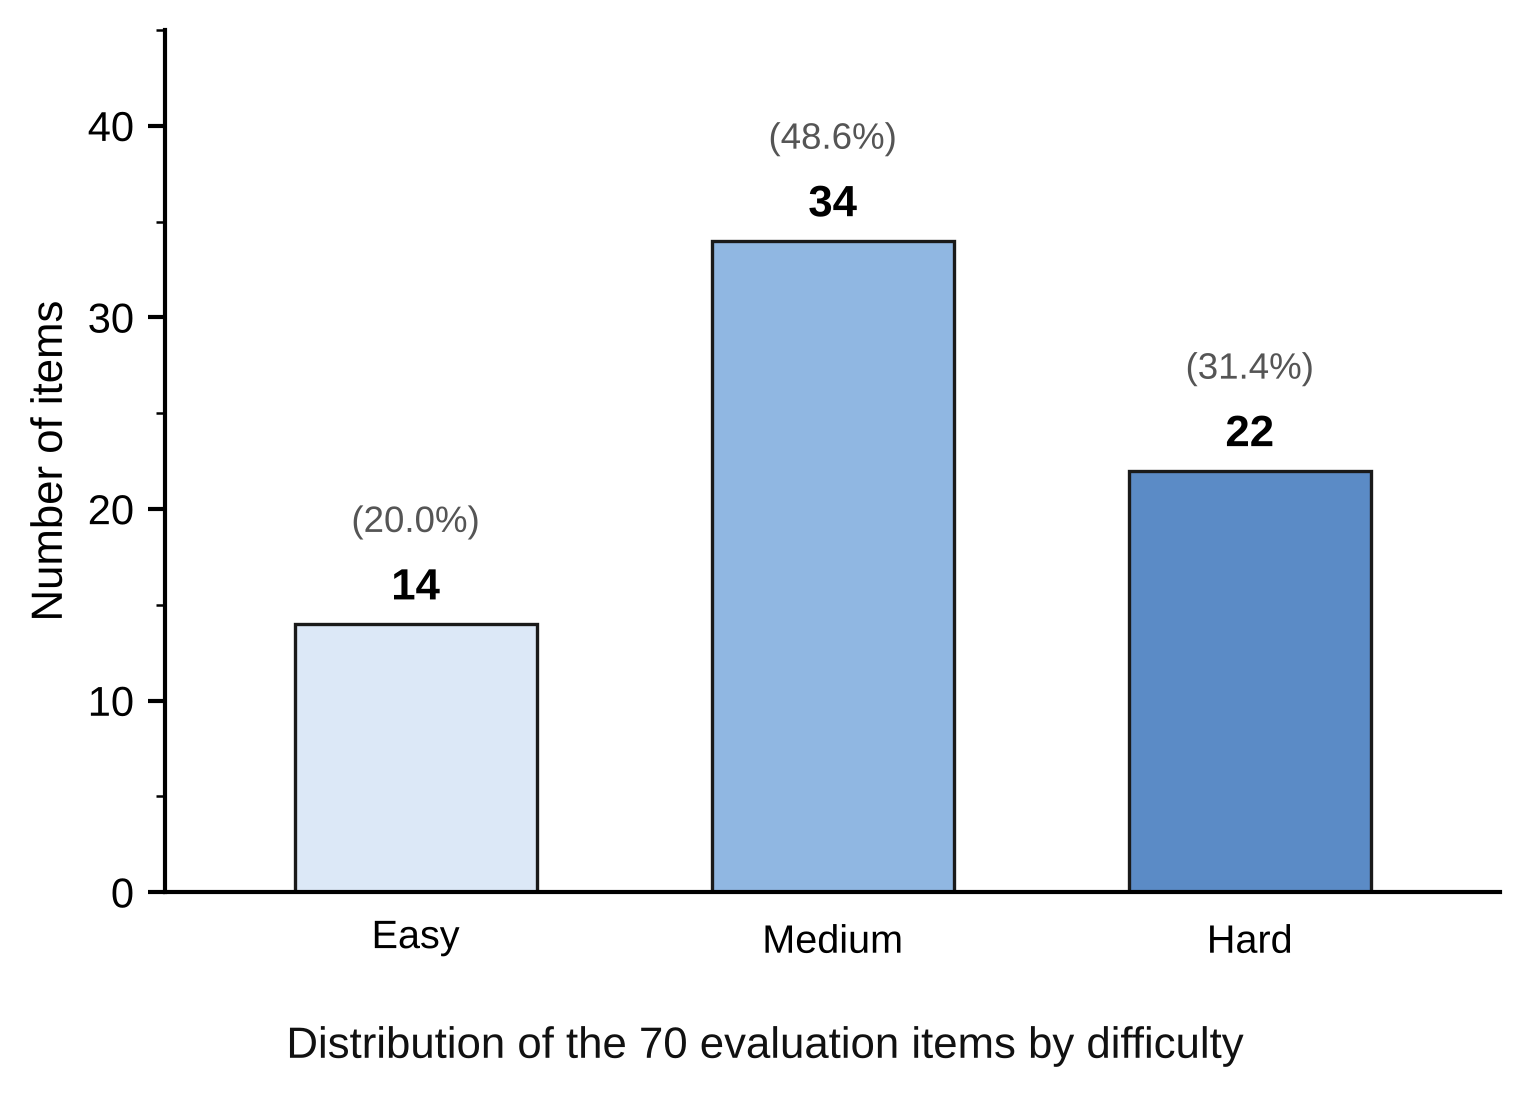
Chop etilgan reyting jadvalida baholangan sakkizta konfiguratsiya bo‘yicha o‘rtacha natijalar va yakunlash ko‘rsatkichlari keltirilgan. Repozitoriyda joriy vazifalar uchun qiyinlik belgilari ham qayd etilgan: 14 ta oson, 34 ta o‘rta va 22 ta qiyin. Bu belgilar o‘qituvchilar kalibrlashi orqali mas’ul shaxs tomonidan tasdiqlangan bo‘lib, mustaqil ikki tomonlama ko‘rib chiqish sifatida taqdim etilmaydi.
Baholash va ko‘rib chiqish bo‘yicha maslahatlar
Baholash eksport qilingan materiallarni ko‘rib chiqish uchun alohida Codex obuna sessiyasidan foydalanishi mumkin. Ixtiyoriy API orqali baholash qo‘shimcha sozlamalarni talab qiladi. Javob berish jarayonini baholash materiallaridan alohida saqlang, chunki rubrikalar yoki ma’lumotnoma dasturlarini baholanayotgan agentga oshkor qilish taqqoslashni haqiqiy emas deb topishga olib kelishi mumkin.
O‘z ishga tushirishlaringizni taqqoslaganda agent ID raqami, mijoz versiyasi, kirish ma’lumotlari versiyasi, bajarish budjeti, chiqish katalogi va tegishli kontent xeshlarini qayd eting. Loyiha ommaviy reyting jadvalidagi ishga tushirishlarning barchasi bir xil bajarish sharoitlariga ega emasligi haqida ogohlantiradi. Shu sababli natijalarni ularning metodologiyasi va ishga tushirish yozuvlari bilan birga taqqoslang.
Qayta ishlab bo‘ladigan tajribalar uchun muzlatilgan kirish ma’lumotlari, topshiriqlar va natijalarni tekshirishni qamrab oluvchi qayta ishlab chiqish qo‘llanmasiga amal qiling. Metodologiya hujjatlari baholash sozlamalari va cheklovlarini tushuntiradi, native CLI qo‘llanmasi esa o‘rnatish, autentifikatsiya va bir nechta bosqichlar haqida batafsil ma’lumot beradi.
Xulosa
Graduate Admissions Agent Benchmark qabul agentlari aniq tavsiyalar, foydali rejalashtirish maslahatlari va talaba sharoitlari o‘zgarganda tegishli yangilanishlarni taqdim eta oladimi-yo‘qmi, buni sinashning tizimli usulini beradi. Qo‘llab-quvvatlanadigan mijozni sozlang, reyestrdan agent ID raqamini tanlang, uni cli-check bilan tekshiring, paketli ishga tushirishni oldindan ko‘ring, so‘ngra sinovlar yoki to‘liq baholashlarni bajaring. Natijalarni mas’uliyat bilan talqin qilish va taqqoslashlarni qayta ishlab chiqish uchun e’lon qilingan vazifa ta’riflari, natijalar va metodologiya hujjatlaridan foydalaning.