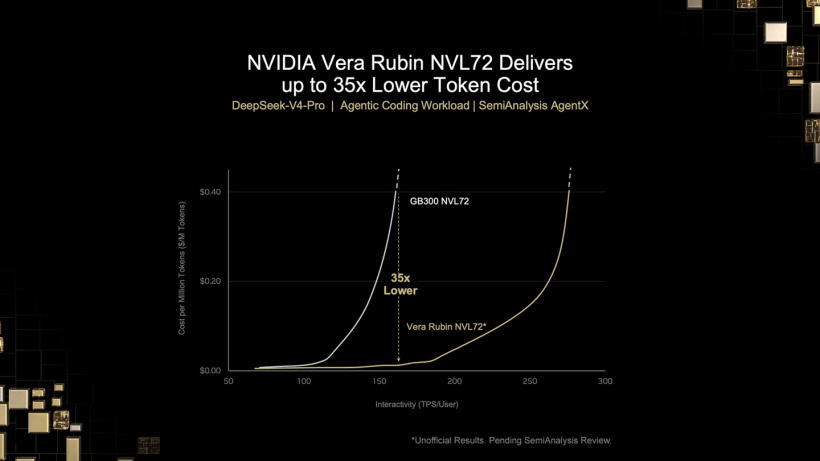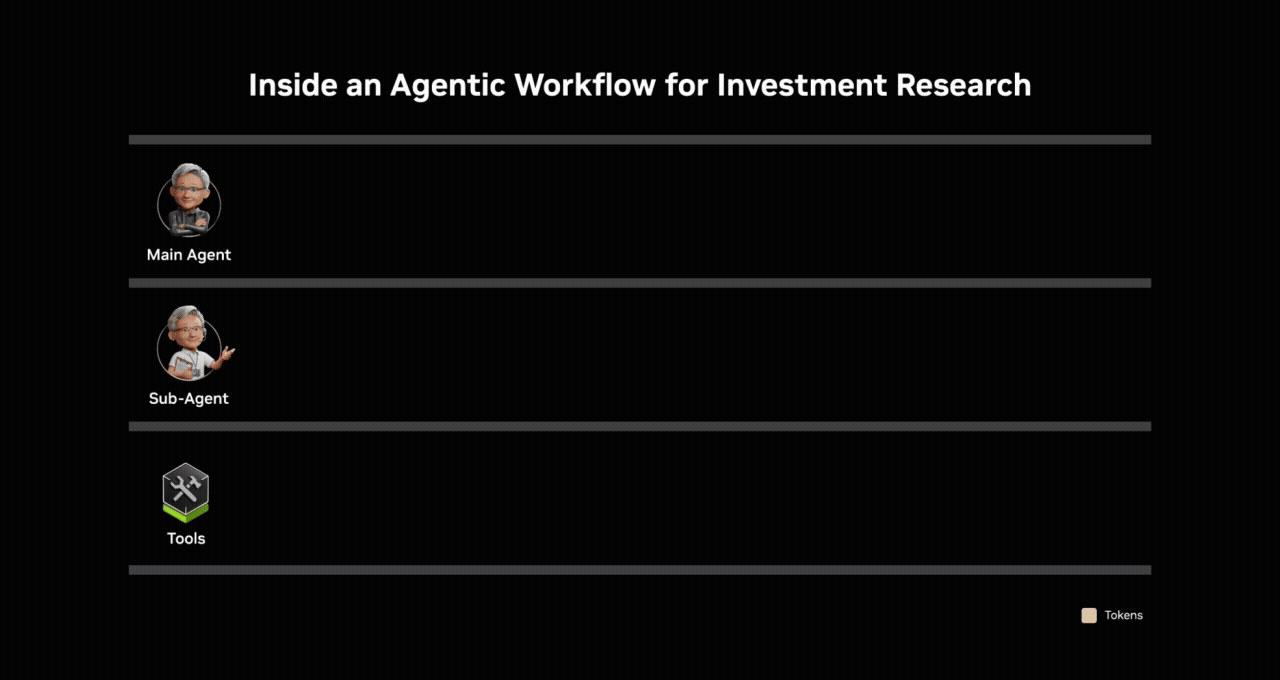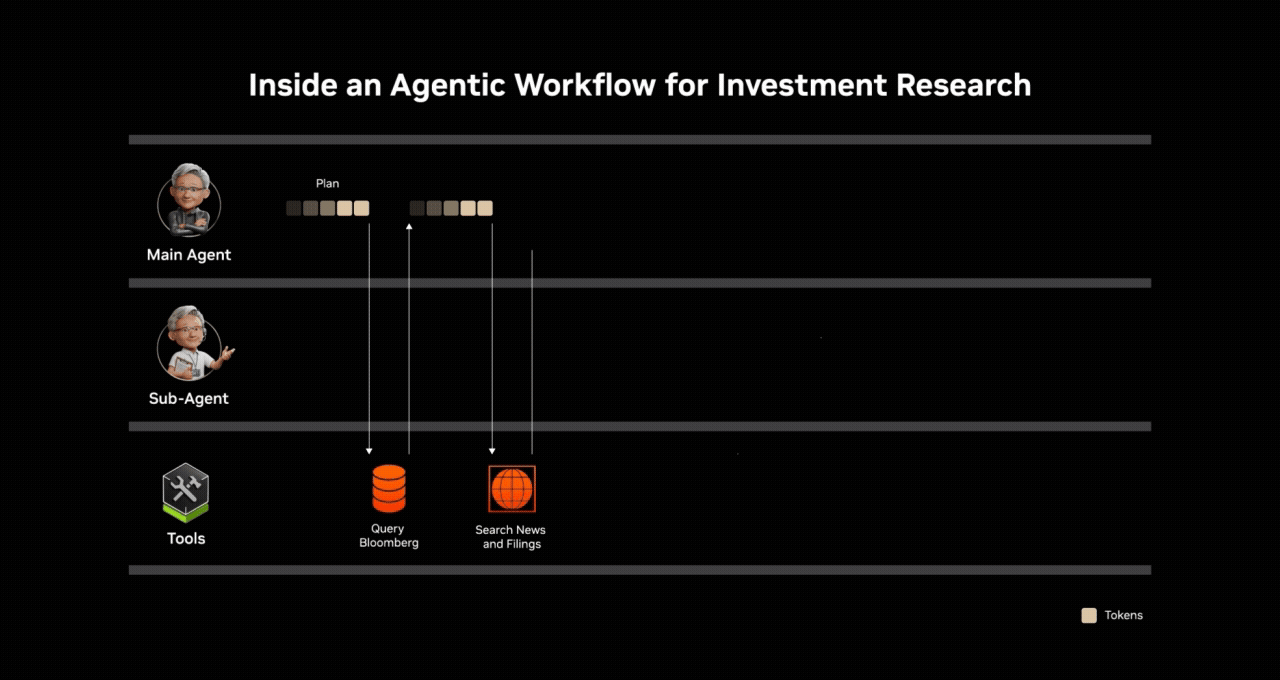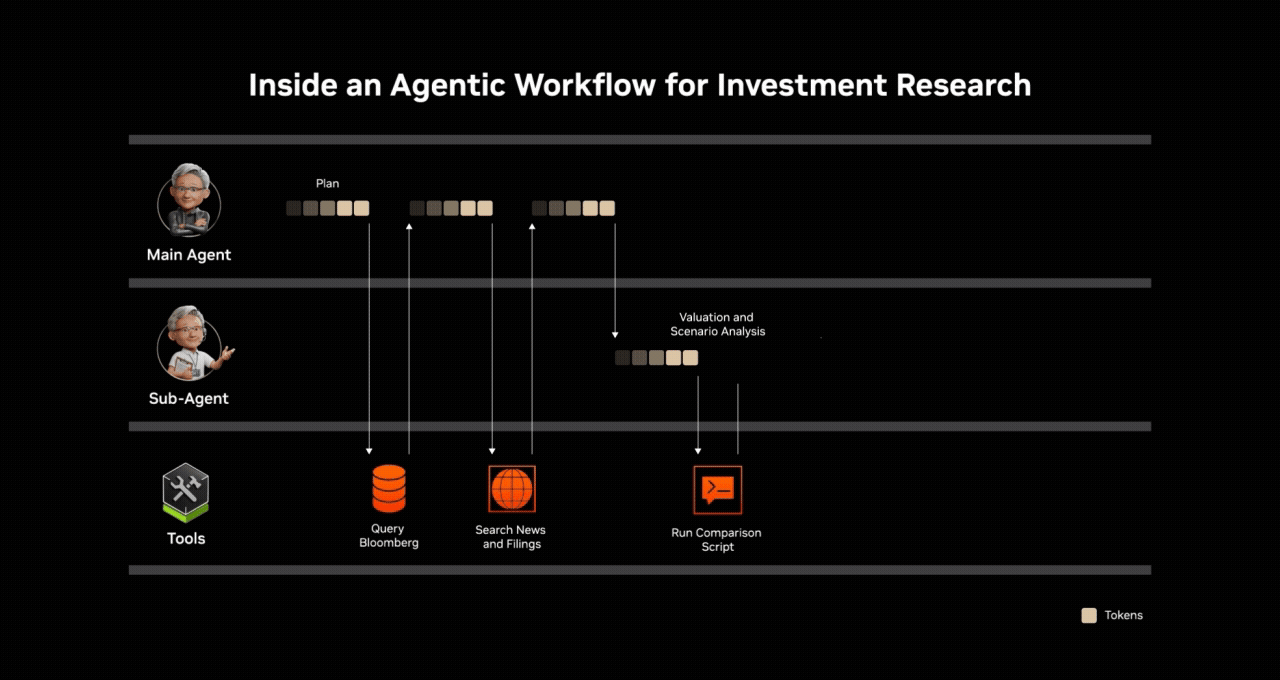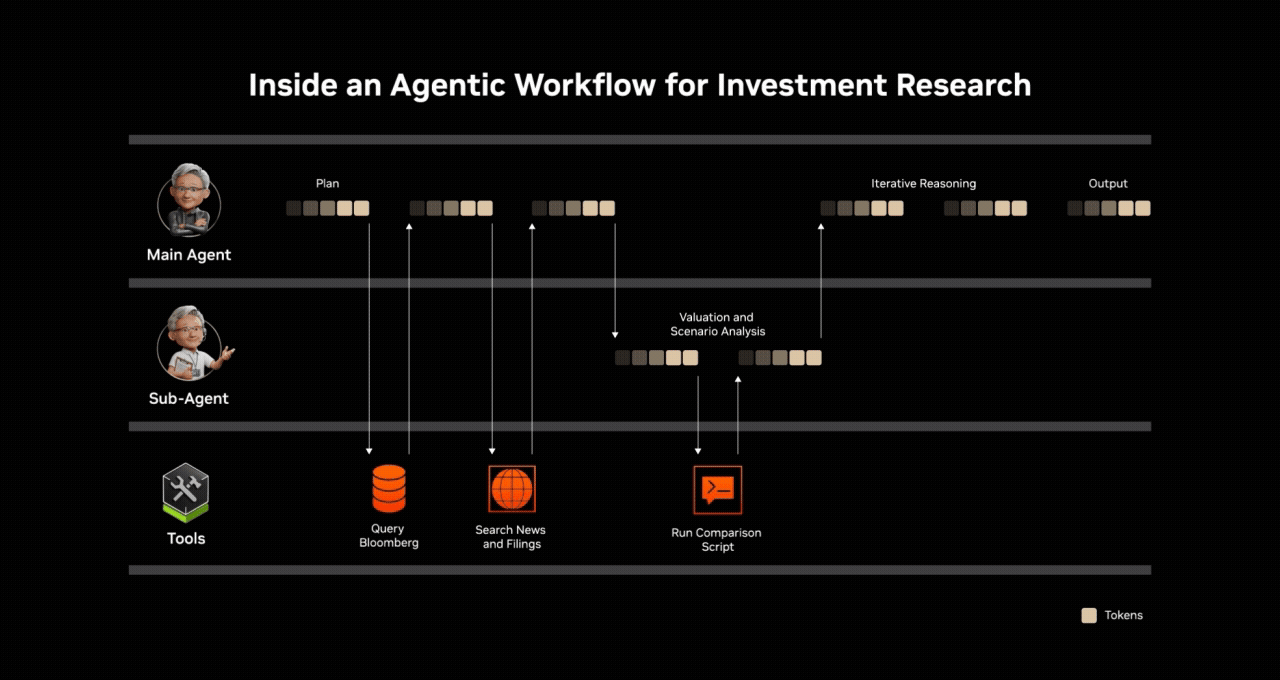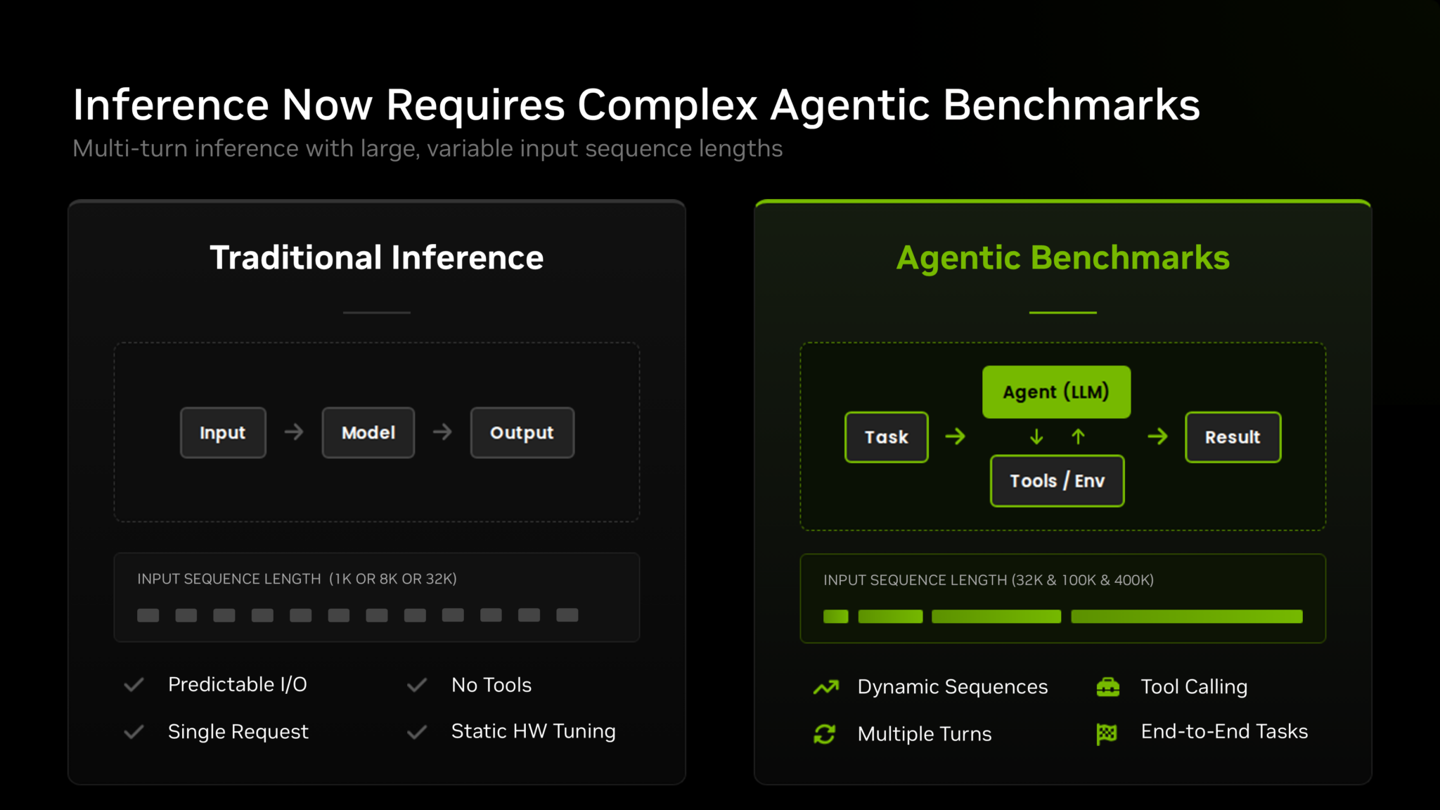
Hôm qua, NVIDIA đã sử dụng workload SemiAnalysis AgentX để đánh giá và thử nghiệm mô hình DeepSeek-v4-PRO 1.6T, cho thấy thông lượng trên mỗi megawatt của Vera Rubin đạt gấp 30 lần Blackwell.
Thông lượng trên mỗi megawatt (Tokens per Megawatt, viết tắt là tokens / MW) là chỉ số hiệu quả năng lượng cốt lõi, dùng để đo lượng AI Token mà một trung tâm dữ liệu AI có thể tạo ra trong giới hạn điện năng cố định.
Theo bài viết được IT之家 dẫn lại, SemiAnalysis AgentX đánh giá trọng tâm workload suy luận lập trình tác nhân thông qua 4 chỉ số:
Tính tương tác chuẩn hóa đầu-cuối được tính dựa trên toàn bộ thời gian từ lúc gửi yêu cầu đến khi Token cuối cùng đến nơi, phản ánh hiệu quả đầu ra mà người dùng có thể thấy, bao gồm cả thời gian chờ Token đầu tiên;
Tính tương tác tiêu chuẩn chỉ tính giai đoạn tạo từ Token đầu tiên đến Token cuối cùng.
Độ trễ đầu-cuối thống kê tổng thời gian từ khi gửi một yêu cầu đến khi Token đầu ra cuối cùng đến nơi
Độ trễ Token đầu tiên (TTFT) thống kê thời gian từ khi gửi yêu cầu đến khi Token đầu ra đầu tiên đến nơi.
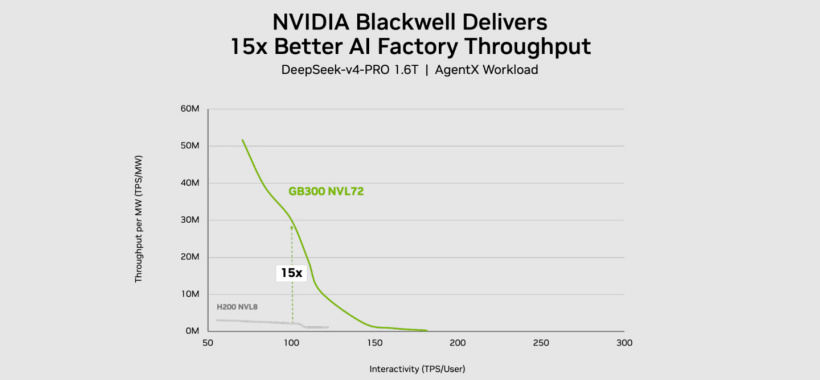
Trong workload DeepSeek-v4-PRO 1.6T, máy chủ Grace Blackwell sử dụng GB300 NVL72 đạt thông lượng mỗi megawatt gấp 15 lần giải pháp H200 NVL8 Hopper.
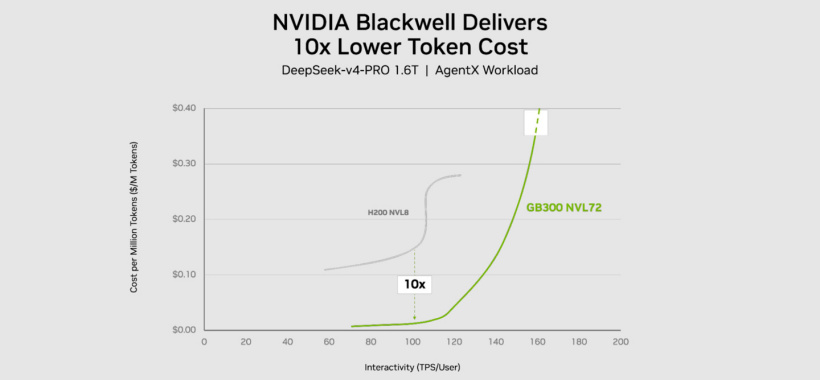
Chi phí cho mỗi triệu Token của Blackwell chỉ bằng khoảng 1/10 thế hệ trước, giúp các nhà vận hành hỗ trợ nhiều tác nhân hơn với cùng ngân sách điện năng và cơ sở hạ tầng, hoặc duy trì cùng quy mô tác nhân với chi phí vận hành thấp hơn.
Vera Rubin tiếp tục mở rộng lợi thế này. Trên mô hình DeepSeek V4 Pro, thông lượng mỗi megawatt của Vera Rubin NVL72 cao hơn khoảng 30 lần so với GB300 NVL72.
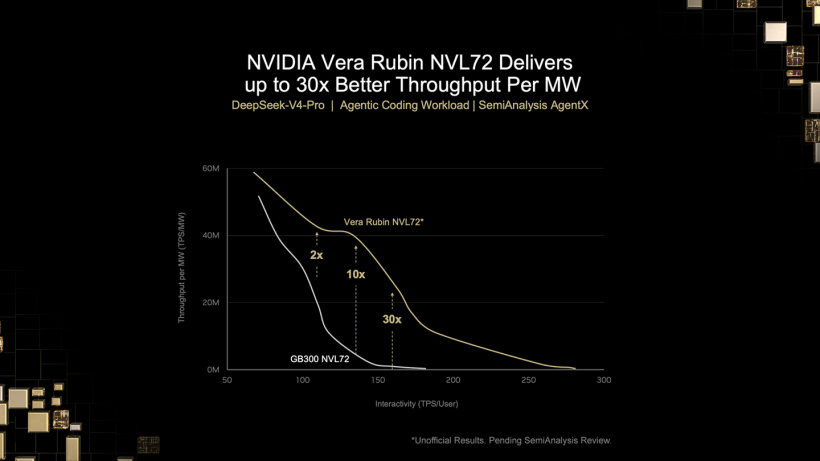
Chi phí cho mỗi triệu Token của Vera Rubin NVL72 chỉ bằng 1/35 GB300 NVL72, cho phép vận hành các tác nhân liên tục ở quy mô lớn, đáp ứng nhu cầu về nhiều loại workload của khách hàng.