

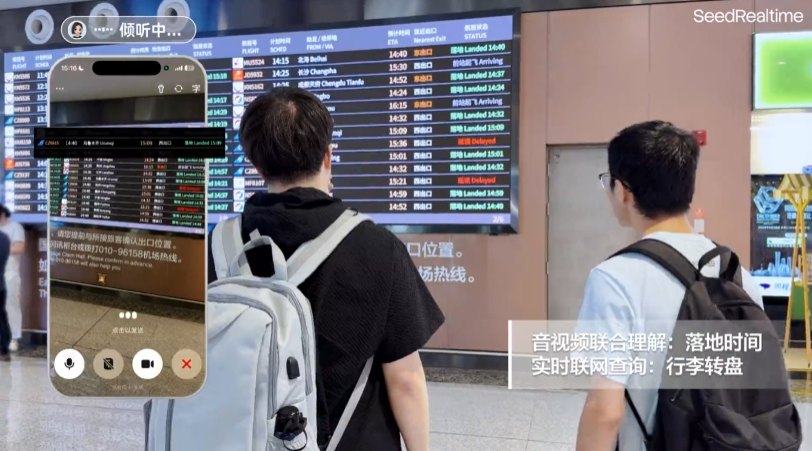
ByteDance hôm nay thông báo ra mắt mô hình AI song công toàn phần âm thanh và video nguyên bản SeedRealtime, hướng tới tương tác tự nhiên đa phương thức toàn diện.
SeedRealtime kết hợp nguyên bản âm thanh, video và văn bản bằng một kiến trúc thống nhất, cho phép tương tác theo thời gian thực trên luồng thông tin đa phương thức liên tục, mang đến trải nghiệm mới “vừa xem, vừa nghe, vừa nói”. Mô hình đạt được ba đột phá cốt lõi sau:
Hiểu âm thanh và video kết hợp: Hỗ trợ nguyên bản việc hợp nhất sâu âm thanh, hình ảnh và thông tin thời gian. Mô hình có thể dựa vào bối cảnh để phân biệt các từ đồng âm, đồng thời hiểu chính xác các quy chiếu theo trình tự thời gian trong hình ảnh, kết hợp những gì nhìn thấy, nghe thấy và nói ra thành một thể thống nhất.
Khả năng tương tác chủ động: Có khả năng nhận biết môi trường liên tục và chủ động thể hiện. Khi nhận thấy trạng thái hình ảnh thay đổi, chẳng hạn mục tiêu quan trọng xuất hiện, mô hình có thể chủ động nhắc nhở; đồng thời có thể gọi công cụ để hỗ trợ biểu đạt, nâng cấp tương tác từ phản hồi bị động lên phối hợp chủ động.
Nhịp điệu tương tác mượt mà: Có thể nhận biết theo thời gian thực trạng thái hội thoại và nhịp giao tiếp của người dùng, tự nhiên tiếp lời, ngắt và phản hồi vào thời điểm thích hợp. Mô hình cũng có khả năng chống nhiễu mạnh, phân biệt cuộc trò chuyện của người xung quanh với tiếng ồn nền, không bị kích hoạt nhầm bởi nhiễu và duy trì giao tiếp liền mạch.
Kết quả đánh giá thủ công đầu cuối cho thấy, so với mô hình dạng chuỗi, các vấn đề về nhịp hội thoại âm thanh và video của SeedRealtime đã giảm một nửa. Mô hình nắm bắt thời điểm nói tự nhiên hơn, các hiện tượng gián đoạn như “bị ngắt lời khi chưa nói xong, phản hồi chậm sau khi người dùng đã nói xong, hoặc bị kích hoạt nhầm bởi tiếng ồn nền và cuộc trò chuyện xung quanh” giảm đáng kể; đồng thời, xác suất hoàn thành một cuộc hội thoại trọn vẹn và mượt mà cũng tăng rõ rệt.
Hiện SeedRealtime đã được triển khai rộng rãi trên ứng dụng Doubao, trở thành công nghệ song công toàn phần âm thanh và video đầu tiên trong ngành được áp dụng ở quy mô lớn. Hãy cập nhật ứng dụng Doubao lên phiên bản mới nhất, chọn “Gọi điện” trong khung hội thoại để vào giao diện cuộc gọi video và trải nghiệm.
Địa chỉ trang chủ dự án:
https://seed.bytedance.com/seedrealtime