

Hôm nay, Alibaba đã ra mắt mô hình nhận dạng giọng nói Qwen-Audio-3.0-ASR-Flash. Nói một cách đơn giản, mô hình giúp AI hiểu tốt hơn các thuật ngữ chuyên ngành.
Qwen-Audio-3.0-ASR-Flash được tối ưu hóa có hệ thống trên ba phương diện: tính nhất quán ngữ cảnh, nhận dạng thuật ngữ ngành và tùy chỉnh từ khóa. Mô hình cũng có khả năng tinh chỉnh lời nói, có thể trực tiếp xuất văn bản có cấu trúc.
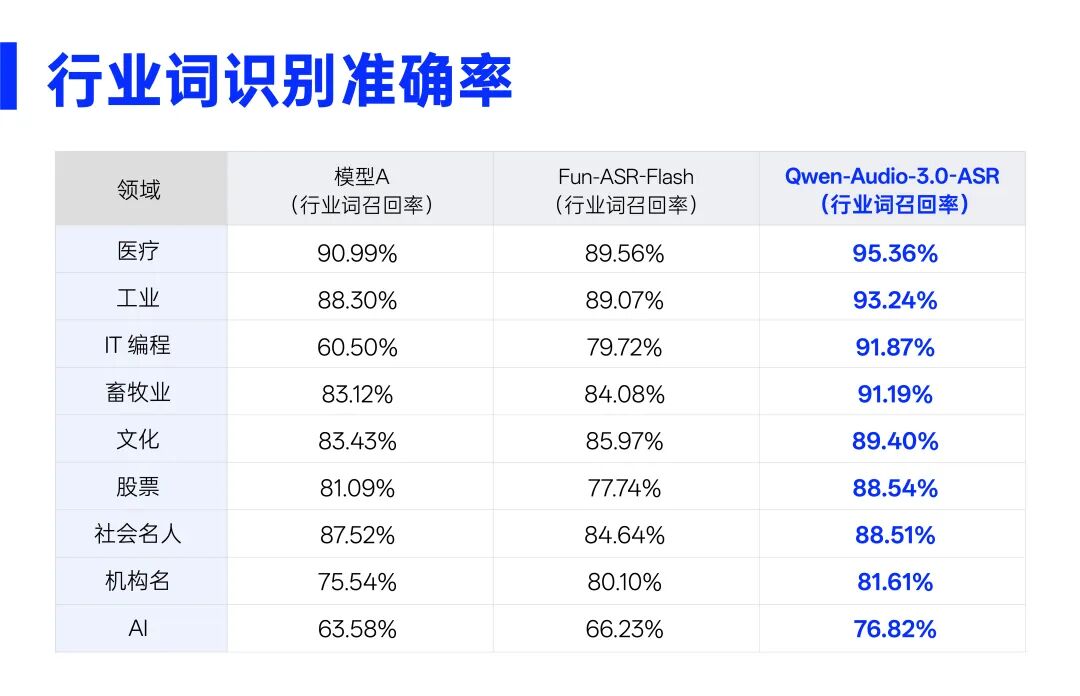
Nhóm nghiên cứu liên tục khai thác các thuật ngữ chuyên ngành trong những lĩnh vực như y tế, lập trình IT, cổ phiếu và nhân vật nổi tiếng trong xã hội, xây dựng kho từ vựng chất lượng cao bao phủ nhiều ngành, qua đó tăng cường khả năng nhận dạng thuật ngữ chuyên môn và từ hiếm của mô hình. Trong đánh giá nội bộ mới nhất về từ vựng ngành, mô hình mới đạt mức cải thiện rõ rệt về “tỷ lệ nghe hiểu” các thuật ngữ chuyên ngành trong mọi lĩnh vực, trong đó bối cảnh y tế đã vượt 95.36%.
Hiện nay, dòng Qwen-Audio-ASR-Flash đã được kiểm chứng trong các tình huống như tổng hợp biên bản cuộc họp, phụ đề thời gian thực, ghi hình bài giảng giáo dục và chăm sóc khách hàng thông minh. Trên nền tảng đánh giá AI Artificial Analysis, dòng sản phẩm này từng giành vị trí số một thế giới với tỷ lệ lỗi ký tự 1.7%.
Qwen-Audio-3.0-ASR — hiện đã được mở để gọi qua nền tảng Alibaba Cloud Bailian, cung cấp ba phiên bản:
Qwen-Audio-3.0-ASR-Flash: nhận dạng giọng nói, thời lượng tối đa 5 phút
Qwen-Audio-3.0-ASR-Filetrans: chuyển lời tệp ngoại tuyến
Qwen-Audio-3.0-ASR-Streaming: nhận dạng giọng nói thời gian thực
Địa chỉ trải nghiệm Qwen-Audio-3.0-ASR-Flash:
Qwen-Audio-3.0-ASR-Flash:
https://help.aliyun.com/zh/model-studio/non-real-time-speech-recognition-for-fun-asr-flash
Qwen-Audio-3.0-ASR-Flash-Filetrans:
https://help.aliyun.com/zh/model-studio/fun-asr-recorded-speech-recognition-http-api
Qwen-Audio-3.0-ASR-Flash-Streaming:
https://help.aliyun.com/zh/model-studio/fun-asr-realtime-websocket-api