

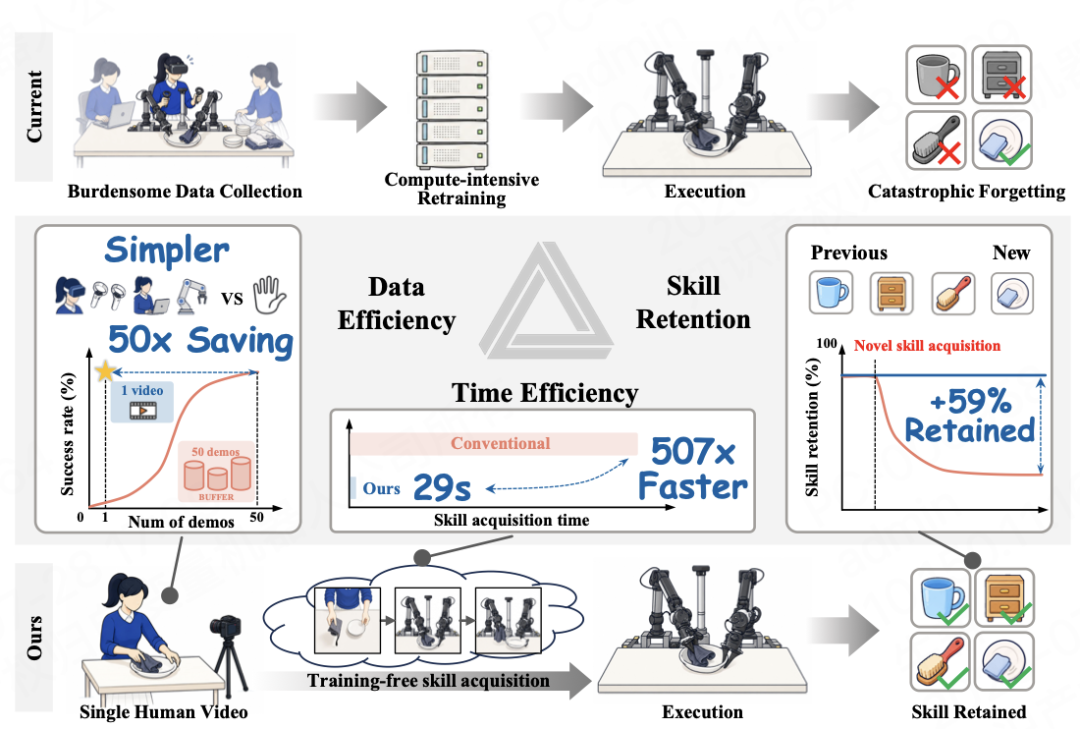
Robot Zi-variable hôm nay phát hành và mã nguồn mở framework HOST (Human-to-robot One-Shot Skill AcquisiTion, tiếp thu kỹ năng một lần từ người sang robot), tuyên bố framework này “giúp robot chỉ cần quan sát một video con người dài vài chục giây là học được kỹ năng mới, đồng thời giữ lại các kỹ năng đã nắm vững”.
HOST sử dụng một phương pháp mang tính đột phá: thay vì dịch chuyển động của con người thành chuyển động của robot để bắt chước, robot sẽ hình dung trước kết quả sau khi thực hiện hành động, rồi phân tách kết quả đó để xác định các hành động cần thực hiện. Hiệu quả của phương pháp mới này rất đáng chú ý: tỷ lệ thành công khi robot học kỹ năng từ một video con người dài 29 giây lên tới 62%, vượt mức 45% của mô hình cơ sở zero-shot. So với phương án Pi-0.5 + tinh chỉnh, HOST giảm 50 lần lượng dữ liệu cần thiết và tăng 500 lần tốc độ học kỹ năng.
Ý tưởng của HOST bắt nguồn từ lý thuyết “học qua quan sát” trong khoa học nhận thức: khi đối mặt với một nhiệm vụ xa lạ, con người không cần học thông qua luyện tập trong thời gian dài hoặc thử hết mọi khả năng, mà sử dụng năng lực tiên nghiệm để mô phỏng trong não kết quả dự kiến của hành động, sau đó thực hiện hành động tương ứng. Lấy cảm hứng từ đó, nhóm nghiên cứu Zi-variable đã chuyển giải pháp học của HOST từ “vòng lặp tinh chỉnh trong quá trình huấn luyện” sang “tiếp thu kỹ năng trong quá trình suy luận”, giúp robot học kỹ năng mới bằng cách quan sát con người thực hiện nhiệm vụ.
Vấn đề đầu tiên robot cần giải quyết là: làm thế nào để căn chỉnh tiến độ thực hiện nhiệm vụ của chính mình với tiến độ trong video?
Ví dụ, cùng làm việc trong 10 giây, người trong video có thể đã thái xong rau và bắt đầu xào, trong khi robot vẫn đang thái rau. Nếu chỉ căn chỉnh theo thời gian, robot sẽ đánh mất tiến độ nhiệm vụ.
Để giải quyết vấn đề này, HOST sử dụng phương pháp “căn chỉnh theo tiến độ nhiệm vụ”. HOST chuyển từng khung hình trong video và từng bước thao tác của robot thành các vector trong cùng một không gian vector; sau đó sử dụng thuật toán “biến dạng thời gian động” để tự động căn chỉnh “khung hình thứ X trong video của con người” với “bước thao tác thứ Y của robot”. Nhờ vậy, ở mỗi bước thực hiện, robot luôn nhìn thấy khung hình phù hợp với tiến độ nhiệm vụ.
Nhờ phương pháp này, HOST giảm sai số thời gian khi căn chỉnh tiến độ nhiệm vụ xuống một bậc độ lớn, cho phép robot thực hiện nhiệm vụ đồng bộ chính xác với video minh họa.
Phần cốt lõi của HOST là một mô hình chính sách dạng cascade có khả năng dự đoán hình ảnh. Mô hình sử dụng kiến trúc MoT với hai chuyên gia, giống như “hai bộ não” được phân công rõ ràng: “bộ não thị giác” (chuyên gia video) chuyên xử lý hình ảnh video, xác định tiến độ nhiệm vụ và dự đoán khung cảnh tương lai; “bộ não hành động” (chuyên gia hành động) chịu trách nhiệm chuyển khung cảnh dự đoán thành các hành động cần thực hiện và điều khiển quá trình thực hiện.
Khi huấn luyện mô hình, nhóm Zi-variable chia quá trình huấn luyện thành hai giai đoạn: “tiền huấn luyện đồng thể” và “huấn luyện video người-robot”. Trong giai đoạn tiền huấn luyện đồng thể, robot học từ các video robot tự thực hiện nhiệm vụ để dự đoán trạng thái sau khi hoàn thành nhiệm vụ và tạo ra các hành động tương ứng. Trong giai đoạn huấn luyện video người-robot, robot tiếp tục học từ video con người minh họa, chuyển quá trình con người thực hiện nhiệm vụ thành kết quả nhiệm vụ dưới góc nhìn của robot, sau đó suy luận các hành động cần thiết để hoàn thành nhiệm vụ dựa trên kết quả mục tiêu, qua đó thực hiện việc chuyển giao kỹ năng từ minh họa của con người sang robot.
Hiện tại, toàn bộ bài nghiên cứu và mã nguồn của HOST đã được công khai. Trong tương lai, khi thực hiện công việc gia đình, robot có thể không cần đến quy trình thu thập và huấn luyện dữ liệu chuyên biệt mà vẫn học được kỹ năng mới thông qua những minh họa trực quan của con người.
Tham khảo
Trang dự án
Liên kết bài nghiên cứu
Liên kết Github
Liên kết Huggingface