

Hôm nay, MiniMax chính thức phát hành mã nguồn mở mô hình video đa năng thế hệ mới MiniMax H3.
Theo giới thiệu, MiniMax H3 là một hệ thống tạo nội dung toàn phương thức đa năng. Hệ thống có thể thống nhất hiểu ngữ cảnh đa phương thức bao gồm văn bản, hình ảnh, video và âm thanh, đồng thời tạo video có độ phân giải tối đa 2K, thời lượng tối đa 15 giây và âm thanh stereo gốc. Nhờ thiết kế hệ thống định hướng khả năng khái quát hóa tác vụ, H3 đã có năng lực hiểu và tạo ngữ cảnh đa phương thức trên diện rộng ngay từ giai đoạn tiền huấn luyện, nhờ đó có thể tuân thủ xuất sắc các chỉ dẫn đa phương thức phức tạp.
H3 hỗ trợ các thông số đầu vào và đầu ra sau:
Thời lượng đầu ra: 4–15 giây
Tỷ lệ khung hình đầu ra: hỗ trợ nhiều tỷ lệ khung hình, bao gồm nhưng không giới hạn ở 21:9, 16:9, 4:3, 1:1, 3:4 và 9:16
Độ phân giải đầu ra: hỗ trợ nhiều kích thước độ phân giải, mặc định đặt cạnh ngắn ở mức 768 pixel. Có thể tạo nội dung ở độ phân giải 2K bằng H3-Regenerate-2K
Tốc độ khung hình đầu ra: 24 FPS
Âm thanh đầu ra: stereo 32 kHz
Ngôn ngữ hội thoại được hỗ trợ: hỗ trợ ổn định 11 ngôn ngữ: tiếng Ả Rập, tiếng Trung, tiếng Anh, tiếng Pháp, tiếng Đức, tiếng Ý, tiếng Nhật, tiếng Hàn, tiếng Bồ Đào Nha, tiếng Nga và tiếng Tây Ban Nha. Các ngôn ngữ khác cũng được hỗ trợ ở các mức độ khác nhau.
Phiên bản mô hình và thông số đầu vào:
① H3-Base-FL2VA
Chế độ khung hình đầu và cuối: hỗ trợ đầu vào 0, 1 hoặc 2 hình ảnh:
Không nhập hình ảnh: chế độ tạo video từ văn bản;
Nhập hình ảnh khung hình đầu: chế độ tạo video từ khung hình đầu;
Nhập hình ảnh khung hình cuối: chế độ tạo video từ khung hình cuối;
Đồng thời nhập hình ảnh khung hình đầu và cuối: chế độ tạo video từ khung hình đầu và cuối
② H3-Base-Ref2VA
Chế độ tham chiếu toàn phương thức:
Hình ảnh: tối đa 9 ảnh;
Video: tối đa 3 đoạn; thời lượng mỗi đoạn phải từ 2–15 giây, tổng thời lượng không quá 15 giây;
Âm thanh: tối đa 3 đoạn. Âm thanh phải được nhập cùng hình ảnh hoặc video, không thể là đầu vào duy nhất; thời lượng mỗi đoạn phải từ 2–15 giây, tổng thời lượng không quá 15 giây;
Đầu vào hỗn hợp: tổng số tệp đầu vào của mọi loại tối đa 12 tệp
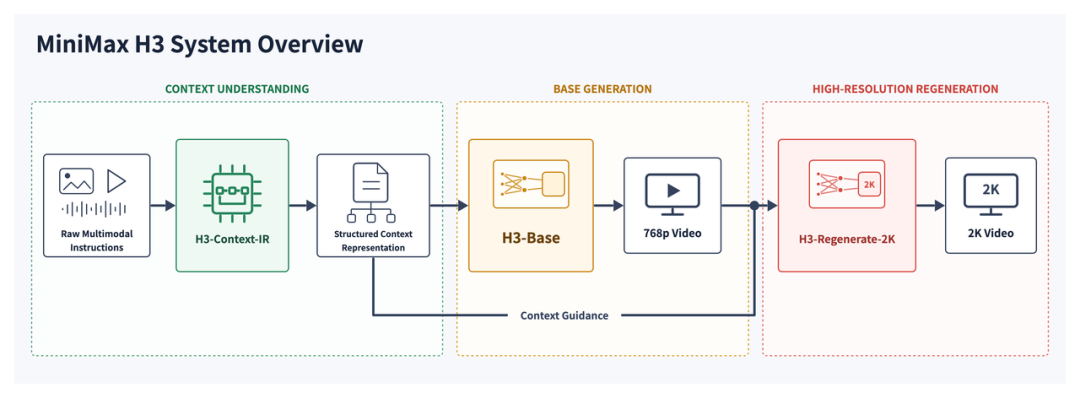
Hệ thống H3 hoàn chỉnh bao gồm ba mô-đun sau:
H3-Contex t-IR: Khi đầu vào ngày càng phức tạp, chúng tôi xây dựng một hệ thống chuyên dụng để hiểu và chắt lọc sâu các chỉ dẫn đa phương thức đầu vào, sau đó chuyển đổi chúng thành dạng mà H3 dễ hiểu hơn và có thể sử dụng trực tiếp cho việc tạo nội dung, tức Context Intermediate Representation (Biểu diễn trung gian ngữ cảnh). H3-Context-IR đóng vai trò rất quan trọng đối với chất lượng đầu ra cuối cùng. Vì vậy, chúng tôi đặc biệt khuyến nghị tích hợp API H3-Context-IR vào quy trình tạo nội dung. Ngoài ra, bạn có thể tham khảo hướng dẫn về câu lệnh để xây dựng hệ thống xử lý ngữ cảnh của riêng mình.
H3-Base: tạo âm thanh và video dựa trên đầu ra của H3-Context-IR, đồng thời xuất kết quả ở độ phân giải 768p.
H3-Regenerate-2K: đưa kết quả tạo ở 768p cùng ngữ cảnh gốc trở lại H3 để tạo lại đầu ra ở độ phân giải 2K. Cách này vừa phát huy năng lực tạo nội dung mạnh mẽ của H3, vừa tận dụng đầy đủ thông tin phong phú trong ngữ cảnh gốc, từ đó tạo ra kết quả độ phân giải cao với chi tiết chính xác hơn và độ trung thực hình ảnh cao hơn.
MiniMax H3 được phát hành theo MiniMax H3 Community License.
Địa chỉ mã nguồn mở: huggingface.co/MiniMaxAI/MiniMax-H3