

Tối nay, đội ngũ Alibaba Cloud Qianwen chính thức phát hành Qwen3.8-Flash. Đội ngũ Qianwen đồng thời phát hành trọng số mã nguồn mở của Qwen3.8-Flash-Next. Kiến trúc mới của Next sẽ là nguyên mẫu cho thế hệ mô hình Qwen4 hoàn toàn mới.
Đây là một mô hình MoE đa phương thức, với mô hình chính có 125B tham số, được trang bị thêm 51B N-gram Embedding; mỗi token kích hoạt 6B tham số. Mô hình hỗ trợ nguyên bản ngữ cảnh 262.144 token và có thể mở rộng lên 1M token thông qua YaRN.
Theo giới thiệu, Qwen3.8-Flash đã được nâng cấp toàn diện theo bốn hướng:
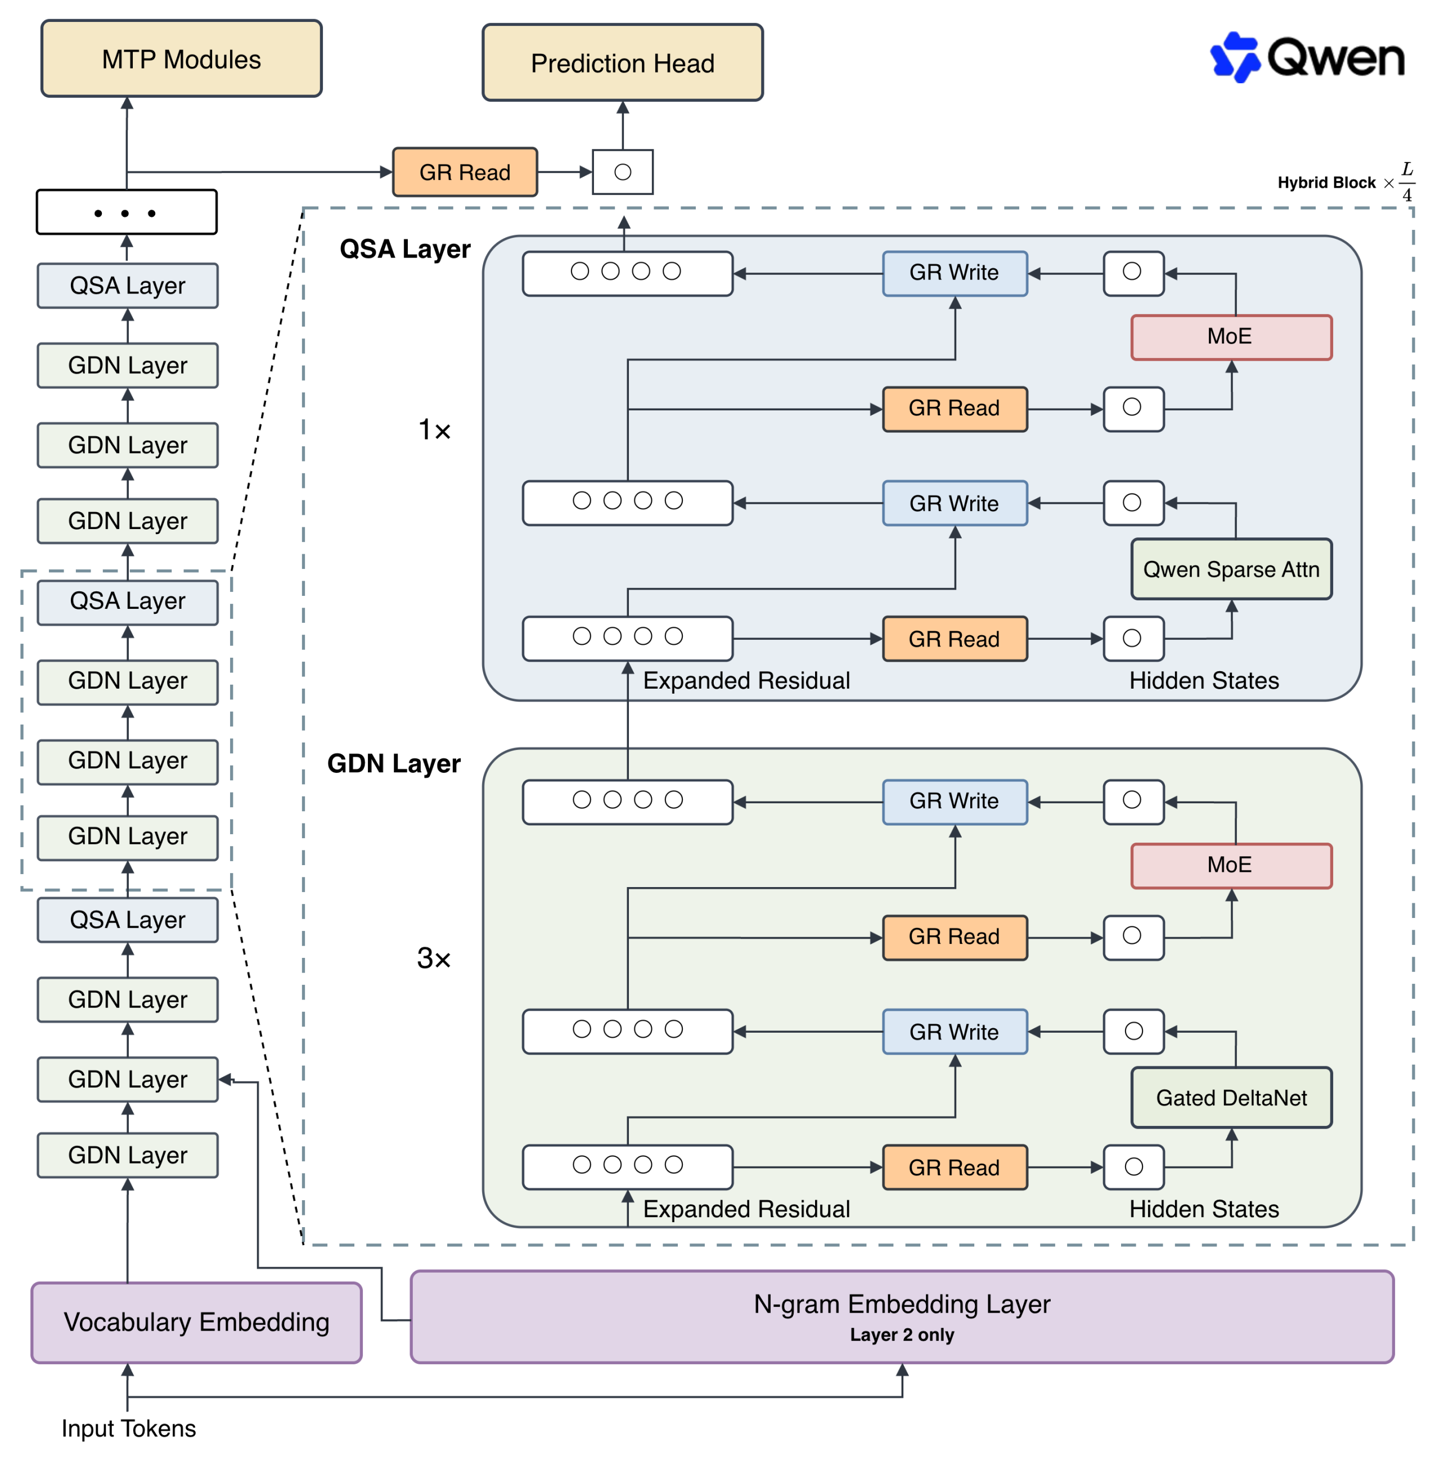
Về Attention, mô hình sử dụng kiến trúc kết hợp GDN (Gated DeltaNet) + QSA (Qwen Sparse Attention). GDN chịu trách nhiệm nén hiệu quả thông tin lịch sử, còn QSA sử dụng Indexer nhẹ để lọc ngữ cảnh quan trọng ở cấp micro-block, qua đó giảm đáng kể chi phí Attention trên chuỗi dài. Với ngữ cảnh siêu dài 1M token, Attention Kernel của QSA đạt mức tăng tốc tối đa lần lượt 7,6 lần và 4,9 lần trong các giai đoạn Prefill và Decode.
Về Residual, mô hình đưa vào cơ chế Gated Residual (GR), mở rộng luồng residual thành 4 nhánh song song và kiểm soát việc đọc ghi thông tin thông qua Gate động. Trạng thái residual hỗ trợ lưu trữ FP8, giúp giảm đáng kể chi phí truy cập bộ nhớ.
Về Embedding, mô hình đưa vào N-gram Embedding với 51B tham số, sử dụng tra cứu theo ngữ cảnh cục bộ để mở rộng dung lượng mô hình. Các tham số này có thể được chuyển sang Host Memory, chồng lấp với quá trình tính toán của mô hình thông qua Prefetch bất đồng bộ và không chiếm dụng lâu dài bộ nhớ GPU.
Về Optimization, mô hình sử dụng Muon Optimizer, đồng thời tối ưu các chiến lược về độ chính xác trực giao hóa, phân công tham số và tách ma trận hợp nhất. Scaling Law cũng được khớp lại cho kiến trúc mới.
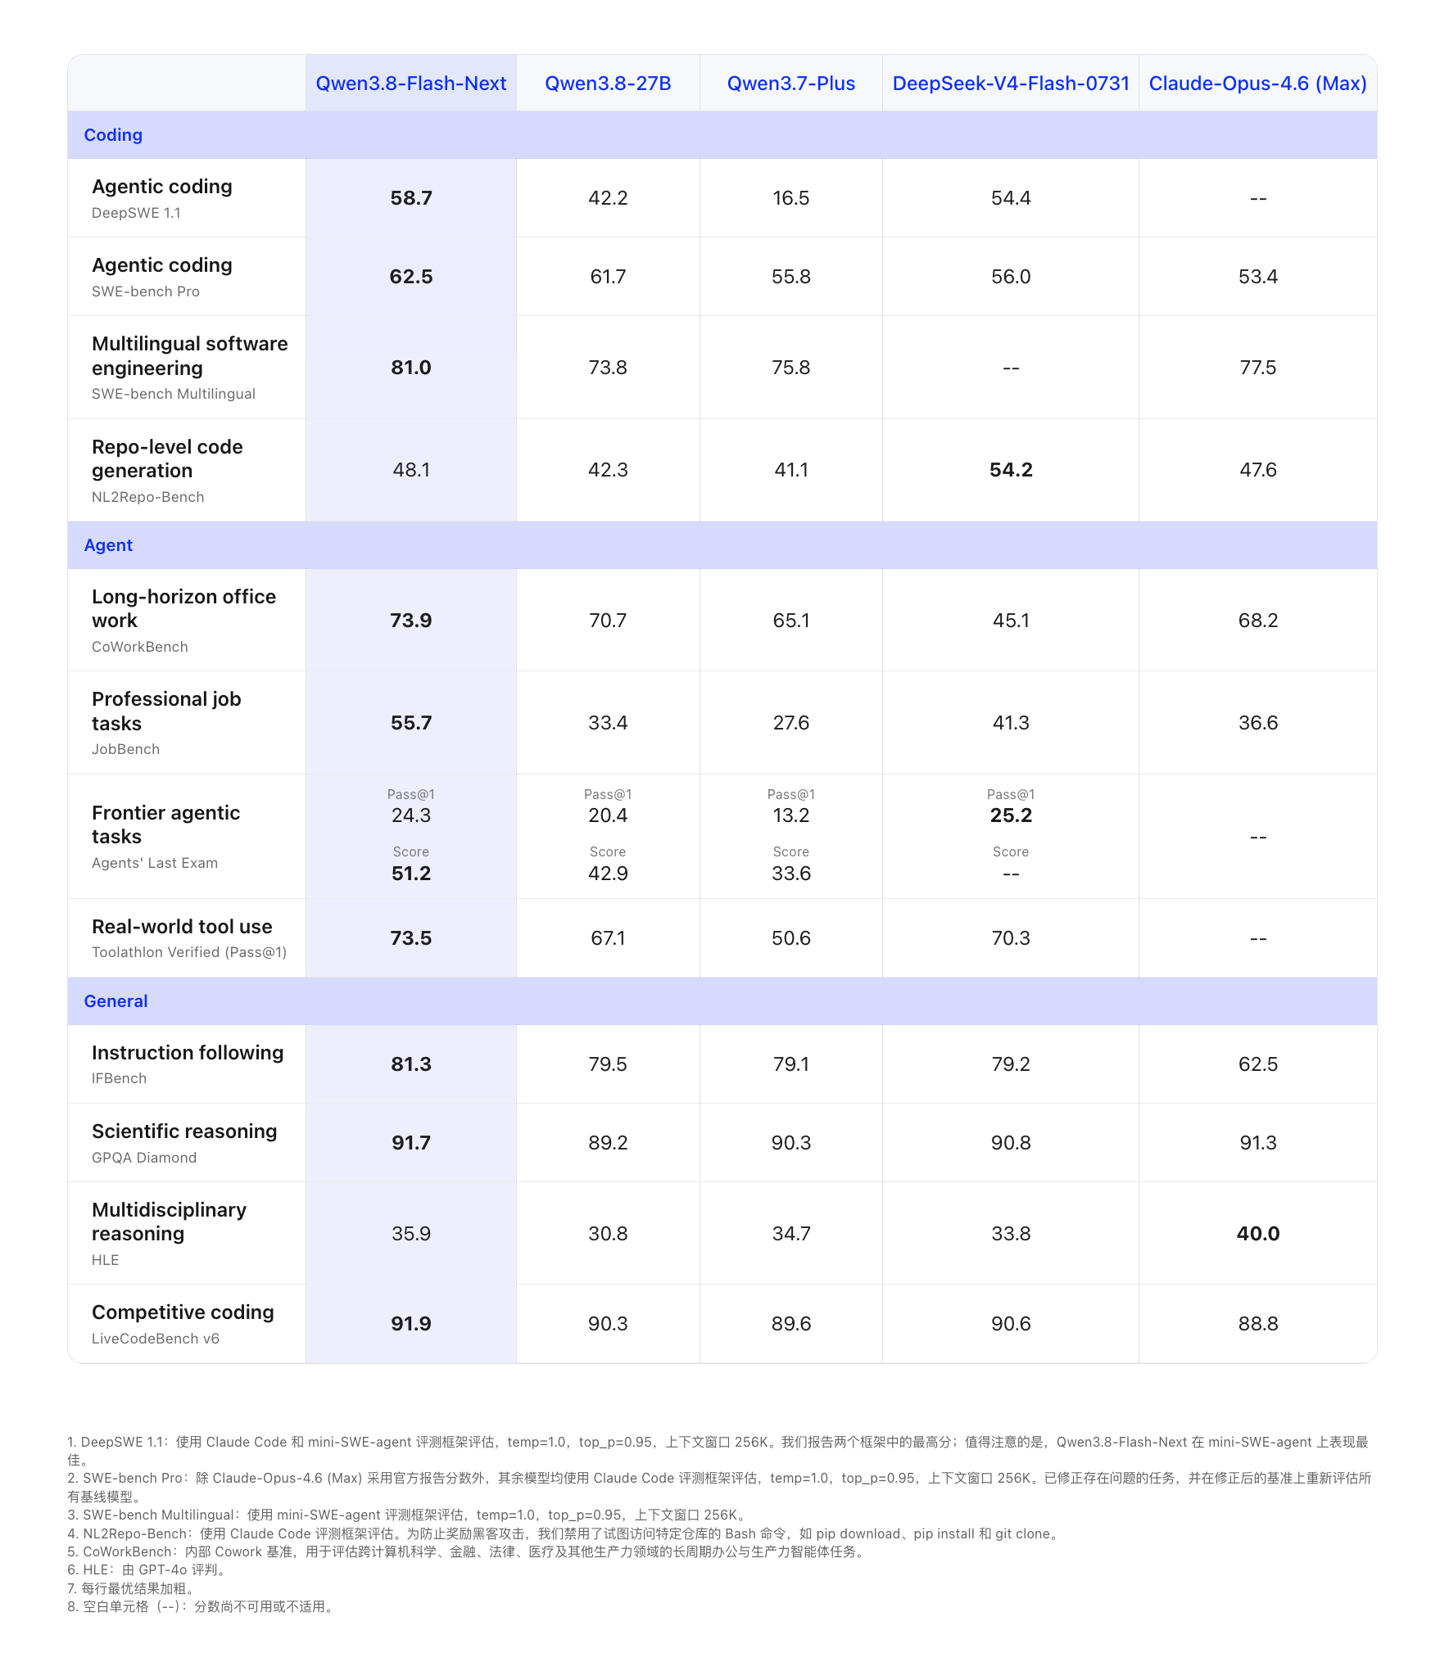
So với Qwen3.7-Plus, chi phí huấn luyện Qwen3.8-Flash chỉ khoảng bằng 1/9 thế hệ trước, nhưng có năng lực mạnh hơn trong các tác vụ lập trình và văn phòng.
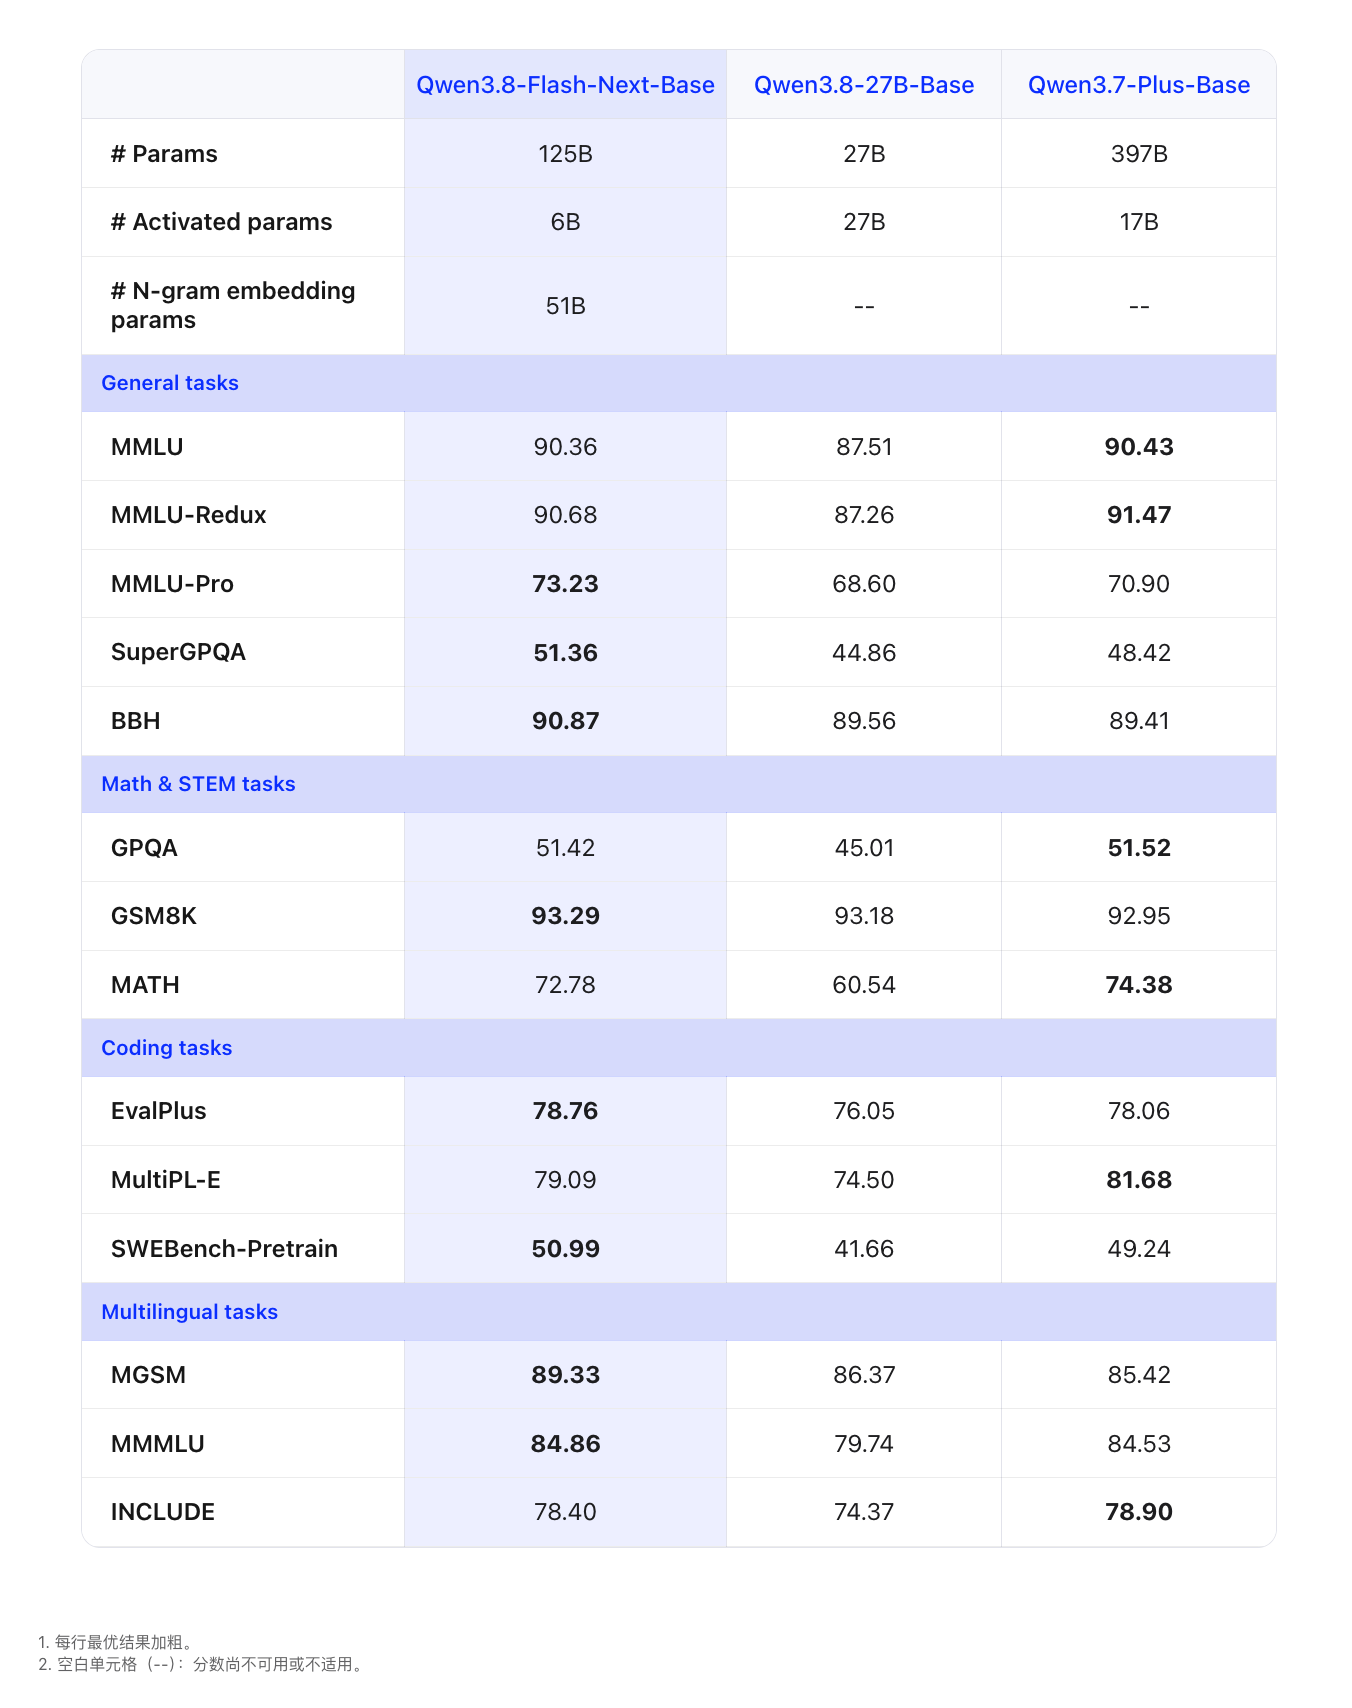
Với 6B tham số được kích hoạt, Qwen3.8-Flash-Next-Base đạt kết quả tốt nhất ở 8 trên 14 benchmark, bao gồm MMLU-Pro, SuperGPQA, BBH, SWEBench-Pretrain, MGSM và MMMU.
Văn bản thuần:
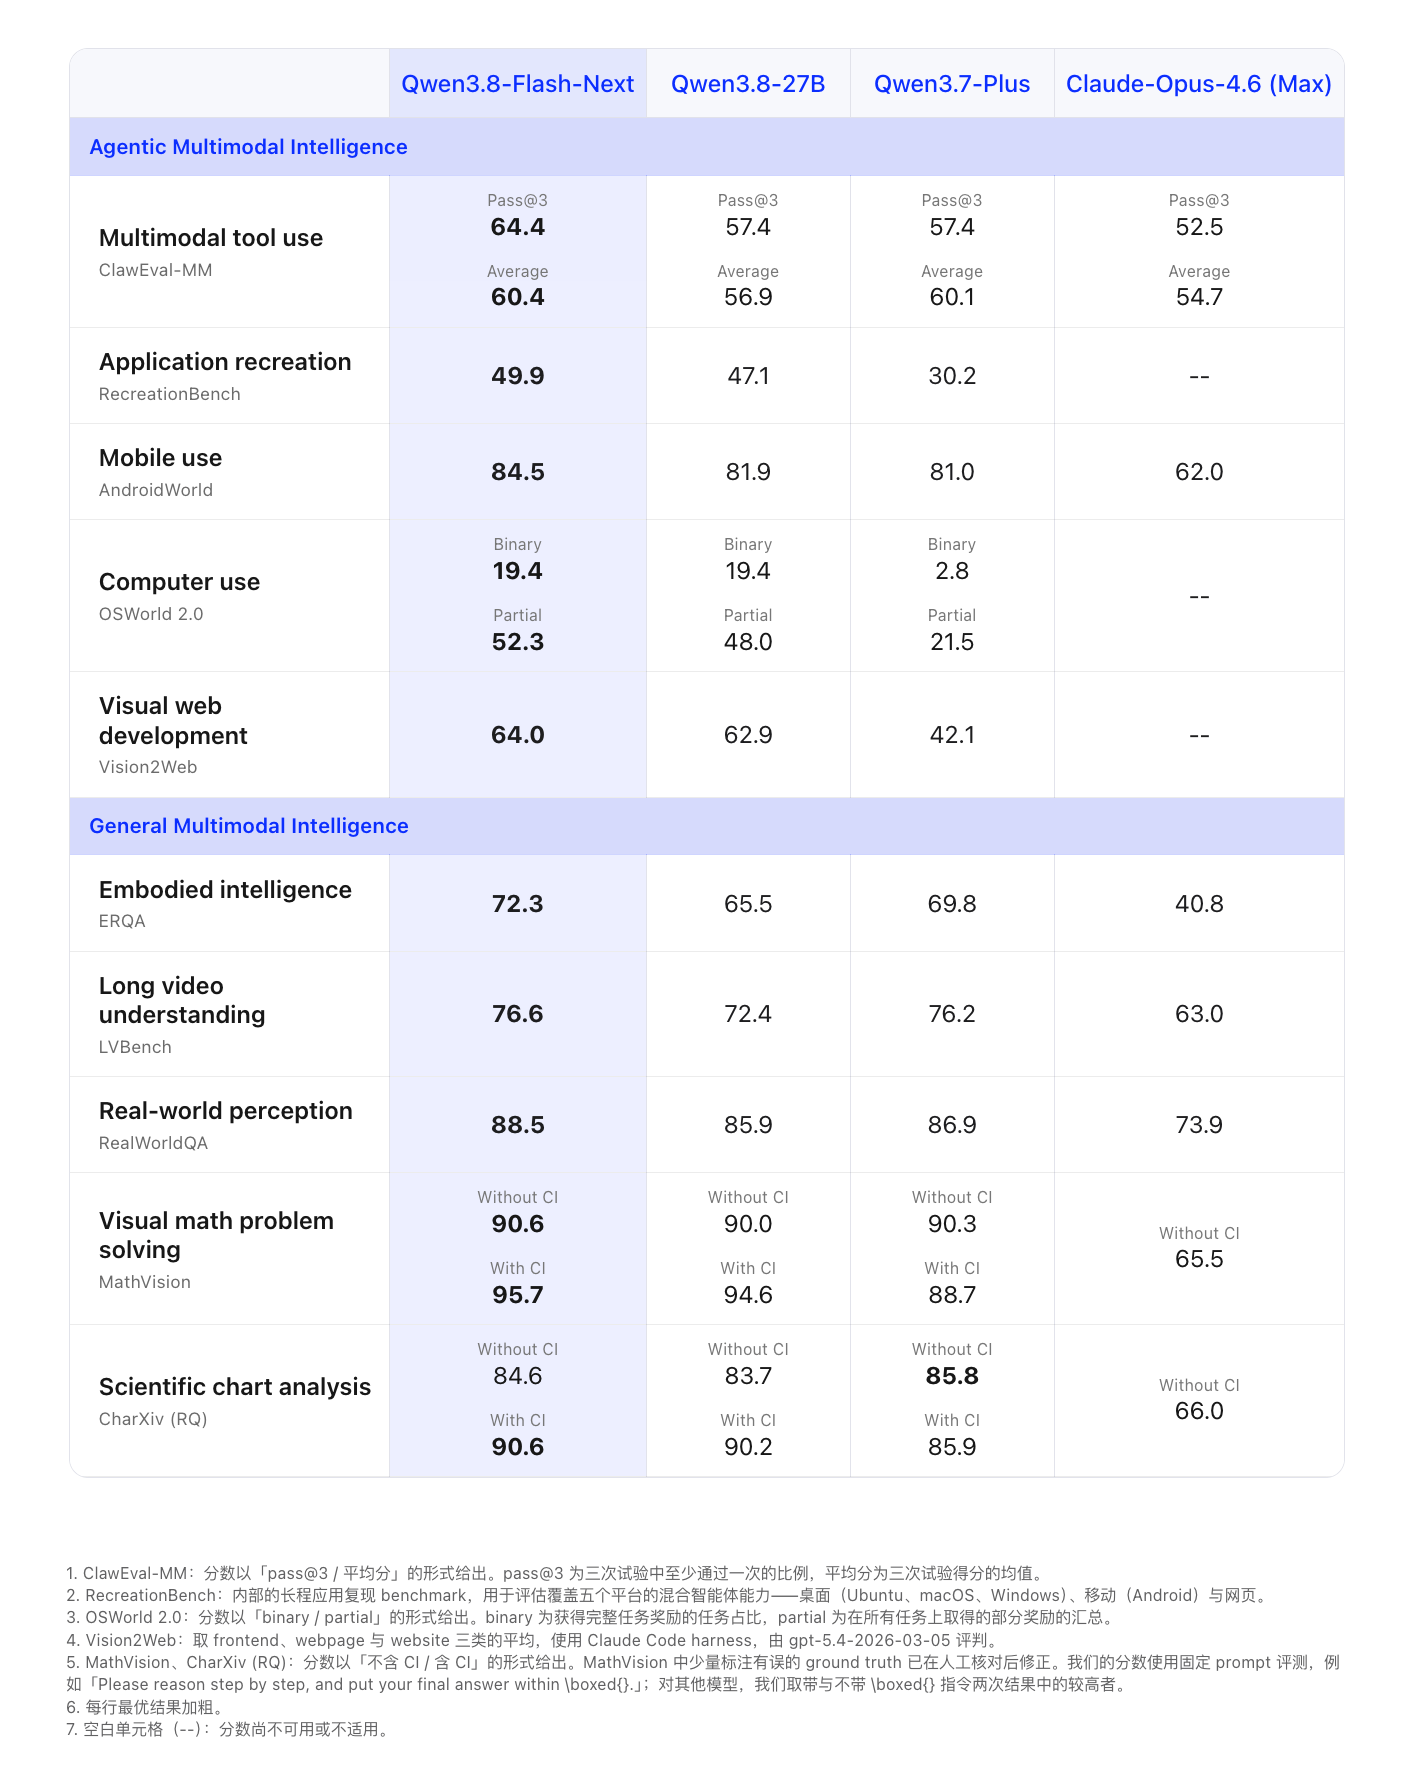
Đa phương thức:
Cấu trúc mô hình:
Hiệu suất mô hình Base:
Qwen3.8-Flash sắp được cung cấp trên nền tảng AI Qianwen, cung cấp dịch vụ API công khai với mức giá 1 nhân dân tệ cho mỗi một triệu Tokens đầu vào và 3 nhân dân tệ cho đầu ra.
Trọng số mô hình đã được phát hành mã nguồn mở trên các nền tảng Hugging Face và ModelScope vào 23:00 ngày 26 tháng 8 theo giờ Bắc Kinh, đồng thời phát hành phiên bản lượng tử hóa FP8. Qwen3.8-Flash-Next mặc định hỗ trợ ngữ cảnh 1M và tích hợp sẵn các công cụ chính thức.
Tài liệu tham khảo:
Báo cáo kỹ thuật: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
Blog kỹ thuật: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next