

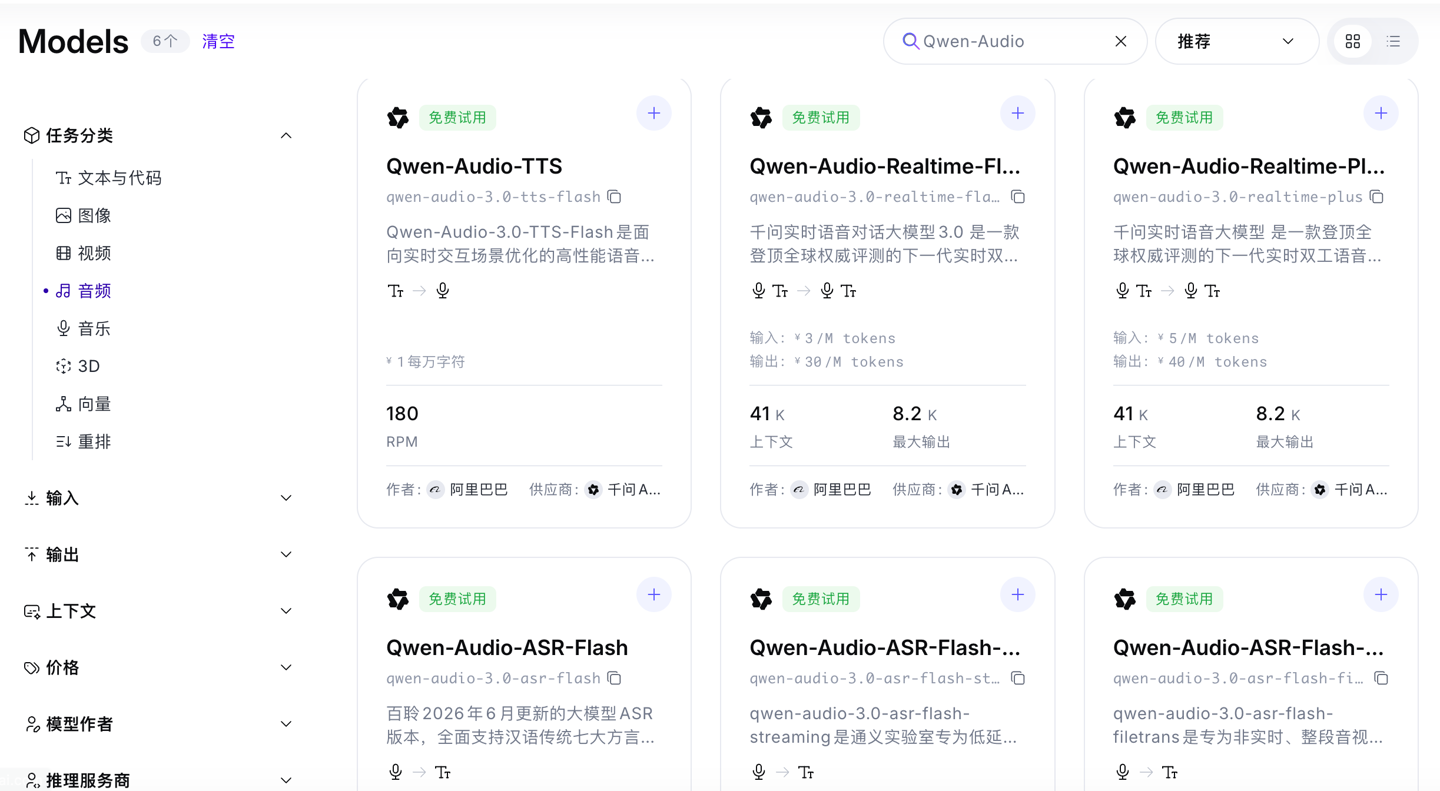
Chiều nay (ngày 17), Alibaba Cloud thông báo qua tài khoản WeChat chính thức rằng dòng mô hình giọng nói Qwen-Audio-3.0 đã chính thức được triển khai trên nền tảng AI Qwen và nền tảng Bailian của Alibaba Cloud. Nhà phát triển có thể gọi các khả năng của mô hình thông qua dịch vụ API hoặc đăng ký Token Plan để sử dụng.
Dòng mô hình Qwen-Audio-3.0 là các mô hình giọng nói do Alibaba tự nghiên cứu và phát triển. IT之家 giới thiệu cụ thể danh mục sản phẩm như sau:
Mô hình ngôn ngữ lớn nhận diện giọng nói Qwen-Audio-3.0-ASR
Mô hình ngôn ngữ lớn tổng hợp giọng nói Qwen-Audio-3.0-TTS
Mô hình đối thoại tương tác giọng nói thời gian thực Qwen-Audio-3.0-Realtime
Theo giới thiệu, trên bảng xếp hạng giọng nói tháng 7 năm nay của Artificial Analysis, nền tảng đánh giá AI uy tín toàn cầu, dòng mô hình này đã giành vị trí số một thế giới ở cả ba hạng mục: nhận diện giọng nói (ASR), tương tác thời gian thực (RealTime) và tổng hợp giọng nói (TTS), qua đó đạt “Grand Slam”.
Trong đó, Qwen-Audio-3.0-ASR chuyển giọng nói thành văn bản, hỗ trợ nhận diện trong ngữ cảnh phức tạp và các lĩnh vực chuyên môn; Qwen-Audio-3.0-TTS chuyển văn bản thành giọng nói, hỗ trợ nhiều ngôn ngữ và phương ngữ, đồng thời cho phép điều khiển cảm xúc, ngữ điệu và nhịp điệu; Qwen-Audio-3.0-Realtime hỗ trợ hiểu và đối thoại bằng giọng nói đầu cuối, có thể vừa nghe vừa nói, cho phép ngắt lời để hỏi tiếp bất cứ lúc nào và hỗ trợ gọi công cụ.
Hiện tại, dòng mô hình này đã được ứng dụng trong các sản phẩm như ứng dụng Qwen, Qwen Văn phòng và Qoder.