

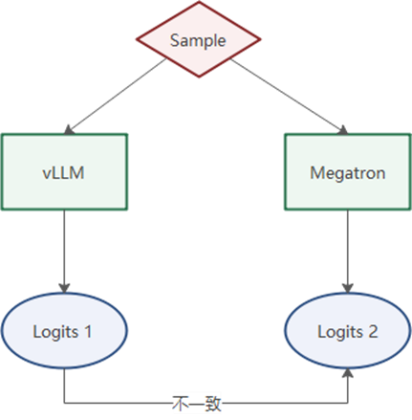
Học tăng cường đã trở thành một mô hình chủ đạo trong quá trình huấn luyện các mô hình lớn, thúc đẩy công nghệ mô hình được triển khai theo hướng kỹ thuật hóa trong các lĩnh vực cốt lõi. Trong đó, tính nhất quán giữa huấn luyện và suy luận đóng vai trò rất quan trọng, bởi quá trình suy luận và huấn luyện có sự liên kết chặt chẽ, còn khác biệt về hạ tầng dễ khuếch đại tính bất định.
Ngày 5 tháng 8, Huawei Computing chính thức công bố Ascend cung cấp bộ toán tử hoàn chỉnh bảo đảm tính nhất quán giữa huấn luyện và suy luận dựa trên ngôn ngữ lập trình Ascend C. Thử nghiệm trên mô hình Qwen3-30B MoE đạt Logdiff bằng 0, đồng thời nhờ tối ưu hóa toán tử FA tương thích với Ascend, chế độ Eager đạt mức cải thiện hiệu năng 20%-60%, cung cấp cho nhà phát triển giải pháp huấn luyện học tăng cường hiệu quả và đáng tin cậy.
Nguyên nhân căn bản nhất dẫn đến sự không nhất quán giữa huấn luyện và suy luận trong giai đoạn hậu huấn luyện RL là phép cộng dồn ở cấp tính toán nền tảng không được bảo đảm thứ tự. Để bảo đảm thứ tự cộng dồn trong mỗi lần thực hiện giữa công cụ huấn luyện và công cụ suy luận từ trên xuống dưới, cần đồng thời tối ưu cả phía framework và phía toán tử. Khi kích thước mô hình tăng, vấn đề sẽ tiếp tục bị khuếch đại: các chiến lược phân vùng như song song tensor, song song chuyên gia và tuyến truyền thông tập thể, chỉ cần một mắt xích không khớp là không thể đạt true-on-policy cuối cùng. Toán tử cũng cần bao phủ nhiều kịch bản gọi khác nhau, áp đặt ràng buộc tại các bước tính toán then chốt, đồng thời kiểm soát tổn thất hiệu năng trong phạm vi có thể sử dụng. Đây là một thách thức kỹ thuật mang tính hệ thống.
Sự không nhất quán giữa huấn luyện và suy luận là sự khác biệt về giá trị số giữa công cụ Rollout (suy luận) và công cụ huấn luyện. Ngay cả khi cả hai sử dụng hoàn toàn cùng trọng số mô hình, logarit xác suất (logprob) tính trên cùng một chuỗi Token vẫn có thể xuất hiện sai khác nhỏ; sai khác này thường được đo bằng logdiff.
Dựa trên ngôn ngữ lập trình Ascend C, Ascend đã áp đặt ràng buộc và đồng bộ hóa có hệ thống đối với các toán tử then chốt trong chuỗi huấn luyện và suy luận. Ý tưởng cốt lõi là để quá trình huấn luyện và suy luận sử dụng cùng một đường dẫn số học tại «những nơi cần cộng dồn», chủ yếu gồm 4 thay đổi sau:
Thống nhất ngữ nghĩa attention: Đồng bộ phạm vi tính toán tại các vị trí hợp lệ giữa Softmax mask trong huấn luyện và attention từng bước trong suy luận, loại bỏ sai khác số học do tập hợp Token có thể quan sát không giống nhau.
Khóa thứ tự cộng dồn reduce: Ràng buộc cách phân chia và thứ tự quy về trên các chiều reduction của FA trong huấn luyện và PFA / PagedAttention trong suy luận, tránh tình trạng cộng dồn không bảo toàn thứ tự do «cùng mẫu nhưng khác cách phân chia».
Đồng bộ chiến lược phân khối Softmax trực tuyến: Thống nhất kích thước khối và nhịp quy về, tránh sự không nhất quán giữa Softmax gộp nhiều khối ở phía decoder và Softmax phân khối ở phía huấn luyện.
Đồng bộ độ chính xác trên các đường dẫn then chốt: Thống nhất chiến lược chuyển đổi độ chính xác tại các bước nhạy cảm như cộng dồn Softmax, giảm sai số phần định trị do khác biệt trong triển khai độ chính xác hỗn hợp.
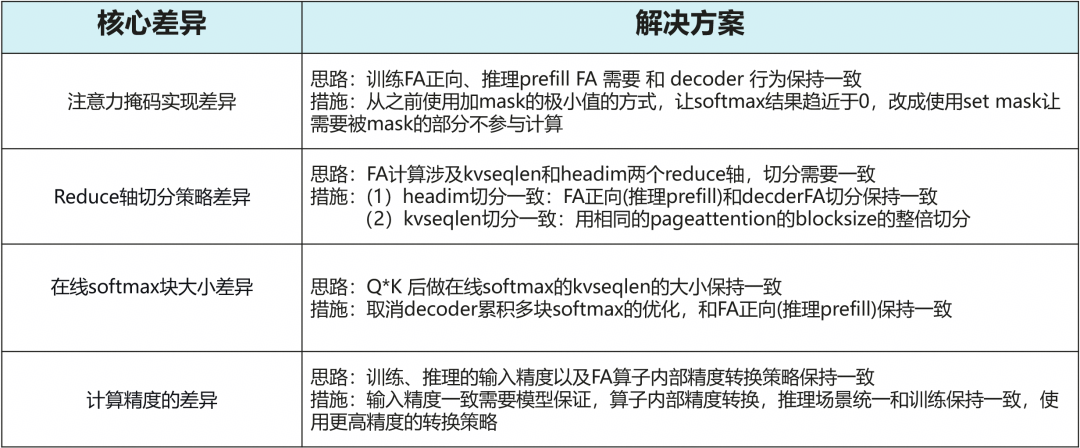
Trên cơ sở đó, kết hợp với tối ưu hóa việc phân phối và lập lịch FA, tính nhất quán giữa huấn luyện và suy luận không còn phải đánh đổi bằng sự suy giảm hiệu năng đáng kể, qua đó đồng thời đạt logdiff=0 và tăng tốc đầu cuối trong thử nghiệm thực tế.
Huawei cho biết hạ tầng liên quan đã được mã nguồn mở, đồng thời sẽ ra mắt “Skill nhận diện vấn đề nhất quán giữa huấn luyện và suy luận”, hỗ trợ kiểm tra logdiff còn sót lại và xác định vấn đề nằm ở đường dẫn toán tử hay khác biệt trong triển khai framework.
Địa chỉ mã nguồn mở:
https://github.com/verl-project/verl-ascend-recipe/tree/main/true_on_policy