

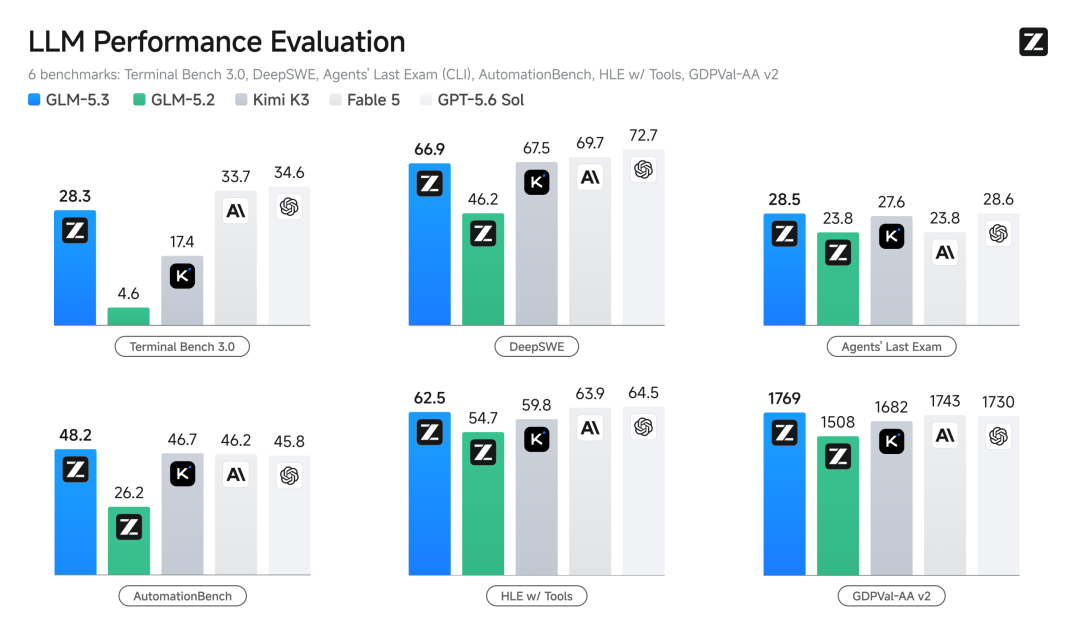
Hôm nay, Zhipu chính thức ra mắt GLM-5.3. So với GLM-5.2, mô hình nền tảng không thay đổi, nhưng thông qua Scaling hậu huấn luyện, trần năng lực thông minh của mô hình đã được nâng cao đáng kể: môi trường tác vụ dài hạn tăng hàng chục lần, loại môi trường phong phú và đa dạng hơn, cùng thời gian hậu huấn luyện siêu dài.
So với thế hệ trước, GLM-5.3 có những năng lực mới gồm:
Năng lực lập trình mạnh hơn. GLM-5.3 là mô hình nguồn mở mạnh nhất về lập trình. Trong các đánh giá trải nghiệm do Zhipu tự xây dựng, kết quả tăng 50% so với GLM-5.2; trên các bài kiểm thử chuẩn công khai, bao gồm Terminal Bench 3.0 và Agents' Last Exam (CLI), mô hình đạt vị trí số một trong nhóm nguồn mở.
Năng lực an ninh mạng. Trong các tác vụ bảo mật như rà soát mã nguồn hộp trắng và phát hiện lỗ hổng, GLM-5.3 đạt hiệu suất ngang bằng Mythos 5, cho thấy tiềm năng mạnh mẽ trong các kịch bản phòng thủ an ninh mạng.
Scaling hậu huấn luyện. Toàn bộ những cải thiện trên đều đến từ quá trình hậu huấn luyện. Dựa trên IndexShare, SAO và thế hệ mới của khung Slime liên tục phát triển, Zhipu đã triển khai hiệu quả học tăng cường trên cùng một mô hình nền tảng hoàn toàn giống GLM-5.2. Có thể Zhipu vẫn chưa khai phá hết trần năng lực thông minh của mô hình nền tảng này.
Mở nguồn. Zhipu sẽ mở quyền truy cập trọng số mô hình sau hai tuần kể từ khi ra mắt, trước đó sẽ hoàn tất đánh giá an toàn và gia cố mô hình.
Zhipu cho biết, trong nhiều bài kiểm thử chuẩn phổ biến, GLM-5.3 là mô hình nguồn mở có thứ hạng cao nhất hiện nay; năng lực lập trình và tác vụ tác nhân tiệm cận Claude Fable 5, còn trải nghiệm lập trình vượt qua các mô hình nội địa khác.
Trên Terminal-Bench 3.0, bài kiểm thử đo lường khả năng hoàn thành tác vụ phức tạp trong môi trường thiết bị đầu cuối thực tế, điểm số của GLM-5.3 tăng từ 4.6 lên 28.3;
Trên DeepSWE v1.1, tập trung vào kỹ thuật phần mềm dài hạn và khả năng liên tục chỉnh sửa mã nguồn, điểm số tăng từ 46.2 lên 66.9;
Trên Agents' Last Exam, bao phủ nhiều bối cảnh chuyên môn thực tế và nhấn mạnh khả năng phối hợp giữa các công cụ cùng tác vụ dài hạn, điểm số tăng từ 23.8 lên 28.5;
Trên GDPval-AA v2, bao phủ 44 nghề nghiệp và đánh giá công việc tri thức thực tế có giá trị cao, mô hình đạt 1,769 điểm, thể hiện năng lực thực hiện tác vụ chuyên môn nổi lên từ khả năng lập trình.
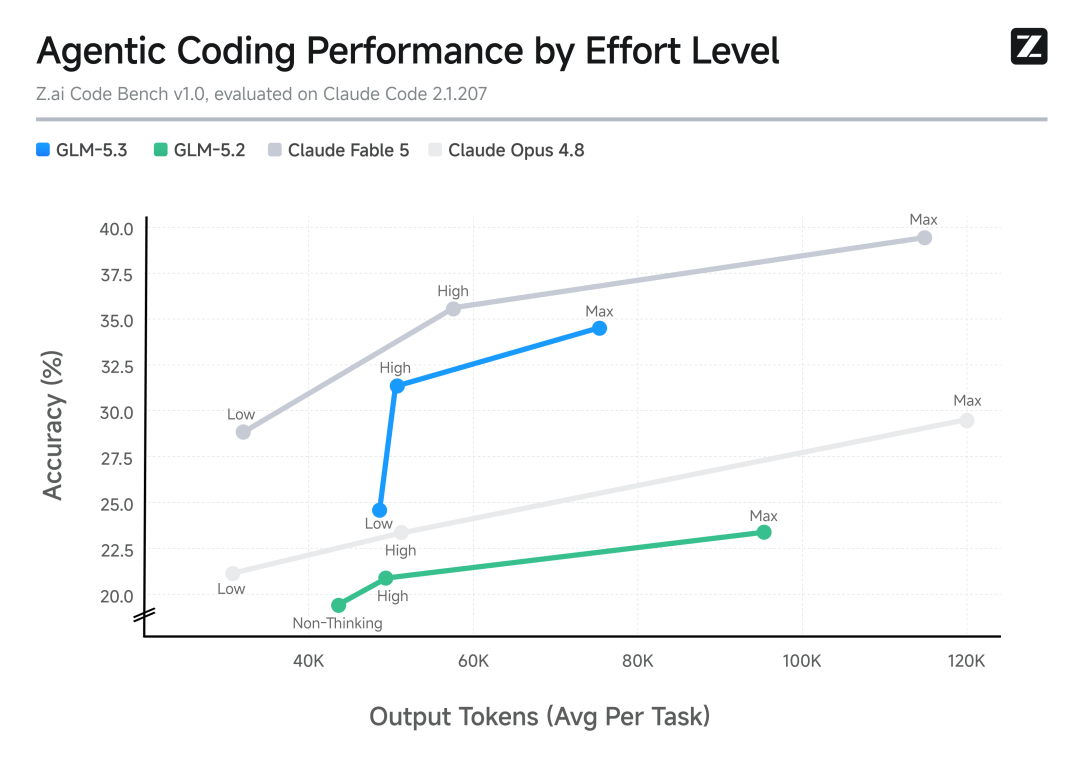
Z.ai Code Bench do Zhipu tự phát triển đánh giá trải nghiệm tổng thể của mô hình trong các bối cảnh lập trình thực tế. Mô hình được đặt trong môi trường phát triển cục bộ phức tạp và thực hiện các tác vụ đầu cuối ở nhiều mức độ suy luận khác nhau, gần với trải nghiệm thực tế của nhà phát triển khi sử dụng Coding Agent.
Kết quả kiểm thử cho thấy GLM-5.3 đạt được sự cân bằng tốt hơn giữa hiệu quả và khả năng sử dụng Token. Ở mức High, GLM-5.3 đạt độ chính xác 31.4%, vượt mức 29.5% ở mức cao nhất của Claude Opus 4.8. Mỗi tác vụ tạo ra trung bình khoảng 50 nghìn tokens, trong khi Opus 4.8 cần khoảng 120 nghìn tokens, nghĩa là GLM-5.3 có thể hoàn thành tác vụ bằng lộ trình thực thi ngắn hơn.
Từ hôm nay, công cụ lập trình chính thức ZCode và công cụ nâng cao hiệu suất AutoClaw của Zhipu chính thức hoạt động; GLM Coding Plan cũng mở cho toàn bộ người dùng và đăng ký sử dụng.
Các nền tảng lập trình TraeWork / TraeCode / 扣子, WorkBuddy / CodeBuddy, Qoder / QwenWork, CatPaw, JoyCode, OpenCode và các nền tảng khác mở quyền trải nghiệm sớm.
API sẽ sớm được cung cấp. Toàn bộ trọng số mô hình sẽ được mở nguồn trong vòng hai tuần; trước đó cần hoàn tất các biện pháp gia cố an toàn cần thiết để hạn chế tối đa khả năng tấn công tiềm ẩn, đồng thời bảo toàn giá trị phòng thủ.
Hôm nay lúc 13:00, hạn mức GLM Coding Plan được đặt lại cho tất cả người dùng; hạn mức sử dụng của mọi người sẽ được khôi phục đầy đủ và có thể xem trong mục “Thống kê sử dụng” ở phía sau.