

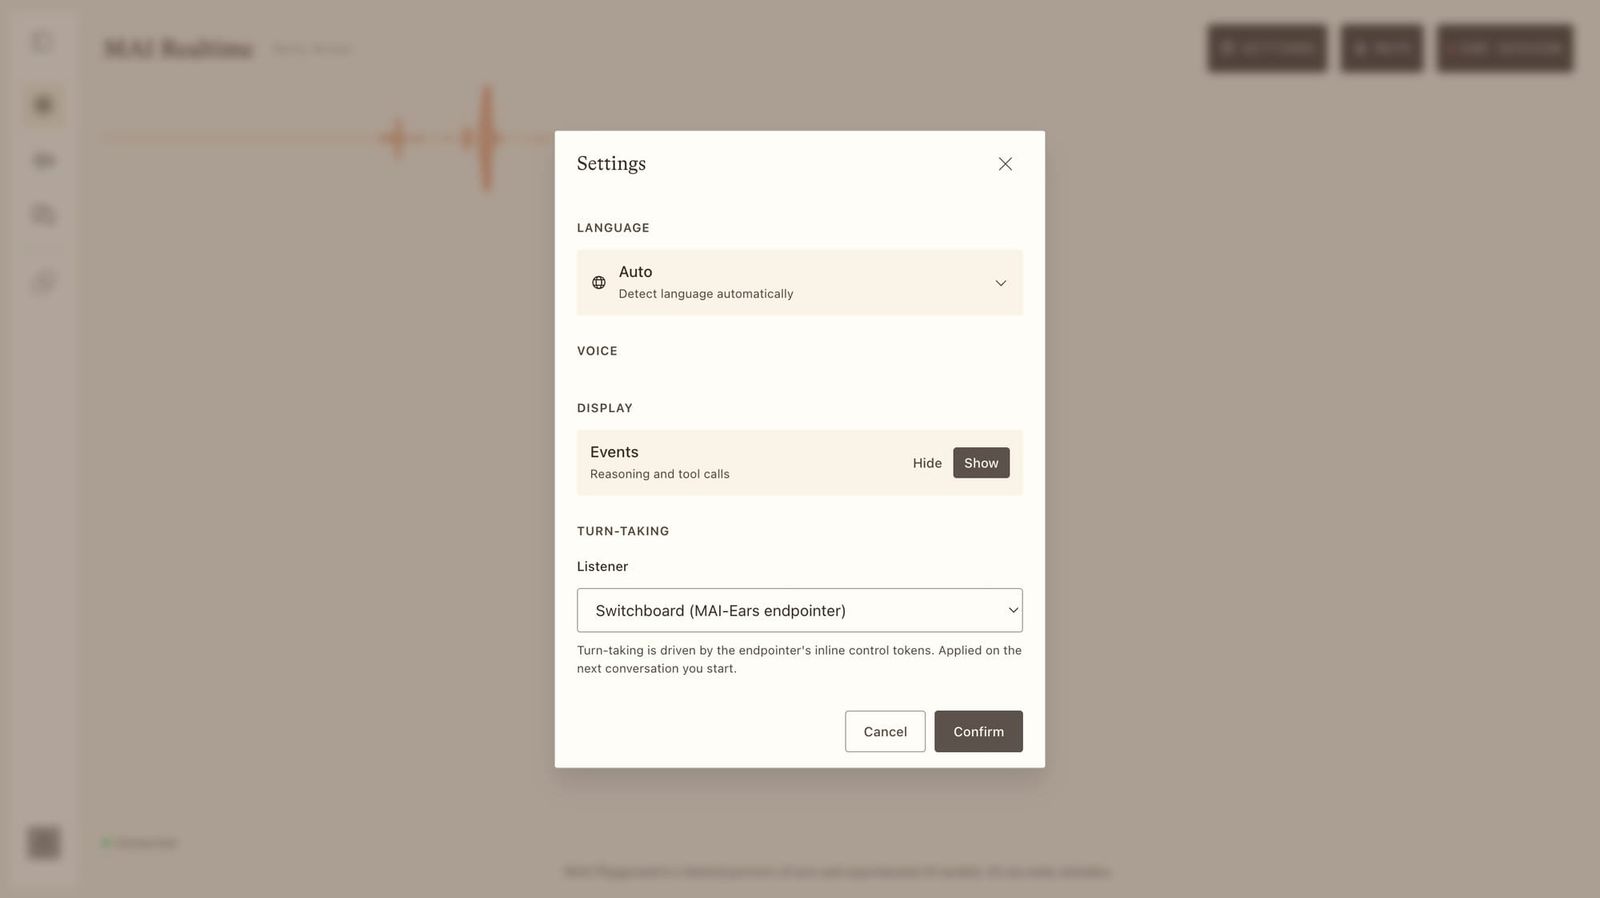
Trang công nghệ TestingCatalog đăng bài viết vào ngày 2 tháng 8, cho biết Microsoft đang thử nghiệm mô hình giọng nói thời gian thực nguyên bản đầu tiên MAI Realtime, hỗ trợ 16 ngôn ngữ và 2 giọng nói, có thể đồng thời nghe và nói trong cuộc hội thoại, đồng thời hỗ trợ tự động nhận diện và chuyển đổi ngôn ngữ giữa chừng.
Về thử nghiệm, thông tin cho biết Microsoft đã mời một số đối tác thử nghiệm mô hình này trên nền tảng MAI Playground. Hiện chưa rõ khi nào mô hình sẽ được triển khai trên Microsoft Foundry và mở rộng sang chức năng giọng nói của Copilot.
Về vận hành, MAI Realtime sử dụng phương thức tương tác hai chiều, song công toàn phần, không cần tuân thủ chặt chẽ lượt trao đổi “người dùng nói xong rồi mô hình mới trả lời”, mà có thể đồng thời lắng nghe và phản hồi.
Về ngôn ngữ hỗ trợ, mô hình MAI Realtime hỗ trợ 16 ngôn ngữ, bao gồm tiếng Trung. IT之家 dẫn lại bài viết và liệt kê các ngôn ngữ được hỗ trợ như sau:
Tiếng Anh
Tiếng Đức
Tiếng Tây Ban Nha
Tiếng Pháp
Tiếng Ý
Tiếng Bồ Đào Nha
Tiếng Nhật
Tiếng Hàn
Tiếng Trung
Tiếng Hà Lan
Tiếng Hindi
Tiếng Indonesia
Tiếng Ả Rập
Tiếng Nga
Tiếng Thổ Nhĩ Kỳ
Tiếng Việt
Tiếng Thái
Về phong cách giọng nói, thông tin cho biết bản thử nghiệm của mô hình cung cấp 2 giọng nói là Victoria và Grant, tự nhiên hơn chế độ giọng nói hiện tại của Copilot. Người dùng có thể chủ động chỉ định ngôn ngữ hoặc bật tính năng tự động phát hiện.
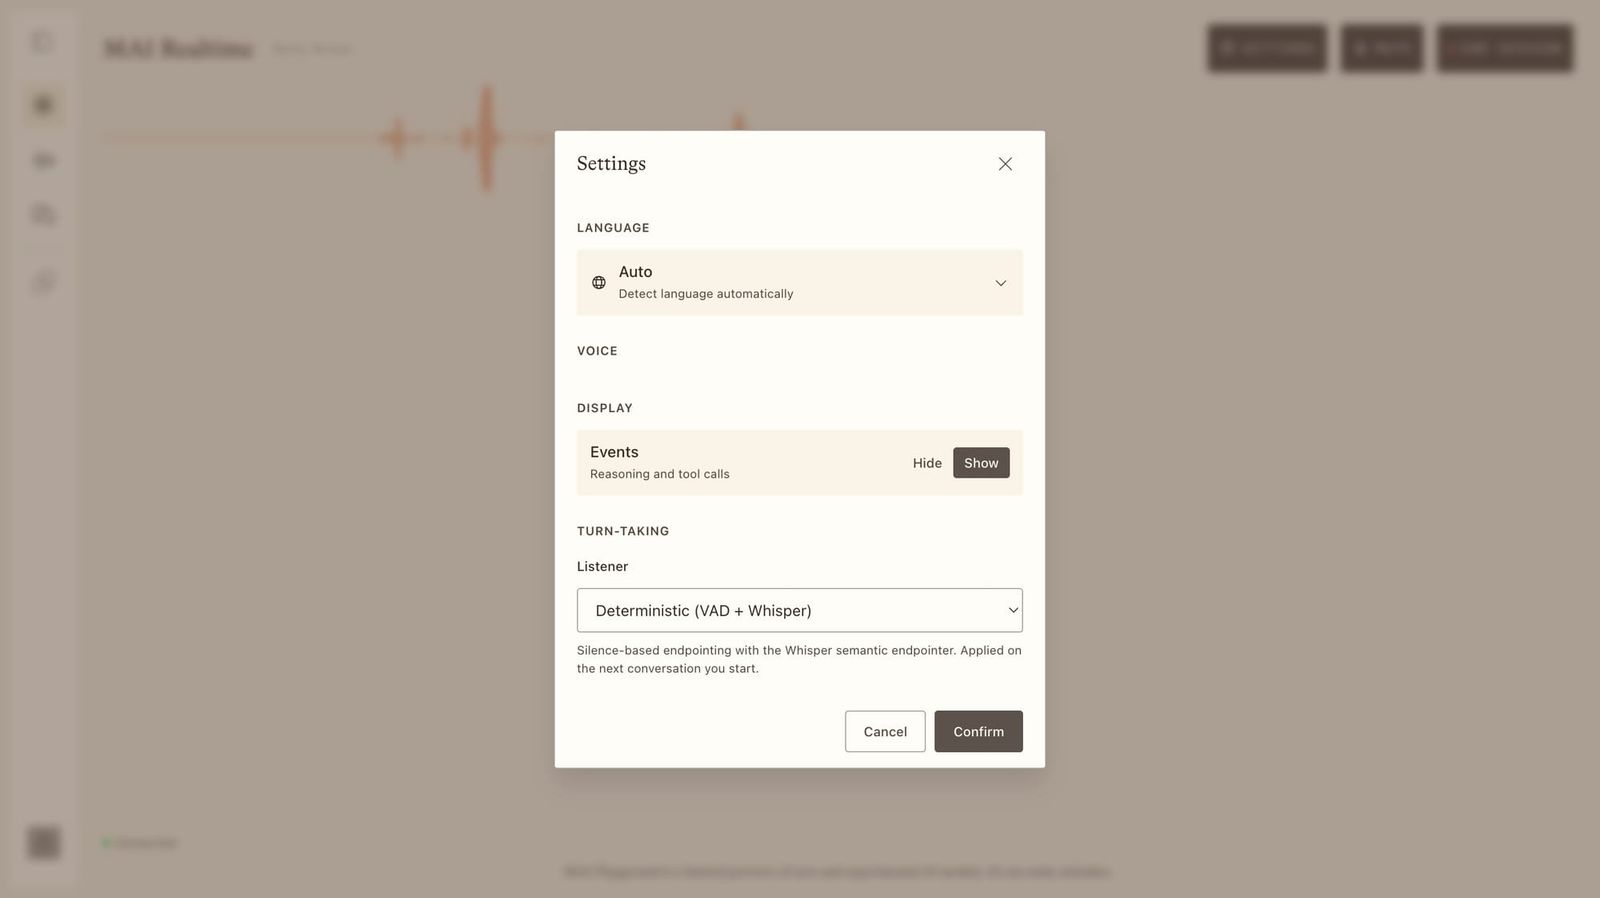
Mô hình này không hỗ trợ ca hát hoặc tạo hiệu ứng âm thanh phi ngôn ngữ, mà vẫn được định vị là một hệ thống hội thoại. Bảng điều khiển gỡ lỗi có thể hiển thị độ trễ theo thời gian thực, nội dung suy nghĩ của mô hình và các bước xử lý. Tính năng chia sẻ mẫu có thể sẽ được mở cho người dùng nền tảng sau khi phạm vi quyền thử nghiệm được mở rộng.
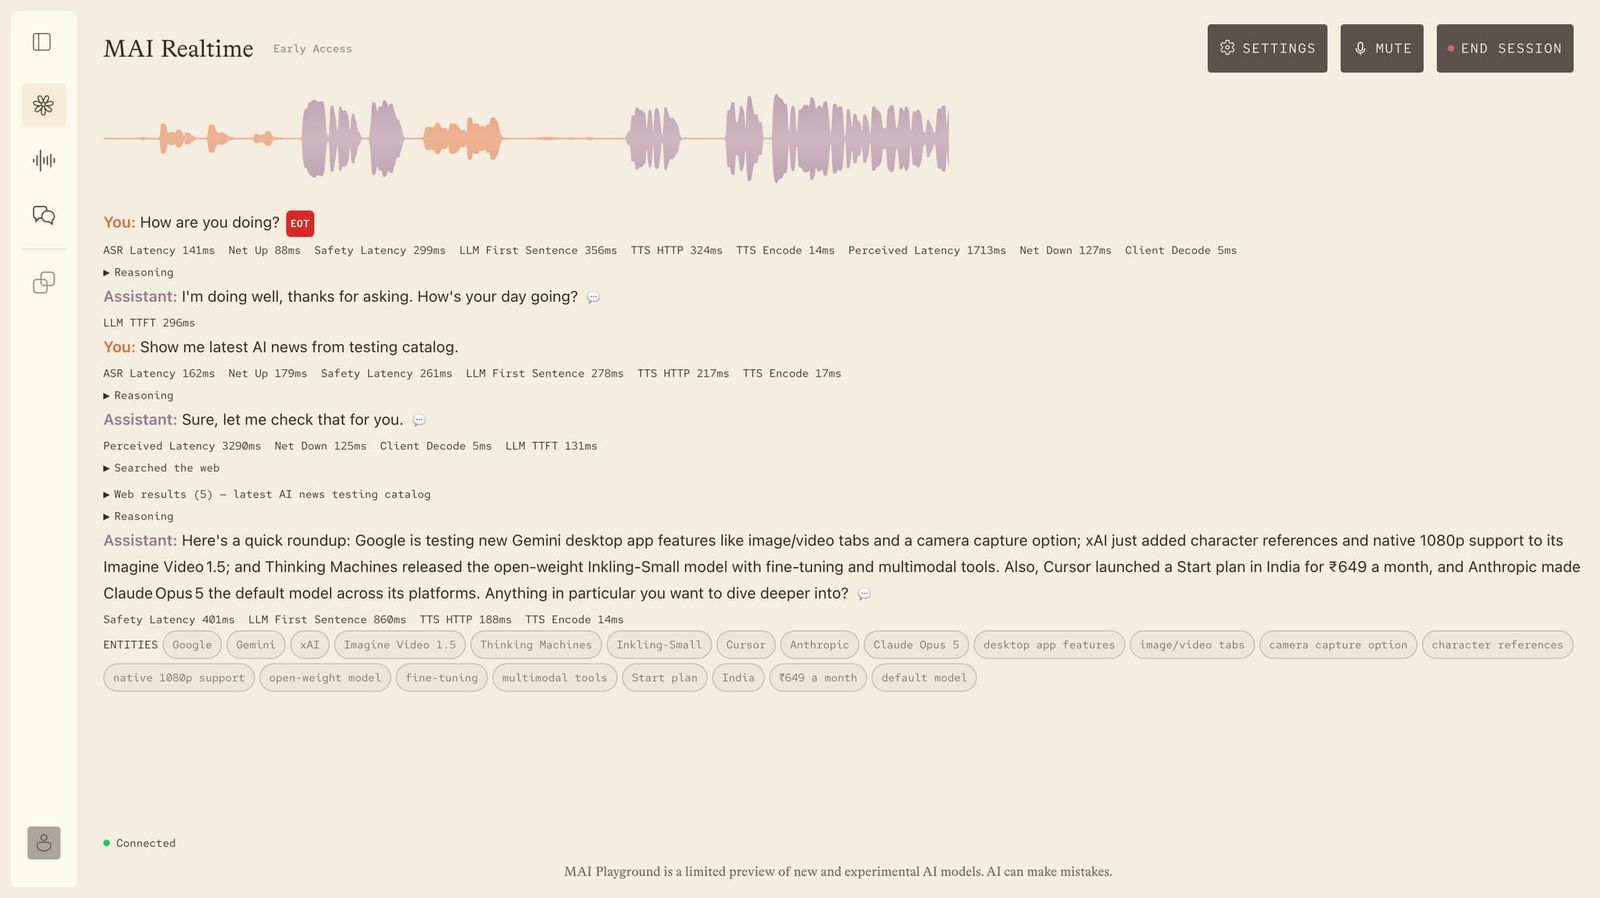
注: Giọng nói song công toàn phần (Full-duplex voice) chỉ hệ thống có thể đồng thời tiếp nhận giọng nói của người dùng và xuất phản hồi, không cần chờ một bên nói xong hoàn toàn. Công nghệ này dựa vào tính năng phát hiện điểm cuối để nhận diện thời điểm bắt đầu nói, khoảng dừng và kết thúc, đồng thời cần điều chỉnh đầu ra khi người dùng xen lời.
Trước đó, các mô hình giọng nói MAI do Microsoft phát hành đều là mô hình một chiều, bao gồm MAI-Voice-2 và phiên bản Flash dùng để tổng hợp giọng nói, cùng MAI-Transcribe-1.5 dùng để nhận dạng giọng nói.