

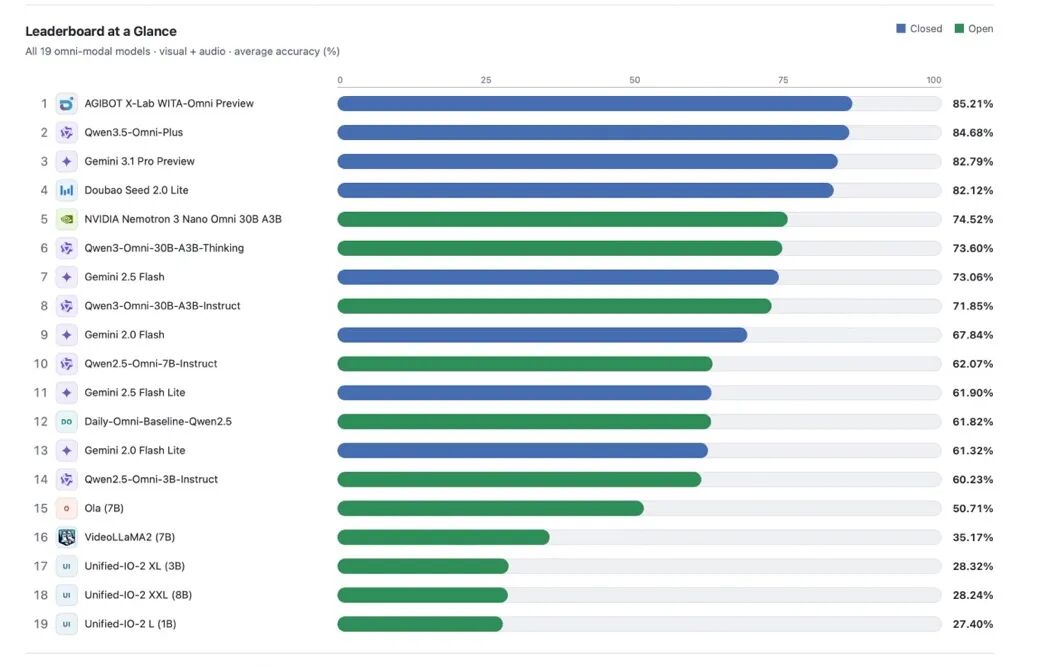
Theo thông tin từ tài khoản WeChat AGIBOT, kết quả đánh giá mới nhất của bảng xếp hạng hiểu đa phương thức embodied uy tín DailyOmni vừa được công bố. Mô hình nền tảng đa phương thức gốc embodied WITA-Omni Preview do AGIBOT tự phát triển đã đứng đầu bảng với thành tích tổng hợp 85,21 điểm nhờ khả năng hiểu kết hợp âm thanh-hình ảnh và suy luận theo trình tự thời gian vượt trội, vượt qua các mô hình hàng đầu trong và ngoài nước như Qwen, Gemini, Doubao và NVIDIA, đồng thời giành vị trí số một ở sáu trong tám chỉ số chi tiết.
Theo tìm hiểu của IT之家, DailyOmni là bảng xếp hạng bên thứ ba uy tín được ngành công nhận để kiểm tra khả năng đồng bộ theo thời gian của âm thanh-hình ảnh và suy luận kết hợp liên phương thức. Khác với các nhiệm vụ đánh giá thông thường dành cho hình ảnh-văn bản và video ngắn, bảng xếp hạng này sử dụng nhiều tư liệu âm thanh-hình ảnh trong môi trường mở thực tế, tập trung kiểm tra khả năng kết hợp hình ảnh trực quan và thông tin âm thanh môi trường, nhận diện chính xác mối tương ứng giữa âm thanh và hình ảnh, trình tự trước sau của sự kiện cũng như ngữ nghĩa liên phương thức. Đây là những năng lực cảm nhận cốt lõi rất phù hợp với nhu cầu tương tác người-máy của robot hình người trong không gian vật lý thực tế.
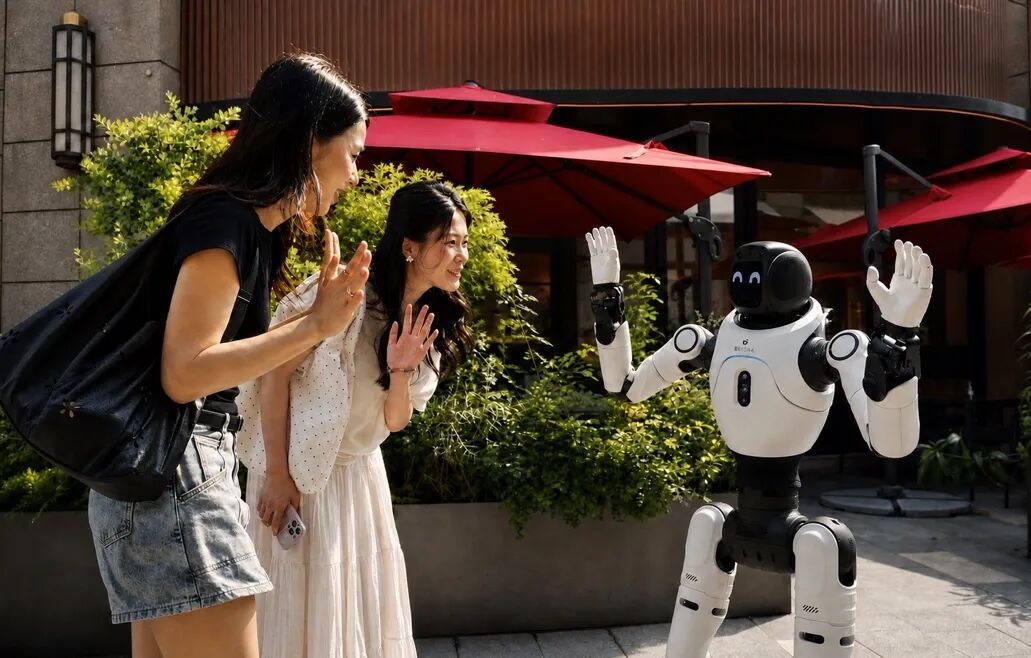
Đại diện chính thức cho biết, chìa khóa giúp WITA-Omni đạt ưu thế không nằm ở việc đơn giản “lắp” một mô hình trò chuyện vào robot, mà ở việc nâng hành động vật lý và biểu cảm thành đầu ra cấp một ngang hàng với giọng nói, sử dụng một mô hình đầu cuối gốc để thống nhất điều khiển cảm nhận, ra quyết định và biểu đạt. Trên nền tảng mô hình Thinker–Talker, kiến trúc này được mở rộng thành Thinker–Talker–Actor, hướng đến các đầu ra embodied.
Ưu thế của WITA-Omni không chỉ dựa vào quy mô mô hình, mà còn đến từ hệ thống dữ liệu phân tầng và phương pháp đào tạo chuyên biệt được xây dựng xoay quanh tương tác đa phương thức embodied. Trong giai đoạn đào tạo giữa, WITA-Omni sử dụng tổng cộng dữ liệu đa phương thức nguồn mở và dữ liệu riêng ở quy mô hàng chục triệu giờ, nâng cấp nền tảng văn bản và thị giác mạnh thành mô hình đa phương thức có khả năng “nghe được, hiểu được hình ảnh và thực hiện suy luận kết hợp âm thanh-hình ảnh”.
Ngoài ra, dữ liệu âm thanh-hình ảnh công khai thường thiếu thông tin về chuyển lượt, thời điểm phản hồi, hành động và biểu cảm trong tương tác thực tế, nên khó có thể trực tiếp đào tạo mô hình tương tác embodied đầu cuối. Vì vậy, AGIBOT đã xây dựng một tập dữ liệu đa phương thức quy mô lớn, chất lượng cao, lấy con người làm trung tâm và hướng đến các bối cảnh tương tác thực tế, bảo toàn đầy đủ mối quan hệ theo trình tự thời gian tự nhiên giữa âm thanh, hình ảnh, ngôn ngữ, hành động và biểu cảm.