

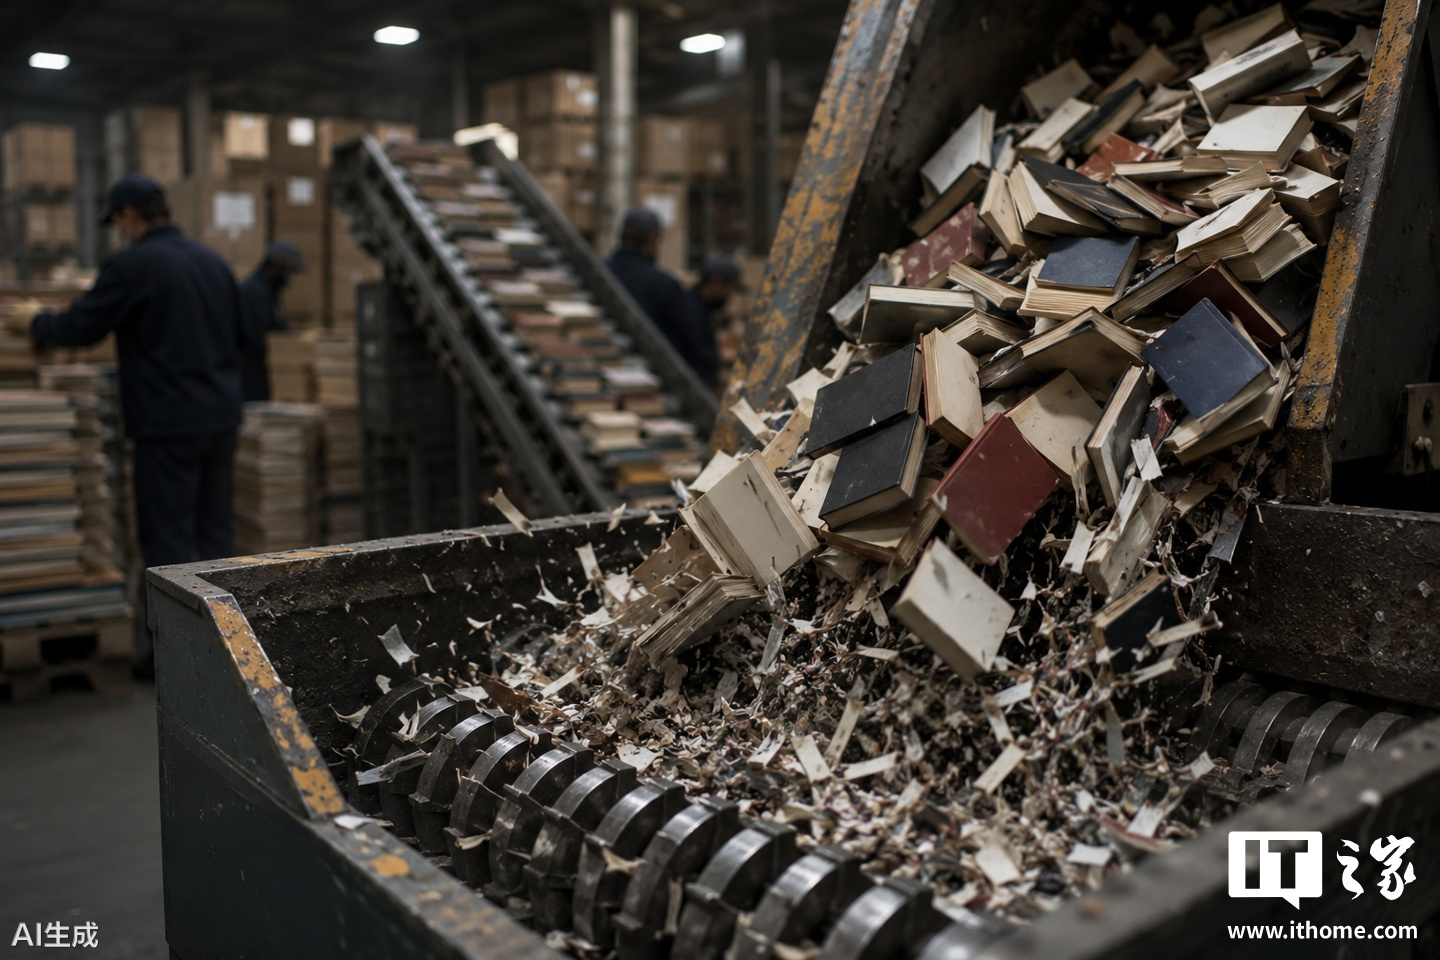
Sau khi khiến nguồn lực bộ nhớ và lưu trữ ngày càng khan hiếm, các công ty AI dường như đang hướng sự chú ý sang di sản văn học của nhân loại. Theo báo cáo mới nhất của hãng truyền thông điều tra 404 Media, nhiều công ty AI đang thông qua trung gian mua số lượng lớn sách cũ để thu thập dữ liệu huấn luyện chất lượng cao cho các mô hình AI, đồng thời tránh gây phản ứng tiêu cực từ dư luận.
Sự phát triển của AI không thể tách rời khỏi khối lượng dữ liệu khổng lồ, nhưng không phải dữ liệu nào cũng có giá trị; yếu tố then chốt là chất lượng dữ liệu. Những năm gần đây, lượng lớn nội dung chất lượng thấp do AI tạo ra, thường được gọi là “nội dung rác AI”, đã tràn ngập Internet, không chỉ làm ô nhiễm môi trường dữ liệu mà còn làm giảm hiệu quả học tập tiếp theo của AI. Vì vậy, các công ty AI hàng đầu bắt đầu tìm kiếm lại những nội dung do con người sáng tạo, đặc biệt là sách in xuất bản trước năm 2022, bởi những nội dung này có nhiều khả năng là tác phẩm nguyên bản và chưa bị nội dung do AI tạo ra làm ô nhiễm.
Trên thực tế, việc các công ty AI sử dụng sách in để huấn luyện mô hình đã có tiền lệ. Anthropic, một trong những công ty AI lớn hiện đang vướng vào các vụ kiện bản quyền, từng chi hàng triệu USD để mua số lượng lớn sách in nhằm trích xuất nội dung huấn luyện mô hình Claude AI, sau đó tiêu hủy những cuốn sách này. Được biết, công ty đã mua sách với số lượng lớn từ Better World Books. Tòa án tuy nhận định việc sử dụng sách chính thống để huấn luyện AI thuộc phạm vi “sử dụng hợp lý” theo luật bản quyền, nhưng Anthropic đã xâm phạm bản quyền của tác giả và nhà xuất bản do lưu trữ trong thời gian dài một cơ sở dữ liệu chứa 7 triệu cuốn sách lậu, cuối cùng bị phán bồi thường lên tới 1,5 tỷ USD (lưu ý: theo tỷ giá hiện tại tương đương khoảng 10,162 tỷ nhân dân tệ).
Tranh cãi tương tự cũng xảy ra với Google. Gần đây, một liên minh các nhà xuất bản đã khởi kiện Google, cáo buộc công ty này sử dụng trái phép hàng triệu cuốn sách được bảo hộ bản quyền để huấn luyện mô hình Gemini AI.
Cơ sở dữ liệu trực tuyến ISBNdb, sở hữu thông tin danh mục của hơn 111 triệu cuốn sách, từ lâu đã là nền tảng quan trọng đối với người bán sách, thư viện và nhà phân phối. Cùng với sự phát triển nhanh chóng của ngành AI, ISBNdb cũng bắt đầu điều chỉnh định hướng kinh doanh và triển khai dịch vụ thu mua sách quy mô lớn dành riêng cho các doanh nghiệp AI.
404 Media đưa tin quy mô các đơn hàng dao động từ 1.000 cuốn mỗi lần mua đến 1 triệu cuốn mỗi lần mua.
Một người bán sách chuyên nghiệp không muốn tiết lộ danh tính cho biết doanh số sách đã tăng chưa từng có kể từ tháng 4 năm nay. Trước đây, vào những thời điểm kinh doanh thuận lợi, mỗi tuần chỉ bán được khoảng 20 cuốn; nhưng trong vài tháng gần đây, doanh số hàng tuần đã tăng vọt lên hàng trăm cuốn, gấp khoảng năm lần mức thông thường.
Những người bán sách khác trên các nền tảng giao dịch sách cũ như Alibris và Biblio cũng phản ánh hiện tượng thu mua số lượng lớn tương tự.
Mặc dù hiện chưa có bằng chứng chắc chắn chứng minh những hoạt động thu mua này nhất định đến từ ISBNdb hay một công ty AI nào đó, nhiều dấu hiệu bất thường đã xuất hiện. Chẳng hạn, đối tượng được mua số lượng lớn gần như đều là sách có mã số sách tiêu chuẩn quốc tế (ISBN), một mã gồm 13 chữ số dùng làm mã nhận diện duy nhất cho sách trên toàn cầu.
Ngoài ra, các hoạt động thu mua này gần như không có bất kỳ ưu tiên nào về chủ đề, thể loại hay tác giả; từ tiểu thuyết, sách giáo khoa đến sách chuyên ngành đều nằm trong phạm vi thu mua. Điều đáng ngạc nhiên hơn là người mua dường như hoàn toàn không quan tâm đến giá cả; ngay cả khi một số cuốn sách có giá cao hơn đáng kể so với thị trường, họ vẫn mua ngay.
Trong quá trình diễn ra vụ kiện bản quyền của Anthropic, Tom Harvey, người từng tham gia dự án Google Books và sau đó phụ trách dự án số hóa “Project Panama” của Anthropic, xác nhận rằng Anthropic từng thuê nhiều công ty quét tài liệu chuyên nghiệp để số hóa sách in.
Một trong những công ty hợp tác là Datamation Information Services, đơn vị cung cấp hai loại dịch vụ số hóa sách: quét không phá hủy và quét phá hủy.
Quét không phá hủy thường sử dụng máy quét chụp từ trên cao, máy quét phẳng hoặc thiết bị quét hình chữ V để hoàn tất quá trình số hóa mà không tháo rời sách. Trong khi đó, quét phá hủy sẽ trực tiếp tháo rời sách, đưa từng trang vào máy quét công nghiệp tốc độ cao để xử lý.
Do quét phá hủy có hiệu suất cao hơn và chi phí thấp hơn, các công ty AI thường lựa chọn phương thức này, cuối cùng dẫn đến việc hàng triệu cuốn sách in bị tháo hủy.
Không còn nghi ngờ gì nữa, sách in là một kho tàng tri thức khổng lồ đối với AI. Tuy nhiên, cách làm này cũng làm dấy lên ngày càng nhiều tranh cãi đạo đức.
Các nhà phê bình cho rằng hiện vẫn chưa rõ liệu các công ty AI có phân biệt sách thông thường với sách quý hiếm hay sách đã tuyệt bản trong quá trình số hóa hay không. Nếu những cuốn sách quý hiếm này bị tháo hủy, chúng có thể vĩnh viễn biến mất khỏi lưu thông.
Một vấn đề lớn hơn là nội dung sau khi quét cuối cùng đều được đưa vào cơ sở dữ liệu riêng của các công ty AI, chỉ được dùng để huấn luyện AI, trong khi công chúng không thể truy cập.
Điều đó có nghĩa là con người có thể sở hữu những AI thông minh hơn, nhưng cái giá phải trả có thể là phần lớn tài nguyên tri thức mà nhân loại tích lũy sẽ không còn được lưu giữ cho các thế hệ tương lai dưới hình thức công khai và có thể tiếp cận.