

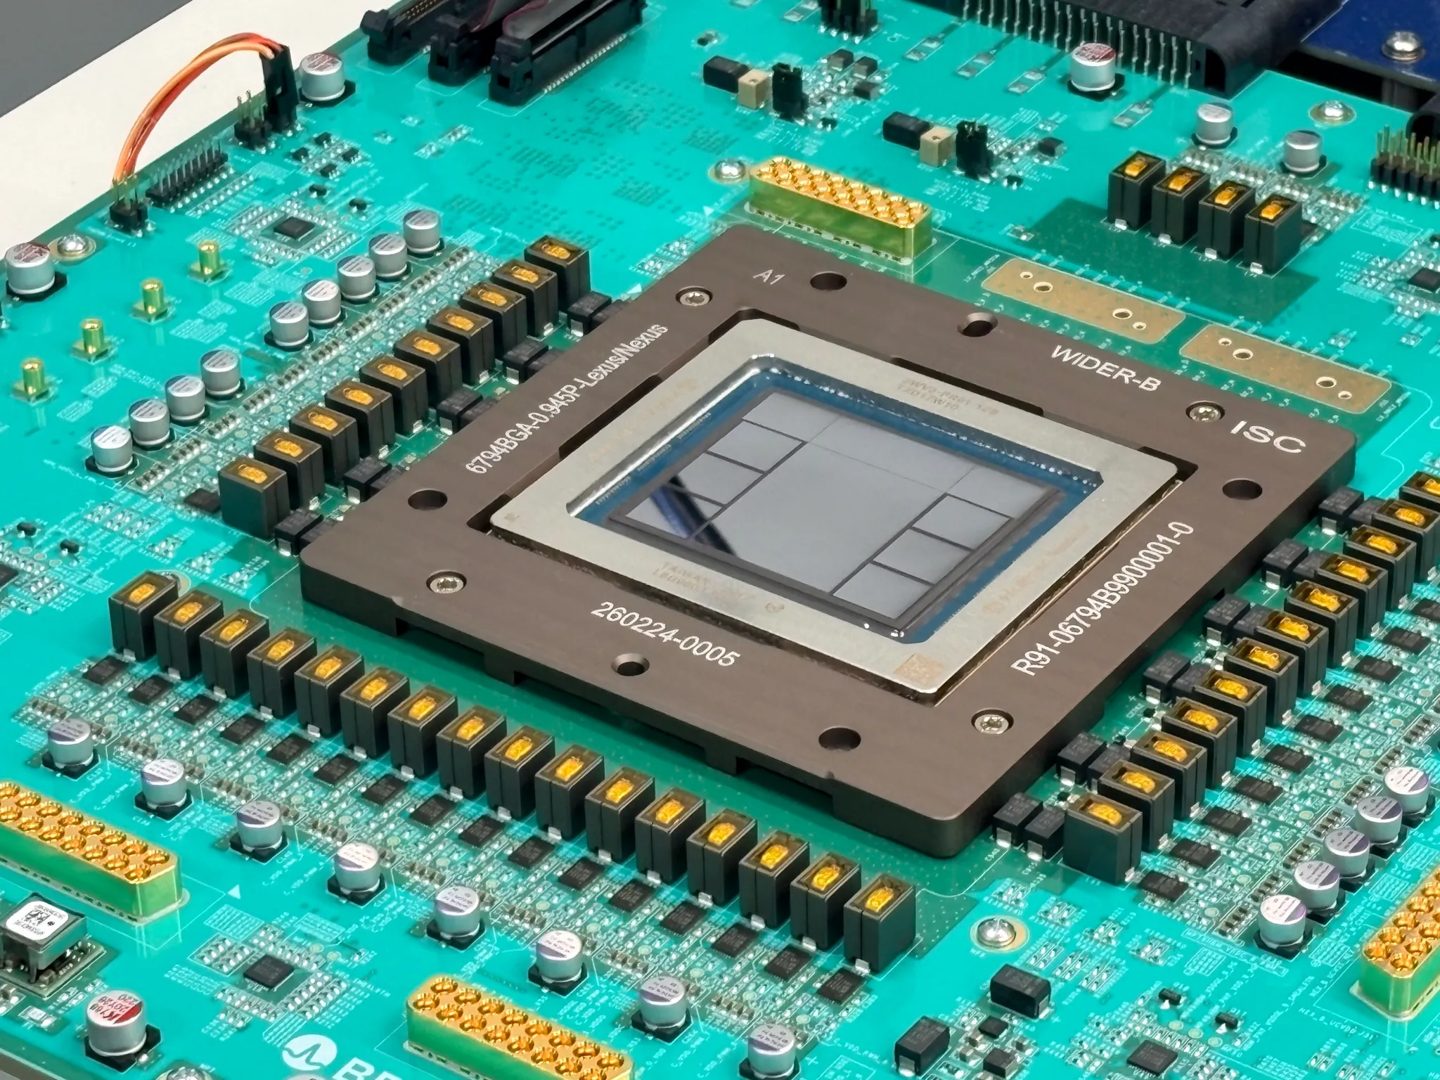
Tối nay (ngày 25), tại hội nghị Hot Chips, OpenAI đã công bố thêm chi tiết về hệ thống suy luận Jalapeño hoàn toàn mới và lần đầu tiết lộ kết quả benchmark. Trong bài kiểm tra InferenceX của SemiAnalysis, Jalapeño vượt qua các bộ xử lý suy luận hàng đầu hiện có trên thị trường cả về số token xử lý trên mỗi người dùng lẫn thông lượng trên mỗi kilowatt.
Richard Ho, người phụ trách phần cứng của OpenAI, cho biết trong cuộc họp báo qua điện thoại: “Điểm quan trọng nhất của kết quả thử nghiệm là Jalapeño đạt được mức cải thiện hiệu năng rất đáng kể so với các sản phẩm tiên tiến nhất hiện nay. Nó có thể xử lý nhiều khối lượng công việc AI hơn với cùng mức điện năng, đồng thời đưa ra phản hồi nhanh hơn. Jalapeño phù hợp để phục vụ hiệu quả số lượng lớn người dùng và vẫn duy trì độ trễ rất thấp.”
Jalapeño được OpenAI và Broadcom cùng phát triển, với các mô hình độc quyền của OpenAI cũng tham gia vào quá trình nghiên cứu và phát triển. OpenAI kỳ vọng phát triển Jalapeño thành một nền tảng công nghệ có thể tiếp nối qua nhiều thế hệ, để sản phẩm AI, mô hình, chip và bộ nhớ được thiết kế đồng bộ ngay từ đầu.
Chip này chủ yếu đảm nhiệm suy luận AI, tức vận hành các mô hình AI đã được huấn luyện để hoàn thành nhiệm vụ hoặc điều khiển tác nhân AI.
OpenAI sử dụng nền tảng InferenceX để kiểm tra hiệu năng suy luận của Jalapeño và so sánh với các hệ thống siêu chip Nvidia GB200 và GB300. OpenAI cho biết, trên ba mô hình GPT-OSS 120B, DeepSeek R1 và Kimi K2.5 1T, khối lượng công việc AI mà Jalapeño có thể hoàn thành trên mỗi watt cao gấp 1.5 đến 1.9 lần các hệ thống đối chiếu, trong khi độ trễ đầu cuối chỉ bằng khoảng 28% đến 59% so với các hệ thống đối chiếu.
Việc phát triển phối hợp toàn bộ hệ thống cũng cho phép OpenAI tối ưu trực tiếp những khâu dễ làm chậm quá trình suy luận nhất. Jalapeño tập trung giảm độ trễ ở giai đoạn tiền điền và giao tiếp, vốn được OpenAI xem là những nút thắt chính của hiệu năng suy luận.
Trong bài viết trên blog công bố kết quả thử nghiệm, OpenAI cho biết Jalapeño được thiết kế ngay từ đầu để hạn chế tối đa việc di chuyển dữ liệu và độ trễ giao tiếp. Các trạng thái mô hình như bộ nhớ đệm KV được sử dụng khi tạo phản hồi có thể được lưu trữ và duy trì rõ ràng tại chỗ; sau đó hệ thống phân bổ các tài nguyên tính toán, bộ nhớ và mạng phù hợp theo từng giai đoạn suy luận.
Theo thông tin IT之家 tìm hiểu, OpenAI dự định triển khai Jalapeño “quy mô nhỏ” trước cuối năm nay, sau đó từng bước mở rộng quy mô triển khai vào năm 2027, nhưng chưa công bố cụ thể năm sau sẽ đưa vào bao nhiêu chip.
Tham khảo
Bài viết chính thức của OpenAI: Jalapeño’s first results show industry-leading speed and efficiency in AI inference