

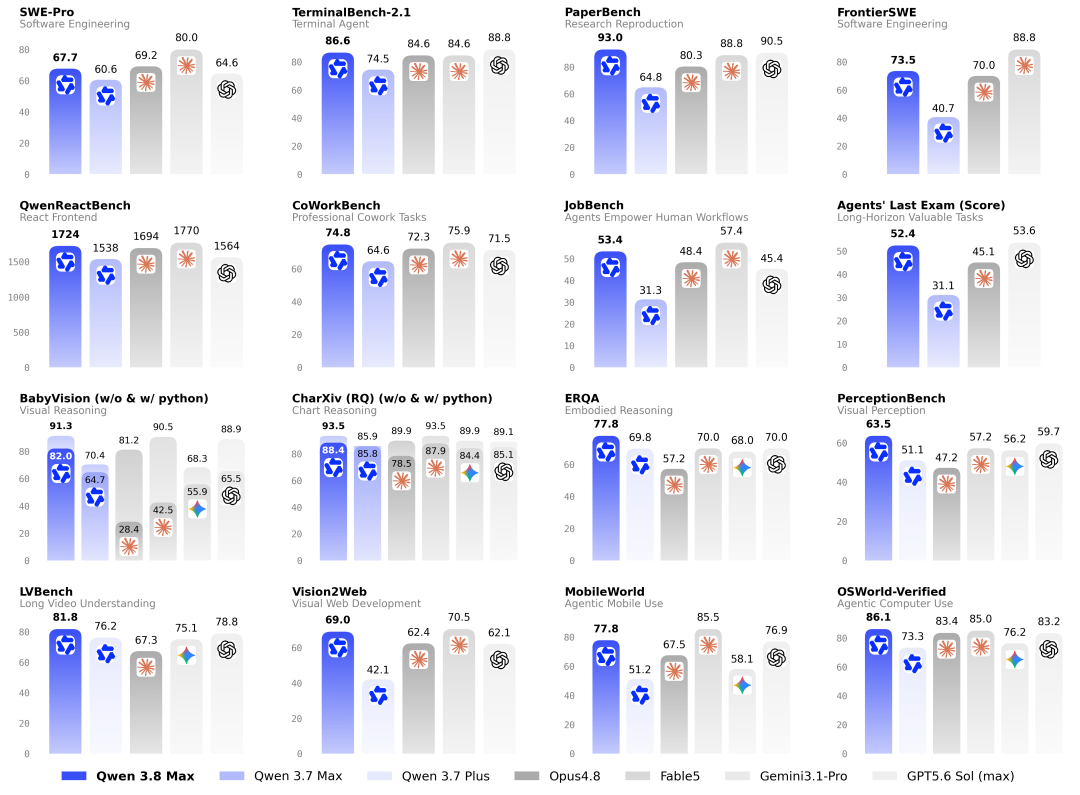
Tài khoản WeChat “Cộng đồng ModelScope Model魔搭” của Alibaba Cloud đã thông báo vào đêm qua (ngày 12) rằng đội ngũ Qwen của Alibaba chính thức mở trọng số mô hình Qwen3.8-2.4T-A95B.
Đây là lần đầu tiên một mô hình cấp Qwen-Max được mở trọng số: mô hình có tổng cộng 2.4T tham số, kích hoạt 95B tham số cho mỗi Token, hỗ trợ nguyên bản ngữ cảnh 262,144 Token và có thể mở rộng lên 1,010,000 Token.
Qwen3.8 kế thừa kiến trúc lai của Qwen3.5, tập trung nâng cao năng lực hoàn thành đầu-cuối các nhiệm vụ Agent về lập trình, văn phòng, nghiên cứu khoa học và chu kỳ dài. Phiên bản đám mây Qwen3.8-Max chính thức dựa trên mô hình có trọng số mở này và bổ sung thêm các năng lực cho môi trường sản xuất.
Các bài đánh giá do chính thức công bố bao phủ nhiều hướng như Agent lập trình, Agent đa năng, công việc chuyên môn và ngữ cảnh dài; khi so sánh với các mô hình như Opus 4.8, Fable 5 và GPT 5.6 Sol, kết quả có cao có thấp tùy hạng mục, đồng thời đạt thành tích tương đối cao trong số các mô hình được liệt kê ở những Benchmark như PaperBench và IFBench.
Các liên kết liên quan như sau:
Mô hình: https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
blog: https://qwen.ai/blog?id=qwen3.8
Qwen Studio: https://chat.qwen.ai
Qwen3.8-2.4T-A95B là một mô hình ngôn ngữ nhân quả, có tổng cộng 2.4T tham số và kích hoạt 95B tham số cho mỗi Token. Mỗi lớp MoE của mô hình bao gồm 512 chuyên gia, mỗi Token chọn 10 chuyên gia định tuyến và đồng thời kích hoạt 1 chuyên gia dùng chung.
Mô hình cũng đã được huấn luyện với MTP nhiều bước (Multi-Token Prediction), cung cấp cho các engine suy luận hỗ trợ cơ chế tương ứng khả năng dự đoán nhiều Token tiếp theo.
Theo giới thiệu, quá trình hậu huấn luyện về văn phòng và Agent của Qwen3.8-Max được khái quát thành ba khâu:
Liên tục mở rộng môi trường thực tế và tách rời theo các chiều độc lập này: tác vụ (Task) (tác vụ đơn → nhiều tác vụ → tác vụ kéo dài nhiều ngày), không gian làm việc (Workspace) (nhiều tệp → thư mục phân cấp → thư mục phức tạp không đồng nhất), Harness (các loại, phiên bản và kỹ năng khác nhau). Nhờ đó, số lượng môi trường có thể tăng trưởng tự nhiên theo cách kết hợp, thay vì phụ thuộc vào việc tích hợp tùy chỉnh từng môi trường.
Xây dựng một hệ thống phần thưởng thống nhất, tích hợp các phương thức xác minh không đồng nhất trong những tác vụ thực tế. Hệ thống này bao gồm kiểm tra dựa trên thực thi, đánh giá rubric đối với văn bản và đầu ra trực quan sau kết xuất, cũng như kiểm tra agentic. Chúng tôi thống nhất nhiều hình thức và phương thức trong một hệ thống phần thưởng, cung cấp tín hiệu phần thưởng nhất quán và đáng tin cậy cho mọi môi trường, loại bỏ sự không nhất quán vốn có khi duy trì các verifier chuyên biệt cho từng tác vụ.
Xây dựng một bộ cân bằng dữ liệu trực tuyến để tái cấu trúc từng batch, giúp phân bổ theo tác vụ, độ khó, không gian làm việc và harness đạt mức cân bằng cao, giảm phương sai gradient giữa các batch, từ đó hỗ trợ mở rộng ổn định và liên tục năng lực tính toán huấn luyện cho học tăng cường.