

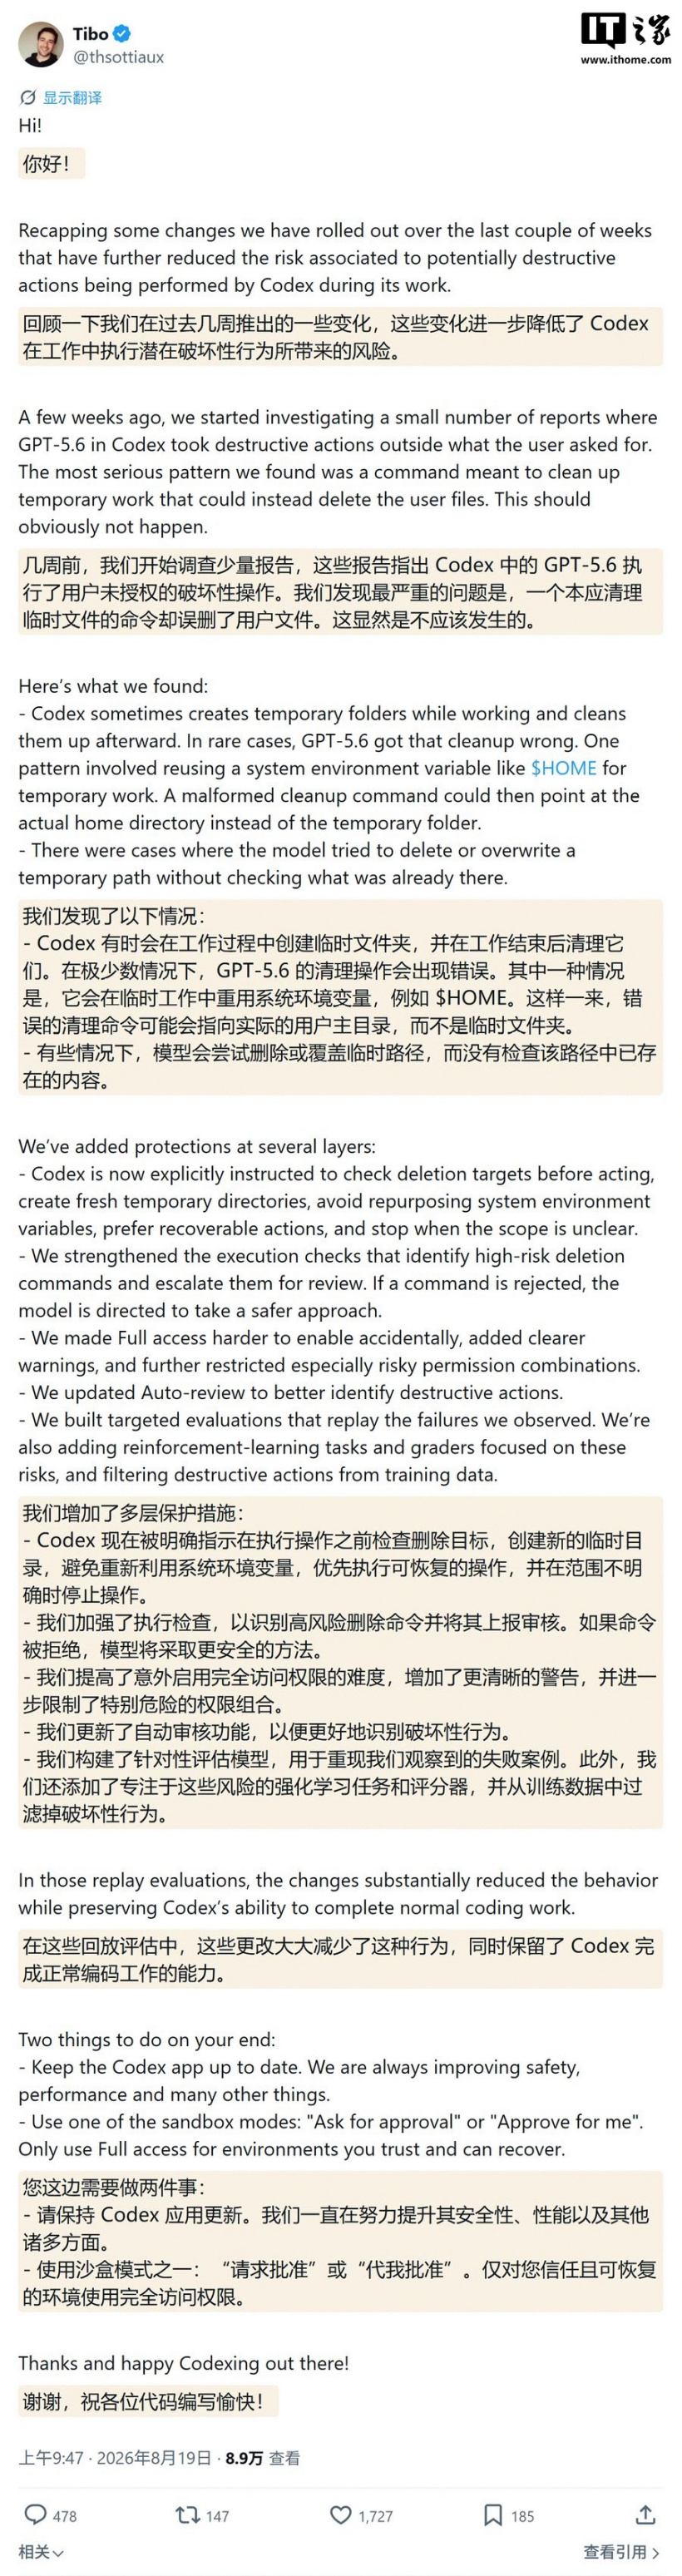
Trưởng nhóm OpenAI Codex Thibault Sottiaux hôm nay đã đăng bài dài trên nền tảng X, phản hồi sự cố xóa nhầm một số tệp của người dùng sau khi gọi các mô hình dòng GPT-5.6 trong Codex.
Sottiaux cho biết từ vài tuần trước đã lần lượt nhận được phản hồi từ một số ít người dùng Codex rằng sau khi sử dụng các mô hình dòng GPT-5.6 trong Codex, hệ thống đã thực hiện các thao tác phá hủy mà người dùng không ủy quyền. OpenAI phát hiện các lệnh vốn dùng để dọn dẹp tệp tạm lại xóa nhầm tệp của người dùng.
Một trong những trường hợp là Codex tái sử dụng các biến môi trường hệ thống như $HOME trong công việc tạm thời. Do đó, lệnh dọn dẹp sai có thể trỏ tới thư mục chính thực tế của người dùng. Trong một số trường hợp, mô hình cố gắng xóa hoặc ghi đè đường dẫn tạm mà không kiểm tra nội dung đã tồn tại trong đường dẫn đó. Ảnh chụp màn hình liên quan như sau:
Sottiaux phản hồi rằng đã bổ sung nhiều lớp biện pháp bảo vệ:
Codex hiện được chỉ thị rõ ràng phải kiểm tra mục tiêu xóa trước khi thực hiện thao tác, tạo thư mục tạm mới, tránh tái sử dụng biến môi trường hệ thống, ưu tiên các thao tác có thể khôi phục, và dừng thao tác khi phạm vi không rõ ràng.
OpenAI đã tăng cường kiểm tra thực thi, cải thiện khả năng nhận diện các lệnh xóa rủi ro cao và báo cáo để xét duyệt. Nếu lệnh bị từ chối, mô hình sẽ áp dụng phương pháp an toàn hơn.
OpenAI đã tăng độ khó khi vô tình bật quyền truy cập đầy đủ, bổ sung các cảnh báo rõ ràng hơn, và hạn chế thêm các tổ hợp quyền đặc biệt nguy hiểm.
OpenAI đã cập nhật chức năng kiểm duyệt tự động để nhận diện tốt hơn các hành vi phá hủy.
OpenAI đã xây dựng mô hình đánh giá có mục tiêu để tái hiện các trường hợp thất bại đã quan sát được. Ngoài ra, chúng tôi còn thêm các nhiệm vụ học tăng cường và bộ chấm điểm tập trung vào những rủi ro này, đồng thời lọc các hành vi phá hủy khỏi dữ liệu huấn luyện.