

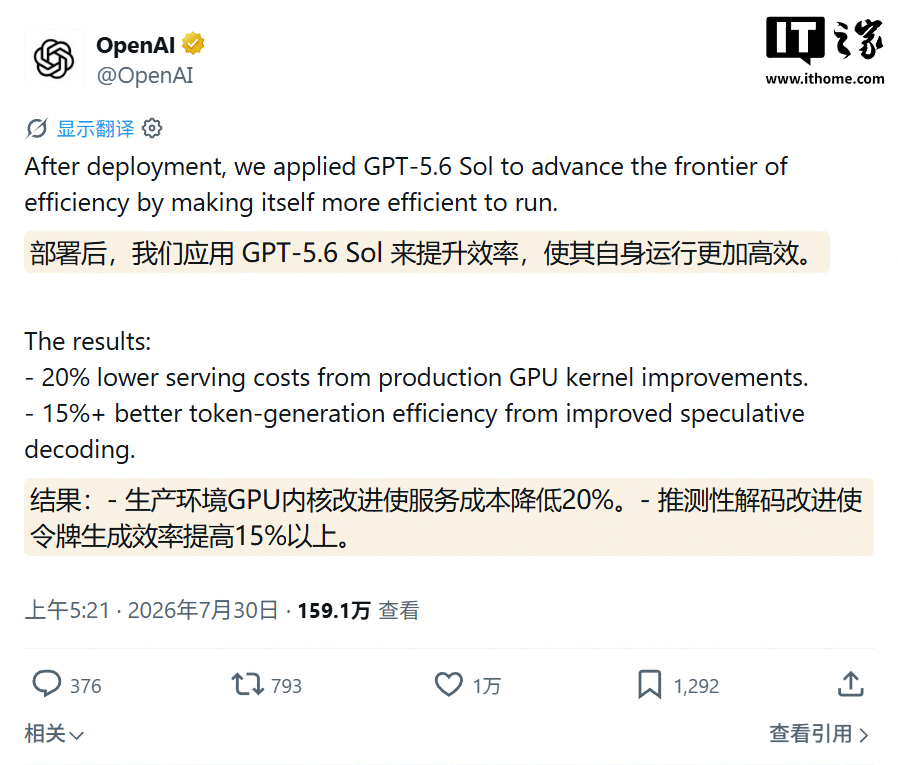
Hôm qua (29 tháng 7), OpenAI đăng bài viết thông báo sử dụng mô hình GPT-5.6 Sol để tối ưu chuỗi suy luận AI của chính các mô hình thuộc dòng GPT-5.6, qua đó giúp chi phí dịch vụ đầu cuối giảm tối đa 20%.
OpenAI ra mắt dòng mô hình AI mạnh nhất GPT-5.6 vào ngày 9 tháng 7. Trong quá trình tối ưu kiến trúc sau đó, đội ngũ chính thức đã sử dụng mô hình GPT-5.6 Sol để tối ưu hiệu suất vận hành, giảm chi phí tính toán và nâng cao hiệu quả sử dụng GPU.
OpenAI cho biết hệ thống phân bổ yêu cầu dựa trên khu vực, dung lượng khả dụng và loại bộ tăng tốc; trong mỗi cụm, hệ thống còn phân phối tác vụ dựa trên các yếu tố như tải, độ dài ngữ cảnh và khả năng sử dụng bộ nhớ đệm. GPT‑5.6 Sol phân tích lưu lượng sản xuất thông qua Codex, xác định nguyên nhân mất cân bằng tải, thử nghiệm các chiến lược định tuyến và điều chỉnh các quy tắc heuristic.
Trong quá trình truyền tiến mô hình, GPT‑5.6 Sol xác định những tác vụ có thể được tính toán trước, loại bỏ hoặc xử lý song song, đồng thời tự viết lại và tối ưu các kernel GPU trong môi trường sản xuất thông qua Codex. Ảnh chụp màn hình liên quan như sau:
Đội ngũ đã cho mô hình GPT-5.6 Sol học hai ngôn ngữ lập trình Triton và Gluon, để mô hình dựa trên đó tối ưu kernel của công cụ suy luận, giúp chi phí dịch vụ đầu cuối do kernel GPU trong môi trường sản xuất tạo ra giảm tối đa 20%.
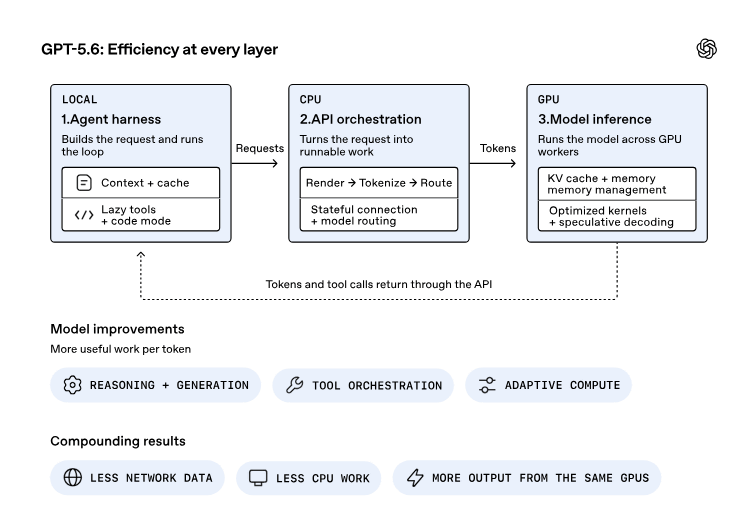
OpenAI cũng sử dụng công cụ mã nguồn mở FpSan (trình dọn dẹp số dấu phẩy động) để xác minh tính chính xác của các kernel do GPT‑5.6 Sol viết.
OpenAI còn cho GPT-5.6 Sol tối ưu giải mã suy đoán (speculative decoding). Đây là kỹ thuật tăng tốc suy luận, trong đó một mô hình nháp nhỏ dự đoán token tiếp theo, sau đó mô hình chính xác minh hoặc sửa kết quả dự đoán. Trong bài đăng công khai ngày 29 tháng 7 năm 2026, OpenAI cho biết hiệu suất tạo token sau cải tiến đã tăng hơn 15%.