
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-10-10
01TalkLikeYou là gì
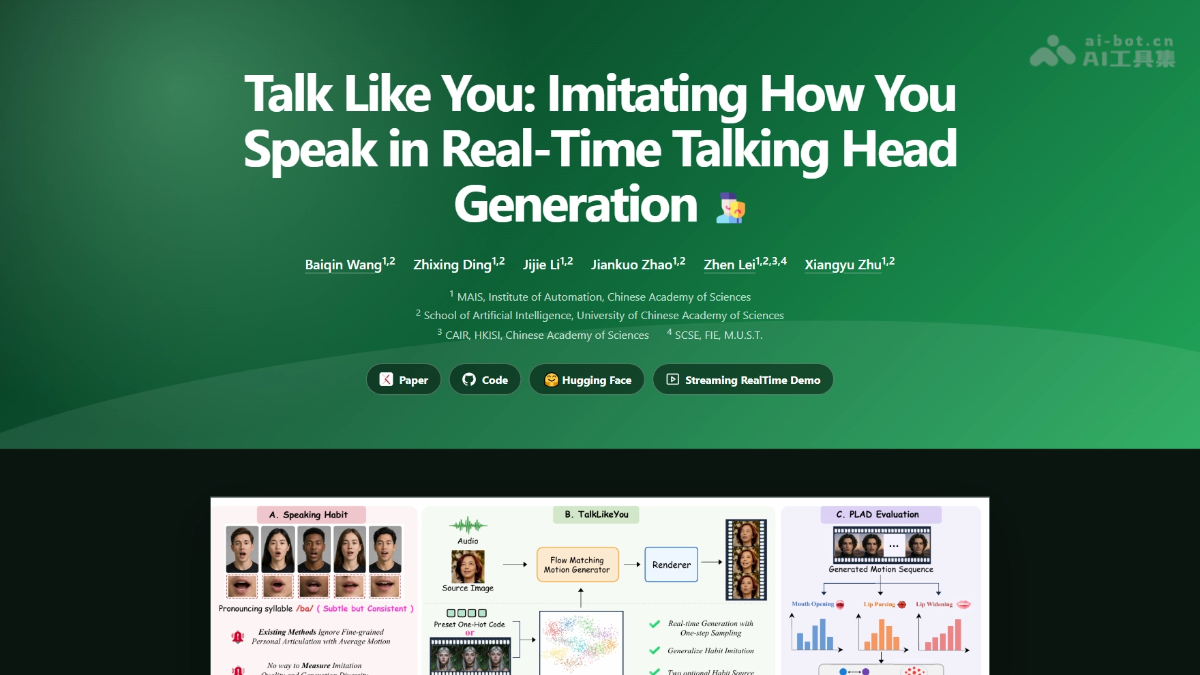
TalkLikeYou là framework người kỹ thuật số thời gian thực mã nguồn mở của Viện Tự động hóa thuộc Viện Hàn lâm Khoa học Trung Quốc. Chỉ cần một bức ảnh và một đoạn âm thanh, framework có thể khiến người trong ảnh mở miệng nói chuyện, đồng thời mô phỏng thói quen nói của một người thật được chỉ định thông qua chuyển động môi. TalkLikeYou sử dụng mô hình hóa không gian chuyển động và lấy mẫu một bước để tạo nội dung theo thời gian thực, hỗ trợ tùy chỉnh thói quen bằng mã cài đặt sẵn hoặc video tham chiếu, đồng thời đề xuất các chỉ số chuyên dụng để định lượng độ tương đồng khi mô phỏng. Toàn bộ mã nguồn và trọng số đều được mở.
02Các tính năng chính của TalkLikeYou
Ảnh biết nói: Tải lên một ảnh chân dung và một đoạn âm thanh để tạo video nhân vật mở miệng nói chuyện.
Mô phỏng thói quen: Mô phỏng thói quen chuyển động môi khi nói của một người thật được chỉ định, thông qua mã cài đặt sẵn hoặc video tham chiếu dài 4 giây.
Tạo thời gian thực: Sử dụng công nghệ lấy mẫu một bước, tốc độ tạo đạt 32.43 FPS và hỗ trợ đầu ra luồng thời gian thực.
Lồng tiếng video: Thay thế chuyển động môi của nhân vật trong video, giữ nguyên chuyển động đầu và trình tự thời gian ban đầu, phù hợp để lồng tiếng đa ngôn ngữ.
Người kỹ thuật số đối thoại: Sau khi kết nối với mô hình lớn, nhận dạng giọng nói và tổng hợp giọng nói, có thể tạo bản sao kỹ thuật số tương tác đối thoại theo thời gian thực.
Điều khiển phong cách: Hỗ trợ điều khiển chân dung theo các phong cách phi hiện thực như phác họa, tranh sơn dầu, anime và nhân vật 3D.
03Nguyên lý kỹ thuật của TalkLikeYou
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi các dự án AI mã nguồn mở
Mô hình hóa không gian chuyển động: Khác với việc trực tiếp tạo hình ảnh trong không gian pixel, TalkLikeYou trước tiên phân tích ảnh thành các tham số chuyển động, sau đó học và tạo chuyển động nói trên tập dữ liệu số gọn nhẹ này, rồi dùng bộ kết xuất để tổng hợp trở lại thành video, cân bằng giữa tốc độ và độ ổn định nhận dạng.
Lấy mẫu Flow Matching một bước: Sử dụng Flow Matching để học đường đi thẳng từ nhiễu đến mục tiêu, kết hợp tái tham số hóa để trực tiếp dự đoán chuỗi chuyển động sạch. Lấy mẫu một bước có thể đạt chất lượng đồng bộ môi gần tương đương 50 bước, đạt tốc độ thời gian thực 32.43 FPS.
Không gian thói quen thống nhất: Xây dựng không gian vector thói quen chiều thấp có thể nội suy, nén thống kê chuyển động môi của người thật trong tập dữ liệu thành mã one-hot. Video tham chiếu được mã hóa vào cùng không gian thông qua bộ trích xuất thói quen; hai phương thức đầu vào có thể chuyển đổi tự do, thậm chí nội suy và trộn lẫn.
Chiến lược huấn luyện hai giai đoạn: Trước tiên sử dụng HDTF với quy mô 380 người và mã one-hot để học “thói quen là gì”, sau đó chuyển sang huấn luyện bằng video tham chiếu trên CelebV-HQ quy mô lớn để nâng cao khả năng khái quát hóa. Dữ liệu one-hot được phát lại định kỳ nhằm ngăn hiện tượng quên, giúp độ tương đồng thói quen tăng từ 0.33 lên 0.64.
Chỉ số đánh giá PLAD: Chiếu chuyển động môi lên ba trục phát âm gồm độ mở miệng, độ khép môi và độ kéo ngang môi, sau đó so sánh biểu đồ phân phối với người tham chiếu để tính độ tương đồng. Đây là lần đầu tiên cung cấp tiêu chuẩn định lượng cho câu hỏi “thói quen nói có giống nhau không”.
04Cách sử dụng TalkLikeYou
Chuẩn bị môi trường: Sử dụng hệ thống Linux, cài đặt Python 3.10 + CUDA 12.1 + FFmpeg, đồng thời đảm bảo GPU NVIDIA có ít nhất 12GB VRAM.
Tải mã nguồn: Clone kho chính TalkLikeYou từ GitHub.
Cài đặt dependencies: Chạy conda env create -f environment.yaml để tạo và kích hoạt môi trường, hoặc tự cài PyTorch phiên bản CUDA rồi chạy pip install -r requirements.txt.
Tải trọng số: Sử dụng lệnh hf download doubi-killer/TalkLikeYou trên Hugging Face để tải trọng số mô hình vào thư mục gốc của kho.
Chuẩn bị dữ liệu: Chuẩn bị một ảnh chân dung (hoặc video) và một đoạn âm thanh; video đầu vào phải có tốc độ 25 FPS.
Chạy suy luận: Thực thi python -m talklikeyou --source ảnh --audio âm thanh --person-id 192 --sampling-steps 1 để tạo video; thay đổi --person-id để thay đổi thói quen nói.
Tùy chỉnh thói quen: Thay --person-id bằng --habit-reference và trỏ đến một video tham chiếu có ít nhất 100 khung hình để mô phỏng thói quen nói của nhân vật trong video đó.
Lồng tiếng video: Trỏ --source đến tệp video và thêm --pose-mode source để chỉ thay thế chuyển động môi, đồng thời giữ nguyên chuyển động đầu gốc.
05Ưu điểm cốt lõi của TalkLikeYou
Mô phỏng thói quen nói riêng biệt: Framework mã nguồn mở đầu tiên trong ngành mô hình hóa thói quen chuyển động môi khi nói của từng cá nhân như một thành phần cốt lõi. Có thể chỉ định bằng mã hoặc video, thoát khỏi tình trạng chuyển động môi trung bình “trăm người như một”.
Tốc độ thời gian thực cao: Lấy mẫu Flow Matching một bước đạt 32.43 FPS, nhanh gần 100 lần so với Sonic theo hướng khuếch tán hình ảnh, trong khi mức sử dụng VRAM trên một RTX 3090 dưới 4GB.
Cân bằng chất lượng hình ảnh và đồng bộ: FID 7.71, chưa bằng một phần ba của vị trí thứ hai; Sync-C 8.73 cao nhất trong toàn bộ bài đánh giá, đồng thời đảm bảo đồng bộ môi và chất lượng hình ảnh.
Dẫn đầu về độ tương đồng thói quen: Độ tương đồng thói quen theo chỉ số PLAD đạt 0.62, cao hơn đáng kể so với MimicTalk (0.48), PC-Talk (0.39) và các đối thủ khác.
Tùy chỉnh linh hoạt với hai phương thức: Hỗ trợ chuyển đổi phong cách miễn phí bằng mã cài đặt sẵn chính thức, đồng thời có thể học ngay từ bất kỳ video tham chiếu nào và nội suy để tạo thói quen mới.
06Địa chỉ dự án TalkLikeYou
Trang web dự án: https://bq-wang0511.github.io/TalkLikeYou/
Kho GitHub: https://github.com/BQ-Wang0511/TalkLikeYou
Kho mô hình Hugging Face: https://huggingface.co/doubi-killer/TalkLikeYou
Bài báo kỹ thuật arXiv: https://arxiv.org/pdf/2610.06658
07Các kịch bản ứng dụng của TalkLikeYou
Streamer ảo/bán hàng trực tiếp: Xây dựng streamer ảo có thói quen nói riêng với chi phí thấp; có thể chạy thời gian thực cục bộ trên GPU với 4GB VRAM mà không cần người thật xuất hiện.
Lồng tiếng video đa ngôn ngữ: Thay thế chuyển động môi của nhân vật trong video và giữ nguyên chuyển động đầu cùng trình tự thời gian, giúp khẩu hình của phim lồng tiếng hoặc nội dung phát hành quốc tế tự nhiên hơn với ngôn ngữ đích.
Bản sao kỹ thuật số/chăm sóc khách hàng ảo: Kết hợp mô hình lớn và tổng hợp giọng nói để xây dựng bản sao đối thoại thời gian thực, ứng dụng trong chăm sóc khách hàng trực tuyến, hướng dẫn thông minh và các tình huống cần tương tác “mặt đối mặt”.
Giáo dục/đào tạo cá nhân hóa: Tạo hình ảnh kỹ thuật số riêng cho giáo viên hoặc giảng viên, tái hiện phong cách nói đặc trưng của họ để ghi hình khóa học hoặc giảng dạy từ xa.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0