
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-09
01Ling-3.0-flash-VL là gì
Ling-3.0-flash-VL là mô hình ngôn ngữ đa phương thức gốc mã nguồn mở đầu tiên thuộc dòng Bailing của Ant Group InclusionAI, được mở rộng từ kiến trúc MoE của Ling-3.0-flash, với tổng cộng 124B tham số và chỉ kích hoạt 5.5B tham số mỗi lần suy luận, hỗ trợ gốc đầu vào hình ảnh-văn bản và video, với cửa sổ ngữ cảnh lên đến 256K Token. Ling-3.0-flash-VL cho phép mô hình vừa quan sát, vừa hành động, vừa xác minh và tự điều chỉnh như con người, biến nhiệm vụ từ việc tạo nội dung một lần thành quá trình bàn giao liên tục đáng tin cậy.
02Các tính năng chính của Ling-3.0-flash-VL
Tương tác thị giác thời gian thực: vừa mở camera vừa trò chuyện, có thể nhận diện động thực vật, địa danh, mẫu xe và dịch theo thời gian thực các biển hiệu bằng tiếng nước ngoài.
Lập trình với phản hồi thị giác: tạo mã frontend dựa trên ảnh chụp màn hình trang web, sau đó tự điều chỉnh bằng cách đối chiếu với kết quả hiển thị để tái tạo trang web.
GUI Agent: nhận diện cấu trúc giao diện và trạng thái thao tác, hoàn thành nhiệm vụ xuyên suốt nhiều công cụ, chẳng hạn như tra cứu dữ liệu web, sắp xếp Excel và tạo biểu đồ.
Diễn giải báo cáo y tế: trích xuất các chỉ số xét nghiệm công thức máu, sinh hóa, hình ảnh y khoa qua nhiều trang và nhiều kỳ, đồng thời hiển thị rủi ro sức khỏe bằng đèn đỏ, vàng, xanh.
Đối tác học tập thời gian thực: nhận diện công thức và nội dung trên bảng từ video bài giảng, giải đáp ngay lập tức và tạo bài tập.
Biên tập điểm nhấn video dài: thực hiện quy trình “định vị→trích xuất→xác minh→điều chỉnh” trên video trận đấu kéo dài hàng giờ, tự động tổng hợp video nổi bật.
03Nguyên lý kỹ thuật của Ling-3.0-flash-VL
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
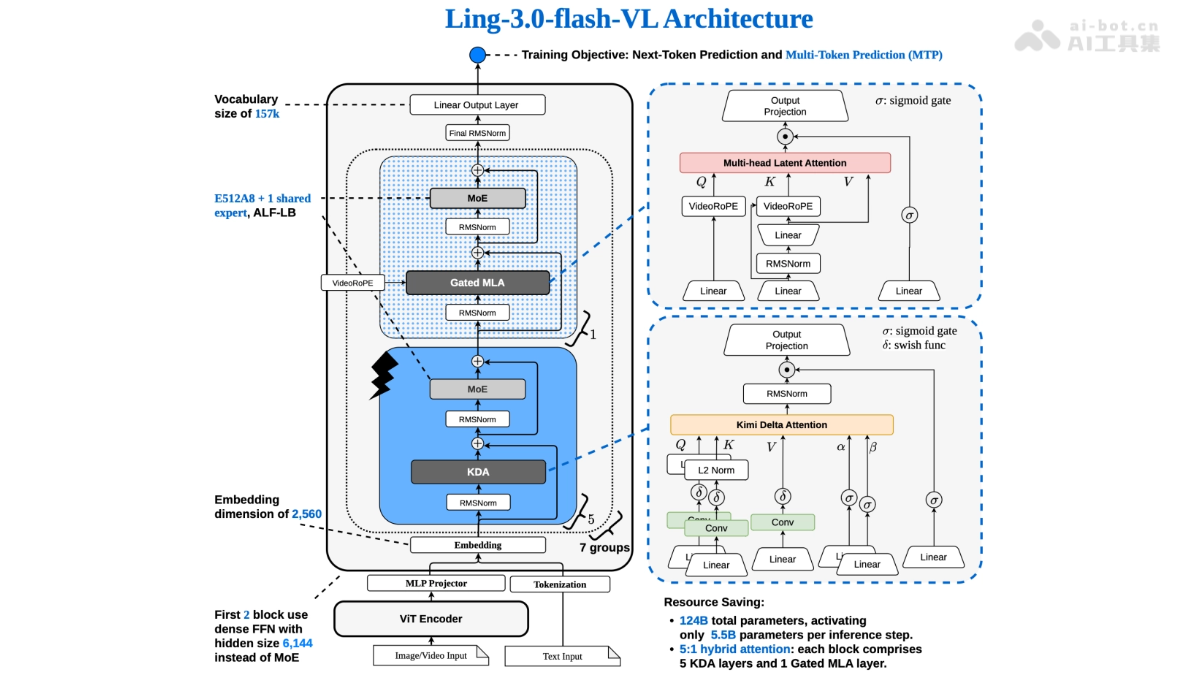
Kiến trúc MoE thưa hiệu quả cao: mô hình được mở rộng từ Ling-3.0-flash, có tổng cộng 124B tham số nhưng mỗi lần suy luận chỉ kích hoạt 5.5B tham số, vừa duy trì năng lực vừa giảm đáng kể chi phí tính toán, phù hợp làm nút thực thi thường xuyên trong quy trình Agent.
Huấn luyện kết hợp đa phương thức gốc: hình ảnh, văn bản và video được tối ưu hóa đồng thời trong cùng một quá trình huấn luyện, thay vì huấn luyện văn bản trước rồi gắn thêm mô-đun thị giác. Thực tế cho thấy việc đưa thông tin thị giác vào không làm giảm năng lực văn bản, mà còn giúp tăng 4 điểm trên Artificial Analysis Intelligence Index.
Mã hóa thị giác độ phân giải bất kỳ và VideoRoPE: sử dụng bộ mã hóa thị giác độ phân giải bất kỳ để xử lý đầu vào hình ảnh-văn bản có kích thước khác nhau, kết hợp mã hóa vị trí VideoRoPE để hiểu video gốc mà không cần tách video thành chuỗi khung hình rồi hạ cấp thành hình ảnh.
Trục ngôn ngữ kết hợp KDA và Gated MLA: phần ngôn ngữ sử dụng kiến trúc kết hợp 42 lớp, luân phiên cơ chế attention tuyến tính KDA và MLA có cổng theo tỷ lệ 5:1, cân bằng hiệu quả xử lý ngữ cảnh dài với độ chính xác mô hình hóa, hỗ trợ cửa sổ ngữ cảnh 256K Token.
Cơ chế vòng lặp phản hồi thị giác: mô hình áp dụng phương thức thực thi lặp “quan sát→hành động→xác minh→điều chỉnh”, chuyển nhiệm vụ từ tạo nội dung một lần thành nhiều vòng lặp: trước tiên hiểu thông tin thị giác và hành động, sau đó quan sát kết quả thực thi để so sánh với mục tiêu, rồi điều chỉnh chiến lược khi phát hiện sai lệch, bảo đảm kết quả bàn giao đáng tin cậy và có thể xác minh.
04Cách sử dụng Ling-3.0-flash-VL
Trải nghiệm trực tuyến: Mở trang web chính thức: truy cập trang web Ling Studio https://chat.ant-ling.com/chat.
Sử dụng miễn phí: hiện đang trong giai đoạn trải nghiệm miễn phí, có thể trò chuyện trực tiếp sau khi đăng nhập.
Tải tài nguyên: nhập lời nhắc bằng văn bản, đồng thời có thể tải lên hình ảnh hoặc video để tương tác đa phương thức.
Thử các tình huống: có thể thử các khả năng tiêu biểu như tái tạo trang web từ ảnh chụp màn hình, đặt câu hỏi về video và nhận diện hình ảnh chụp.
Triển khai cục bộ: Tải mô hình: lấy trọng số mã nguồn mở từ Hugging Face hoặc ModelScope; các phiên bản BF16 và FP8 đã khả dụng, phiên bản FP4/INT4 sắp ra mắt.
Chuẩn bị môi trường: cấu hình môi trường suy luận hỗ trợ quy mô tham số này.
Nạp suy luận: sử dụng các framework suy luận phổ biến để nạp mô hình, hỗ trợ gốc đầu vào hình ảnh-văn bản và video, với ngữ cảnh có thể mở rộng lên 256K Token.
Tích hợp quy trình: sử dụng API để biến mô hình thành nút thực thi của visual Agent, tích hợp vào quy trình tác vụ nhiều vòng “quan sát→hành động→xác minh→điều chỉnh”.
05Ưu điểm cốt lõi của Ling-3.0-flash-VL
Đa phương thức hỗ trợ ngược cho văn bản: huấn luyện kết hợp đa phương thức gốc không làm suy giảm năng lực văn bản, mà còn giúp tăng 4 điểm so với phiên bản chỉ có văn bản trên Artificial Analysis Intelligence Index.
Vòng lặp phản hồi thị giác: thông qua cơ chế lặp “quan sát→hành động→xác minh→điều chỉnh”, nâng cấp nhiệm vụ từ tạo nội dung một lần thành quá trình bàn giao liên tục đáng tin cậy và có thể xác minh.
Hiệu quả suy luận vượt trội: với tổng cộng 124B tham số, mỗi lần suy luận chỉ kích hoạt 5.5B, giảm đáng kể chi phí tính toán và Token, phù hợp với các cuộc gọi nhiều vòng có tần suất cao.
Ngữ cảnh siêu dài: hỗ trợ gốc 256K Token, dễ dàng xử lý phân tích tài liệu dài, video dài và bộ nhớ lịch sử của Agent nhiều bước.
Đầu vào gốc toàn phương thức: sử dụng bộ mã hóa thị giác độ phân giải bất kỳ và VideoRoPE để xử lý gốc hình ảnh, văn bản và video mà không cần tách khung hình rồi hạ cấp.
Thành tích thực tế nổi bật: trong đánh giá Image-to-WebDev Arena, đạt điểm cao hơn GPT-5.4 với quy mô chỉ 5.5B tham số được kích hoạt.
06Địa chỉ dự án Ling-3.0-flash-VL
Kho mô hình HuggingFace: https://huggingface.co/inclusionAI/Ling-3.0-flash-VL
https://huggingface.co/inclusionAI/Ling-3.0-flash-VL-fp8
07Các tình huống ứng dụng của Ling-3.0-flash-VL
Phát triển frontend và tái tạo trang web: tạo mã trang web có thể chạy dựa trên ảnh chụp màn hình thiết kế, sau đó liên tục tự điều chỉnh thông qua việc so sánh kết quả hiển thị.
Tự động hóa văn phòng bằng GUI: thực hiện nhiệm vụ trên nhiều phần mềm, chẳng hạn như thu thập dữ liệu web, sắp xếp vào Excel và tự động tạo biểu đồ.
Hỗ trợ diễn giải báo cáo y tế: tổng hợp nhiều loại báo cáo như công thức máu, sinh hóa và hình ảnh y khoa, trích xuất các chỉ số bất thường và phân cấp rủi ro sức khỏe bằng đèn đỏ, vàng, xanh.
Đối tác học tập giáo dục trực tuyến: kết hợp hình ảnh trong video bài giảng để giải thích công thức và nội dung trên bảng, giải đáp ngay lập tức và tạo bài tập xoay quanh các điểm kiến thức.
Biên tập điểm nhấn sự kiện thể thao: thực hiện quy trình “định vị→trích xuất→xác minh→điều chỉnh” trên video trận đấu dài hàng giờ, tự động tổng hợp các đoạn nổi bật mượt mà.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0