
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-11-10
01Sophon-Realtime v1 là gì
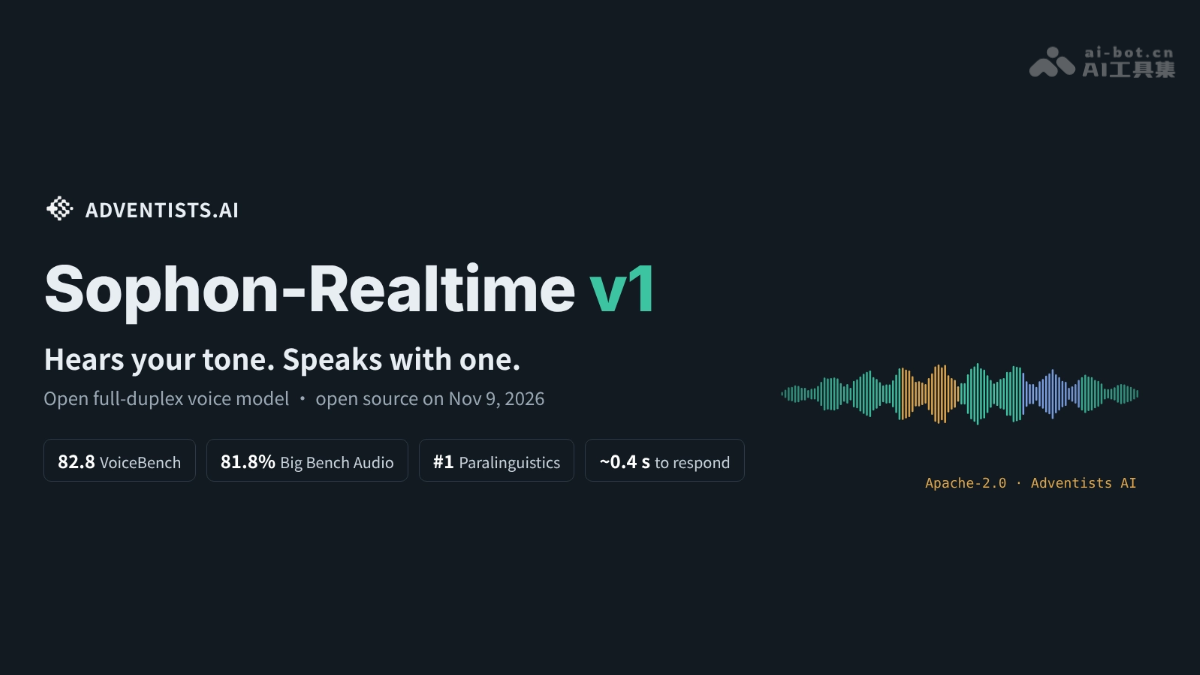
Sophon-Realtime v1 là mô hình giọng nói song công toàn phần mã nguồn mở do AI降临派 (Adventists AI) phát triển, có thể vừa nghe vừa xác định lượt nói, bị ngắt bất cứ lúc nào, hiểu ngữ điệu, tiếng cười và tiếng thở dài, đồng thời phản hồi bằng giọng nói giàu cảm xúc. Sophon-Realtime v1 dựa trên 32B tham số, đạt 82.8 điểm trên bài đánh giá giọng nói VoiceBench, đứng đầu trong các mô hình song công toàn phần mã nguồn mở. Sophon-Realtime v1 cung cấp ba phiên bản: Tag (biểu cảm mạnh), Flash (phản hồi nhanh) và E2E (bản xem trước nghiên cứu); chỉ cần một GPU 80GB để triển khai, sử dụng giấy phép Apache-2.0 và có thể dùng cho mục đích thương mại.
02Các tính năng chính của Sophon-Realtime v1
Hội thoại song công toàn phần: luôn lắng nghe khi đang nói, người dùng vừa dừng là mô hình tiếp lời, và lập tức dừng để trả lời câu hỏi mới khi bị ngắt.
Hiểu ngữ điệu: nhận diện thông tin ngôn ngữ phi từ vựng như do dự, nhấn mạnh, tiếng cười, tiếng thở dài và lời nói mỉa mai, không chỉ nghe nội dung theo nghĩa đen.
Thể hiện ngữ điệu: khi trả lời, giọng nói tự nhiên có thể bật cười, thở dài, hắng giọng và lấy hơi, thay vì đọc các từ mô tả.
Hiểu đa phương thức: có thể xem biểu đồ và ảnh chụp màn hình, hiểu nội dung rồi diễn giải bằng lời.
Gọi công cụ: hỗ trợ gọi công cụ nhiều bước (Full-Duplex-Bench v3 Pass@1 đạt 48%), có thể “làm việc”.
Chế độ Live: tương thích với giao thức OpenAI GPT-Live và có thể phối hợp với mô hình lớn ở backend.
Triển khai nhanh: chỉ cần một lệnh và một GPU 80GB để đưa vào vận hành; phiên bản Flash có thời gian trả về gói đầu tiên chỉ 0.31 giây.
Có thể tinh chỉnh: sử dụng ms-swift và LoRA để tinh chỉnh tính cách, giọng điệu, kiến thức chuyên ngành và thói quen gọi công cụ.
03Nguyên lý kỹ thuật của Sophon-Realtime v1
04Cách sử dụng Sophon-Realtime v1
Môi trường cài đặt: đảm bảo hệ thống là Linux + CUDA + Python 3.12, chạy pip install sophon-realtime.
Khởi động dịch vụ: chạy sophon-realtime serve; lần khởi động đầu tiên sẽ tự động tải khoảng 42GB trọng số Tag, sau đó dịch vụ lắng nghe trên cổng 8000.
Gọi API: tương tác với mô hình qua ws://HOST:8000/v1/realtime (song công toàn phần) hoặc POST /v1/chat/completions (nhận giọng nói, trả về văn bản + giọng nói).
Kiểm tra hội thoại: chạy python client_example.py --wav 我的问题.wav --lang zh --voice vivian_zh để gửi một đoạn giọng nói và nghe phản hồi.
Kết nối chế độ Live (tùy chọn): chạy cd sophon-realtime/live && BUILD=tag PORT=8000 LIVE_PORT=8780 bash start_live.sh bên cạnh engine để kết nối mô hình lớn backend của bạn qua giao thức OpenAI GPT-Live.
Tùy chỉnh tinh chỉnh (tùy chọn): dùng ms-swift để huấn luyện bằng LoRA trên GPU 80GB, chuẩn bị dữ liệu hội thoại định dạng jsonl (ghi âm thanh bằng 、thêm các thẻ như [laughter] vào phản hồi), rồi chạy lệnh swift sft để thay đổi tính cách và kiến thức chuyên ngành.
05Ưu thế cốt lõi của Sophon-Realtime v1
Dẫn đầu trong các mô hình song công toàn phần mã nguồn mở: đạt 82.8 điểm trên VoiceBench, ngang bằng GPT-4o-mini-Audio và vượt qua các mô hình song công toàn phần mã nguồn mở khác như MiniCPM-o 4.5 (76.1).
Suy luận giọng nói mạnh nhất: trả lời đúng 81.8% trên Big Bench Audio với 1,000 câu hỏi suy luận bằng giọng nói, vượt xa mô hình mã nguồn mở tốt nhất trước đó là Raon SpeechChat (58%).
Hiểu ngữ điệu: mô hình thính giác DuplexJev đứng đầu tổng hợp trên các chuẩn đánh giá ngôn ngữ phi từ vựng LISTEN, StressTest và MSPB (48.6), cao hơn Gemini 3.8 Flash và Qwen3-Omni.
Thể hiện ngữ điệu: trên NVV-SuperBench, phiên bản Tag đạt 0.86 với tiếng Trung và 0.80 với tiếng Anh, thể hiện tiếng cười, tiếng thở dài, hắng giọng và các biểu cảm khác chân thực nhất.
Có thể làm việc: Pass@1 trong gọi công cụ trên Full-Duplex-Bench v3 đạt 48%, cao hơn Grok (43%); khi cần tiếp lời, mô hình tiếp lời 100%.
Nhanh và chịu tải tốt: phiên bản Flash có thời gian trả về gói đầu tiên 0.31 giây, một GPU hỗ trợ 40 luồng đồng thời; phiên bản Tag khoảng 0.6 giây, hỗ trợ 16 luồng đồng thời.
06Địa chỉ dự án Sophon-Realtime v1
Kho GitHub: https://github.com/adventists-ai/sophon-realtime
07Các kịch bản ứng dụng của Sophon-Realtime v1
Chăm sóc khách hàng thông minh: phiên bản Flash có thời gian trả về gói đầu tiên 0.31 giây, hỗ trợ 40 luồng đồng thời trên một GPU, có thể hiểu cảm xúc của khách hàng và gọi công cụ nhiều bước để xử lý nghiệp vụ, phù hợp với các trung tâm cuộc gọi quy mô lớn.
Đồng hành AI và nhân vật ảo: phiên bản Tag có khả năng thể hiện ngữ điệu mạnh nhất, biết cười và thở dài, phù hợp để xây dựng trợ lý đồng hành cảm xúc, người yêu ảo và NPC trong game.
Trợ lý giọng nói trên xe: song công toàn phần cho phép ngắt lời bất cứ lúc nào và phản hồi độ trễ thấp, không cần từ đánh thức; khả năng hiểu ngữ điệu còn hỗ trợ phán đoán trạng thái của người lái.
Thiết bị đầu cuối phần cứng AI: công nghệ của đội ngũ đã được triển khai trên hơn 300 sản phẩm phần cứng; giấy phép Apache-2.0 cho phép sử dụng thương mại, phù hợp để tích hợp vào loa, đồ chơi, robot và các thiết bị khác.
Tác nhân giọng nói doanh nghiệp: chế độ Live tương thích với giao thức GPT-Live; Sophon phụ trách “nghe và nói”, còn việc tra cứu và xử lý nghiệp vụ được giao cho mô hình lớn backend, phù hợp để tùy chỉnh dịch vụ cho ngân hàng, chính quyền, hàng không và các ngành khác.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0