
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-17
01Spark-Audio-1.0-Preview là gì
Spark-Audio-1.0-Preview là mô hình ngôn ngữ nền tảng giọng nói hoàn toàn nội địa do iFlytek phát triển, sử dụng kiến trúc bộ mã hóa âm thanh 0.65B kết hợp với mô hình ngôn ngữ MoE 30B-A3B, được huấn luyện bằng năng lực tính toán nội địa hoàn toàn trên 13 triệu giờ âm thanh và lượng lớn dữ liệu văn bản. Mô hình có thể trực tiếp hiểu ngữ nghĩa, cảm xúc và bối cảnh trong giọng nói, hỗ trợ nhận dạng 99 ngôn ngữ, 202 phương ngữ cùng các tác vụ như chuyển giọng nói thành văn bản, dịch thuật, nhận dạng người nói, phân tích cảm xúc và hỏi đáp âm thanh. Mô hình thể hiện hiệu năng vượt trội trong các bối cảnh phức tạp như nhiều tiếng ồn hoặc âm lượng nhỏ, đồng thời có thể được ứng dụng rộng rãi trong chăm sóc khách hàng, xe hơi, y tế và nhiều lĩnh vực khác.
02Các chức năng chính của Spark-Audio-1.0-Preview
Chuyển giọng nói thành văn bản: Chuyển trực tiếp giọng nói thành văn bản, hỗ trợ nhận dạng 99 ngôn ngữ và 202 phương ngữ.
Dịch đa ngôn ngữ: Thực hiện dịch liên ngôn ngữ từ giọng nói sang giọng nói hoặc văn bản, đồng thời giữ lại các thông tin ngữ điệu như giọng điệu và cao độ.
Nhận dạng đa phương ngữ: Bao phủ 202 phương ngữ, có thể hiểu cả tiếng Quảng Đông, tiếng Ôn Châu và nhiều phương ngữ khác.
Nhận dạng âm thanh môi trường: Có thể đồng thời hiểu giọng người và âm thanh nền môi trường, từ đó nắm bắt bối cảnh nơi âm thanh phát sinh.
Nhận dạng người nói: Tự động phân biệt ai đang nói, phù hợp cho chuyển biên cuộc họp, tạo biên bản và các tác vụ khác.
Phân tích cảm xúc: Nắm bắt giọng điệu và cảm xúc trong lời nói, giúp tương tác trở nên “có chiều sâu” hơn.
Hỏi đáp âm thanh: Hiểu và trả lời câu hỏi dựa trên nội dung âm thanh phức tạp, chuyển từ “nghe rõ” sang “hiểu được”.
03Nguyên lý kỹ thuật của Spark-Audio-1.0-Preview
Kiến trúc hiểu giọng nói đầu cuối: Khác với giải pháp tuần tự truyền thống “chuyển thành văn bản trước rồi đưa cho mô hình lớn”, mô hình sử dụng bộ mã hóa âm thanh 0.65B kết hợp với mô hình ngôn ngữ lớn 30B-A3B. Văn bản và giọng nói được đưa trực tiếp vào cùng một mô hình dưới dạng hai phương thức, cho phép hiểu đồng thời giọng người, âm thanh môi trường, âm nhạc cùng ngữ nghĩa, cảm xúc và bối cảnh của chúng, qua đó tránh mất mát thông tin và tích lũy lỗi trong chuỗi xử lý tuần tự.
Tiền huấn luyện bộ mã hóa âm thanh: Thông qua tiền huấn luyện bộ mã hóa âm thanh, năng lực biểu diễn của mô hình được mở rộng từng bước; sau đó tiền huấn luyện và hậu huấn luyện được sử dụng để nâng cao năng lực nền tảng, khả năng khái quát trong bối cảnh phức tạp và hiệu quả đa nhiệm. Cuối cùng, mô hình đạt kết quả xuất sắc trong các bối cảnh phức tạp thực tế như nhiều tiếng ồn hoặc âm lượng nhỏ.
Huấn luyện bằng năng lực tính toán nội địa hoàn toàn: Mô hình được huấn luyện trên cụm tính toán nội địa hoàn toàn với 13 triệu giờ âm thanh và lượng lớn dữ liệu văn bản. Đây là mô hình ngôn ngữ nền tảng giọng nói đầu tiên trong ngành được huấn luyện bằng năng lực tính toán nội địa hoàn toàn, chứng minh rằng năng lực tính toán nội địa có thể huấn luyện ra mô hình giọng nói đạt trình độ hàng đầu trong ngành.
Hệ thống nền tảng có thể tinh chỉnh: Tương tự hệ thống 1+N của mô hình lớn iFlytek Spark, Spark-Audio có thể được tinh chỉnh thêm để phát triển các mô hình hoặc hệ thống chuyên dụng như nhận dạng giọng nói, phiên dịch đồng thời bằng giọng nói và tương tác bằng giọng nói, thuận tiện triển khai trong nhiều nghiệp vụ liên quan đến giọng nói.
04Cách sử dụng Spark-Audio-1.0-Preview
Mở trang trải nghiệm chính thức: Truy cập địa chỉ trải nghiệm mô hình https://iflytekresearch.iflytek.com/experience/spark-audio .
Trải nghiệm năng lực của mô hình trực tuyến: Nhập văn bản hoặc giọng nói trên trang để trải nghiệm các chức năng chuyển giọng nói thành văn bản, dịch thuật, nhận dạng phương ngữ, hỏi đáp âm thanh và nhiều chức năng khác.
05Ưu thế cốt lõi của Spark-Audio-1.0-Preview
Huấn luyện bằng năng lực tính toán nội địa hoàn toàn: Mô hình ngôn ngữ nền tảng giọng nói đầu tiên trong ngành được huấn luyện trên cụm tính toán nội địa hoàn toàn, chứng minh năng lực tính toán nội địa có thể tạo ra mô hình đạt trình độ hàng đầu trong ngành.
Hiểu giọng nói trực tiếp theo mô hình đầu cuối: Thoát khỏi giải pháp tuần tự “chuyển thành văn bản trước rồi mới hiểu”, không làm mất các thông tin quan trọng như giọng điệu, cảm xúc và âm thanh môi trường, đồng thời loại bỏ sự phân mảnh và độ trễ trong chuỗi xử lý.
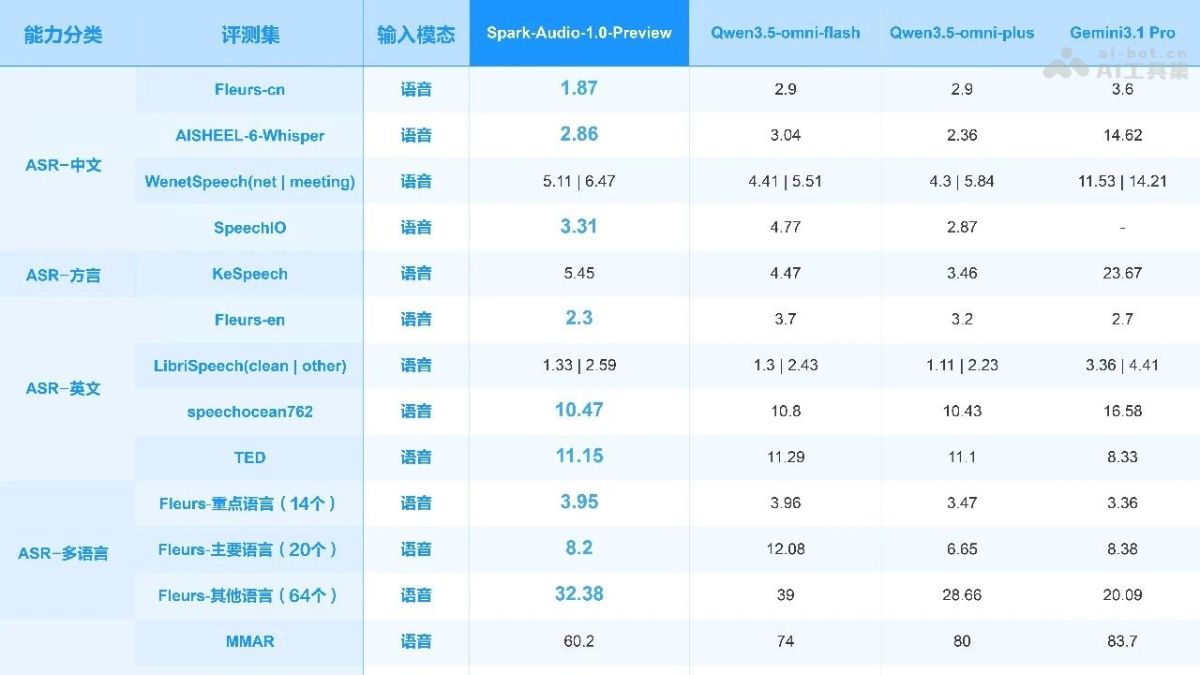
Phủ rộng nhiều ngôn ngữ và phương ngữ: Hỗ trợ nhận dạng 99 ngôn ngữ và 202 phương ngữ, đạt ưu thế về hiệu quả nhận dạng đa ngôn ngữ và đa phương ngữ khi so sánh với các mô hình cùng kích thước.
Hiệu năng vượt trội trong bối cảnh phức tạp: Có ưu thế rõ rệt trong các tác vụ ứng dụng thực tế như nhiều tiếng ồn và âm lượng nhỏ, với khả năng khử nhiễu nổi bật.
Không thua kém các mô hình lớn hơn: Hiệu quả gần với Qwen3.5-omni-plus có kích thước lớn hơn một bậc, đạt SOTA trên tập kiểm thử tiếng Trung Fleurs và vượt Gemini-3.1 Pro trong nhiều bài đánh giá.
Năng lực văn bản không suy giảm: Không xuất hiện hiện tượng suy giảm rõ rệt trong các tác vụ văn bản như kiến thức tổng quát, toán học và lập trình, khắc phục khó khăn thường gặp của mô hình nền tảng giọng nói.
Kiến trúc hiệu quả: Sử dụng bộ mã hóa âm thanh 0.65B + kiến trúc MoE 30B-A3B, đạt hiệu năng gần với các mô hình đóng lớn hơn nhưng ở kích thước nhỏ.
06Các kịch bản ứng dụng của Spark-Audio-1.0-Preview
Chăm sóc khách hàng thông minh: Nhận dạng cảm xúc và cách diễn đạt của người dùng, giúp cuộc trò chuyện liền mạch và gần gũi hơn, nâng cao trải nghiệm dịch vụ.
Khoang lái ô tô: Nhận dạng chính xác chỉ lệnh của người lái trong môi trường ồn ào trên xe, hỗ trợ tương tác bằng phương ngữ và tạo trải nghiệm tương tác giọng nói tự nhiên hơn trong xe.
Dịch thời gian thực và họp đa ngôn ngữ: Thực hiện phiên dịch đồng thời bằng giọng nói và dịch đa ngôn ngữ, đồng thời giữ lại các thông tin ngữ điệu như giọng điệu và cao độ, mang đến trải nghiệm giao tiếp liên ngôn ngữ tự nhiên hơn.
Chuyển biên cuộc họp và tạo biên bản: Tự động phân biệt người nói, trích xuất các quyết định quan trọng và tạo biên bản có cấu trúc, giúp nhân viên giảm công việc整理 thủ công lặp lại.
Bệnh án điện tử và kiểm duyệt nội dung y tế: Hoàn thành ghi chép bệnh án và kiểm duyệt nội dung bằng giọng nói, giảm gánh nặng nhập liệu thủ công và nâng cao hiệu suất trong các lĩnh vực chuyên môn như y tế.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0