
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-21
01Laya là gì
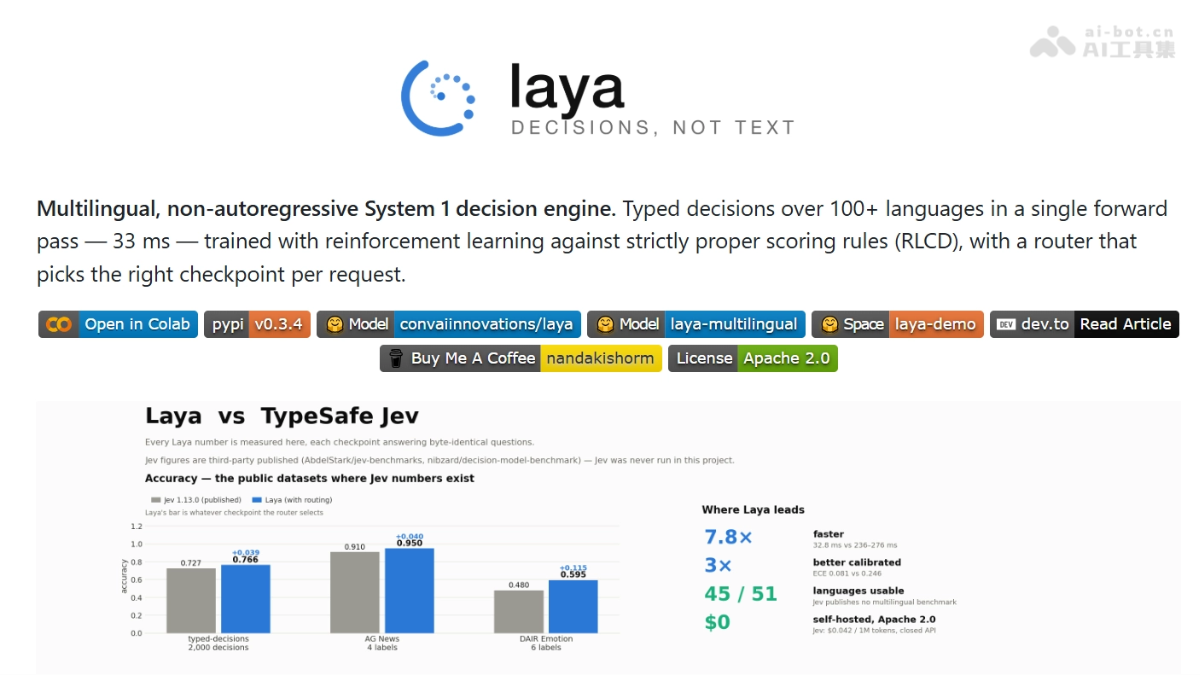
Laya là mô hình ra quyết định AI phi tự hồi quy mã nguồn mở. Mô hình không tạo văn bản, sử dụng bộ mã hóa hai chiều ModernBERT/mmBERT, chỉ thực hiện một lượt truyền xuôi trên một đoạn văn bản kèm câu hỏi có kiểu dữ liệu, xuất kết quả có cấu trúc và xác suất đã hiệu chuẩn trong khoảng 33ms. Mô hình tích hợp bộ định tuyến ngôn ngữ, hỗ trợ hơn 100 ngôn ngữ. So với mô hình độc quyền Jev, Laya có lợi thế hơn về độ chính xác (76.6% so với 72.7%), hỗ trợ đa ngôn ngữ (hơn 100 ngôn ngữ) và chi phí (miễn phí khi triển khai cục bộ).
02Các tính năng chính của Laya
Ra quyết định với một lượt truyền xuôi: nhập một trạng thái cùng nhóm câu hỏi có kiểu dữ liệu, mô hình trả về kết quả có cấu trúc trực tiếp sau một lượt truyền xuôi, không tạo văn bản, trong khoảng 33ms.
Ba nguyên mẫu quyết định: choice chọn một mục từ các ứng viên và đưa ra xác suất của từng mục; score chấm điểm trên thang đo có thứ tự và đưa ra phân phối; noul trả lời câu hỏi đúng/sai và trả về xác suất đúng từ 0–1.
Tự động định tuyến ngôn ngữ: Router phát hiện hệ chữ viết và ngôn ngữ đầu vào trong <0.5ms, tự động phân phối đến checkpoint tiếng Anh hoặc đa ngôn ngữ, tránh chọn sai mô hình dẫn đến “tự tin trả lời sai”.
Cổng kiểm soát độ tin cậy: xác suất được huấn luyện bằng RLCD nên có ý nghĩa thống kê; có thể tự động cho phép các quyết định có độ tin cậy cao theo ngưỡng, còn quyết định có độ tin cậy thấp sẽ được chuyển cho con người.
Cài sẵn các quy trình làm việc: cung cấp những mẫu câu hỏi dựng sẵn cho định tuyến mô hình, bảo vệ chống chèn prompt, kiểm duyệt an toàn nội dung, phân loại yêu cầu hỗ trợ và nhiều tác vụ khác, có thể sử dụng ngay.
Tinh chỉnh cục bộ: đi kèm notebook Kaggle, hỗ trợ toàn bộ quy trình tinh chỉnh bằng dữ liệu riêng, gồm tạo dữ liệu, huấn luyện RLCD, hiệu chỉnh nhiệt độ và đánh giá.
03Nguyên lý kỹ thuật của Laya
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Kiến trúc hai chiều phi tự hồi quy: dựa trên bộ mã hóa hai chiều ModernBERT-large (421M) hoặc mmBERT-base (322M), các token đầu vào đồng thời nhìn thấy ngữ cảnh phía trước và phía sau. Khi suy luận, mô hình không tạo văn bản từng ký tự mà phân bổ một vị trí [MASK] độc lập cho mỗi lựa chọn ứng viên, xuất logits của tất cả lựa chọn trong một lượt truyền xuôi, sau đó chuẩn hóa bằng Softmax thành phân phối xác suất. Đây là nguồn gốc của độ trễ ở mức 33ms.
Huấn luyện tăng cường RLCD: sử dụng các quy tắc chấm điểm chân thực nghiêm ngặt như điểm logarit, điểm cầu và điểm xác suất thứ hạng làm phần thưởng. Mô hình chỉ đạt điểm cao khi xuất xác suất hậu nghiệm thực tế; khi không chắc chắn, độ tin cậy sẽ tự nhiên giảm, tránh vấn đề “tự tin mù quáng” của các mô hình ngôn ngữ lớn truyền thống.
Cơ chế định tuyến ngôn ngữ: trước forward, Router dùng Python thuần để phát hiện bộ ký tự Unicode và ngôn ngữ, từ đó chọn checkpoint. Vì checkpoint tiếng Anh có thể đưa ra câu trả lời với độ tin cậy 0.95 nhưng độ chính xác bằng 0 trên văn bản không phải chữ Latinh, bản thân độ tin cậy không thể cảnh báo trước; do đó quyết định định tuyến phải được hoàn tất trước khi suy luận.
Hiệu chuẩn xác suất: checkpoint xuất xưởng thường quá tự tin, cần hiệu chỉnh nhiệt độ trên dữ liệu riêng theo (loại câu hỏi, số lượng lựa chọn). Sau khi hiệu chỉnh, ECE trung bình có thể giảm từ 0.466 xuống 0.081; khi đó xác suất mới có thể được dùng trực tiếp cho quyết định tự động cho phép.
04Cách sử dụng Laya
Cài đặt: pip install laya, gói PyPI; trong vòng hai ngày đã nâng cấp từ 0.1.0 lên 0.3.4, lưu ý giao diện vẫn đang thay đổi.
Tải mô hình: Router(preload=True) tải trước ba checkpoint, tránh phải khởi tạo lại mô hình mỗi lần đổi ngôn ngữ khi khởi động lạnh.
Chuẩn bị trạng thái: tập hợp văn bản cần phân tích thành dict, chẳng hạn {"from": ..., "subject": ..., "body": ...}; hỗ trợ mọi ngôn ngữ hoặc cấu trúc JSON.
Định nghĩa câu hỏi: dùng JSON để viết một nhóm câu hỏi có kiểu dữ liệu, chỉ định type (choice / score / noul), instructions và criteria (các lựa chọn hoặc thang đo).
Thực hiện dự đoán: gọi router.predict(state, questions); một lượt truyền xuôi sẽ trả về tất cả câu trả lời. Tiếng Anh dùng laya, còn Hindi và các ngôn ngữ khác tự động dùng multilingual.
Đọc kết quả: lấy nhãn choice, điểm score hoặc xác suất noul từ res["answers"]; res["routing"] giải thích lý do checkpoint được chọn.
Kiểm soát độ tin cậy: đặt ngưỡng cho confidence, chẳng hạn 0.85; tự động xử lý các trường hợp có độ tin cậy cao và chuyển các trường hợp có độ tin cậy thấp cho con người, với điều kiện trước đó đã hiệu chỉnh nhiệt độ trên dữ liệu riêng.
05Ưu điểm cốt lõi của Laya
Suy luận cực nhanh: một lượt truyền xuôi mất khoảng 33ms (T4), xử lý theo lô thấp tới 7.2ms/câu, nhanh hơn khoảng 7.8 lần so với Jev TypeSafe độc quyền.
Không có rủi ro ảo giác: không tạo văn bản, chỉ xuất quyết định có cấu trúc, không cần phân tích cú pháp và không có vấn đề bịa đặt nội dung.
Xác suất có thể hiệu chuẩn: được huấn luyện bằng các quy tắc chấm điểm chân thực nghiêm ngặt của RLCD, độ tin cậy có ý nghĩa thống kê và có thể trực tiếp điều khiển quy trình tự động cho phép hoặc kiểm tra thủ công.
Độ chính xác sau hiệu chuẩn dẫn đầu: sau khi hiệu chỉnh nhiệt độ, ECE chỉ còn 0.081, tốt hơn mức 0.246 của Jev; độ chính xác typed-decisions đạt 0.766, cũng cao hơn mức 0.727 của Jev.
Định tuyến đa ngôn ngữ: Router tích hợp nhận diện hơn 100 ngôn ngữ ở mức dưới một mili giây và tự động chọn checkpoint, tránh việc mô hình tiếng Anh “tự tin trả lời sai” trên văn bản không phải chữ Latinh.
Mã nguồn mở hoàn toàn, không tốn chi phí: giấy phép Apache-2.0, mở trọng số và có thể tự lưu trữ. So với chi phí API $0.042/triệu token của Jev, chi phí sử dụng lâu dài bằng không.
Đầu ra có kiểu dữ liệu: ba nguyên mẫu choice / score / noul bao phủ phần lớn các tình huống ra quyết định có cấu trúc như phân loại, chấm điểm và phán đoán đúng/sai.
06Địa chỉ dự án Laya
Kho GitHub: https://github.com/NandhaKishorM/laya
Kho mô hình HuggingFace: https://huggingface.co/convaiinnovations/laya
07Các trường hợp sử dụng Laya
Tự động phân loại yêu cầu hỗ trợ khách hàng: xác định bộ phận phụ trách (billing/technical/sales), mức độ khẩn cấp, sự thất vọng của người dùng và nguy cơ rời bỏ; tự động phân công khi độ tin cậy cao và chuyển cho con người khi độ tin cậy thấp.
An toàn và kiểm duyệt nội dung: phát hiện nội dung độc hại, quấy rối và đe dọa; nguyên mẫu noul xuất xác suất vi phạm, phù hợp để kiểm duyệt theo thời gian thực trên cộng đồng và nền tảng UGC.
Bảo vệ chống chèn prompt (Guardrails): phát hiện tấn công vượt rào, chèn prompt, rò rỉ khóa và các tấn công khác tại điểm vào của hệ thống Agent; độ trễ ở mức 33ms cho phép tích hợp vào mọi chuỗi yêu cầu.
Định tuyến mô hình thông minh: trong kiến trúc kết hợp nhiều mô hình ngôn ngữ lớn, xác định yêu cầu nên được xử lý bởi mô hình nhỏ hay mô hình tiên tiến, hoàn tất quyết định điều phối với chi phí cực thấp và tiết kiệm chi phí suy luận.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0