
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-10-08
01Startlux-Decision là gì
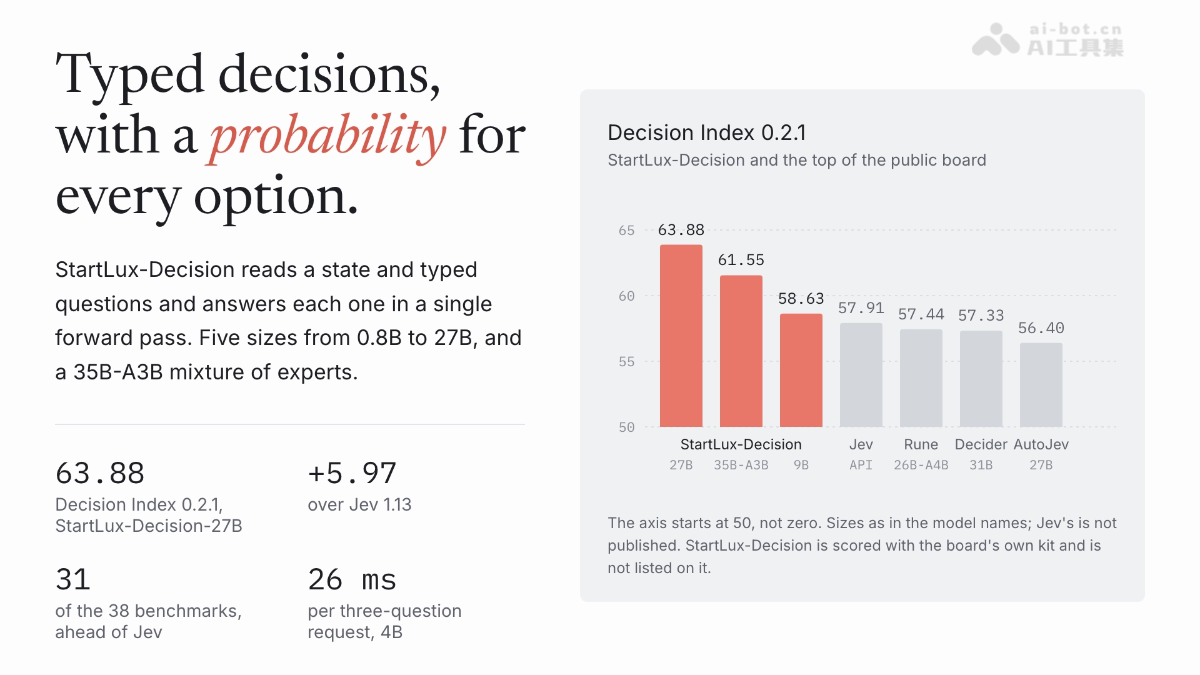
StartLux-Decision là dòng mô hình ra quyết định do StartLux Labs phát triển, gồm năm mô hình dense từ 0.8B đến 27B và một mô hình Mixture-of-Experts 35B-A3B. StartLux-Decision tiếp nhận trạng thái dưới dạng văn bản, JSON hoặc hình ảnh; đối với các câu hỏi dạng lựa chọn, đúng/sai và chấm điểm, mô hình chỉ cần một lần suy luận forward để trả về xác suất của từng phương án, có thể dùng làm độ tin cậy. Mô hình hỗ trợ nguyên bản ngữ cảnh dài 256K token, độ trễ ở mức mili giây và tương thích với định dạng client TypeSafe của Jev.
02Các tính năng chính của Startlux-Decision
Ra quyết định có kiểu: hỗ trợ ba dạng câu hỏi gồm trắc nghiệm, đúng/sai và chấm điểm; mỗi câu hỏi trả về phân phối xác suất của từng phương án.
Đầu vào đa phương thức: trạng thái có thể là văn bản, JSON hoặc hình ảnh (cập nhật 2026-10-03); bằng chứng và hình ảnh có thể được đưa vào một phần của yêu cầu.
Ngữ cảnh siêu dài: tất cả kích thước mô hình đều hỗ trợ nguyên bản độ dài prompt 262,144 token (256K), đọc trạng thái dài theo từng khối một lần.
Đầu ra độ tin cậy: xác suất được dùng trực tiếp làm độ tin cậy, phù hợp với các quy trình tự động hóa cần định lượng rủi ro.
Thông lượng cao, độ trễ thấp: câu hỏi ngắn chỉ mất vài mili giây cho một lần forward, hỗ trợ suy luận theo lô (batched path) và tăng tốc bằng CUDA Graphs.
Triển khai đa nền tảng: cung cấp bản lượng tử hóa GGUF (BF16/Q8_0/Q4_K_M) cho llama.cpp, đồng thời hỗ trợ backend MLX trên Apple Silicon.
Ứng dụng game và tác tử: đã được kiểm chứng trong các tình huống ra quyết định theo thời gian thực như mua sắm trên web, cờ vua, Super Mario, StarCraft II và Doom.
Tương thích hệ sinh thái Jev: yêu cầu và phản hồi sử dụng định dạng TypeSafe /v1/systemone, các client được viết cho Jev có thể tích hợp liền mạch.
03Nguyên lý kỹ thuật của Startlux-Decision
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án mã nguồn mở AI
Đọc đáp án bằng một lần forward: mô hình chuyển các phương án thành các ký hiệu chữ cái, sau đó đọc trực tiếp xác suất tại vị trí chữ cái của phương án từ forward pass. Tất cả câu hỏi trong một yêu cầu được xử lý song song trong một lần forward.
Kiến trúc attention tuyến tính: sử dụng các kernel nhanh flash-linear-attention và causal-conv1d. Yêu cầu ngắn có độ trễ cực thấp; máy chủ sẽ từ chối khởi động trên GPU không có các kernel này để bảo đảm hiệu năng.
Nhân ma trận theo nhóm cho MoE: mô hình Mixture-of-Experts 35B-A3B chỉ kích hoạt khoảng 3B tham số cho mỗi token. Các expert chạy bằng grouped matmul và được CUDA Graphs bao phủ, cho độ trễ khoảng một nửa so với mô hình dense 27B.
Phân khối và phân nhánh đầu vào dài: trạng thái dài 256K được đọc theo từng khối một lần; mỗi câu hỏi trong yêu cầu được tính toán từ nhánh biểu diễn tương ứng, tránh mã hóa lặp lại.
Lượng tử hóa bảo toàn xác suất: BF16 và Q8_0 trong GGUF cho kết quả quyết định hoàn toàn giống trọng số gốc trên 99–100% hạng mục JevBench, cho thấy năng lực ra quyết định có khả năng chống chịu cao trước lượng tử hóa.
04Cách sử dụng Startlux-Decision
Tải trọng số: tải xuống từ Hugging Face bằng lệnh hf download startlux-models/StartLux-Decision-4B --local-dir StartLux-Decision-4B.
Cài đặt dependency: vào thư mục mô hình và chạy pip install -r requirements.txt.
Kiểm tra kernel: chạy python -m startlux_decision.check StartLux-Decision-4B, kết quả bắt buộc phải có “fast kernels: active”.
Khởi động dịch vụ: chạy python -m startlux_decision.server --model StartLux-Decision-4B --port 8090 để khởi động dịch vụ suy luận cục bộ.
Gửi yêu cầu: gửi JSON đến localhost:8090/v1/systemone, trong đó có state và questions với các loại choice / noul / score.
Nhận kết quả: phản hồi trả về phân phối xác suất của từng phương án trong mỗi câu hỏi, có thể dùng trực tiếp làm độ tin cậy quyết định.
Cách dùng GGUF (tùy chọn): tải kho GGUF tương ứng, sau đó khởi động llama-server trước rồi chạy python -m startlux_decision.gguf_server để cung cấp dịch vụ quyết định phía trước llama.cpp.
05Ưu điểm cốt lõi của Startlux-Decision
Ra quyết định dựa trên xác suất: mỗi câu hỏi trả về trực tiếp xác suất của từng phương án, có thể sử dụng độ tin cậy tự nhiên mà không cần hiệu chỉnh bổ sung.
Độ trễ cực thấp: chỉ cần một lần forward để đưa ra đáp án; mô hình 4B chỉ mất 26ms, còn 35B-A3B chỉ mất 52.5ms.
Dẫn đầu toàn diện trên benchmark: đạt 63.88 trên Decision Index 0.2.1, vượt Jev 1.13 và tất cả đối thủ công khai khác.
Ngữ cảnh siêu dài: toàn bộ dòng mô hình hỗ trợ nguyên bản đầu vào 256K token, chỉ cần đọc tài liệu dài một lần.
Bằng chứng đa phương thức: mọi kích thước mô hình đều có thể đọc hình ảnh làm căn cứ ra quyết định.
Vượt trội ở mọi phân khúc: từ 0.8B đến 35B, mỗi cấp độ đều tốt hơn các mô hình cạnh tranh có quy mô tương đương.
Tương thích hệ sinh thái Jev: sử dụng định dạng TypeSafe /v1/systemone, các client được viết cho Jev có thể tích hợp mà không cần chỉnh sửa.
06Địa chỉ dự án Startlux-Decision
Kho GitHub: https://github.com/StartLuxLabs/Startlux-Decision
Kho mô hình HuggingFace: https://huggingface.co/collections/startlux-models/startlux-decision-6abba92b301b573fa154d493
07Các kịch bản ứng dụng của Startlux-Decision
Phân loại yêu cầu chăm sóc khách hàng thông minh: nhập văn bản hoặc hình ảnh của phiếu yêu cầu, xác định trong một lần yêu cầu đội xử lý, mức độ khẩn cấp và mức độ nghiêm trọng; xác suất của các phương án chính là độ tin cậy.
Tự động hóa thao tác máy tính: điều khiển trình duyệt thực để lần lượt chọn các thành phần giao diện và xác định nhiệm vụ đã hoàn tất hay chưa; đã trình diễn khả năng tự động hoàn tất việc đặt hàng trên web.
AI ra quyết định trong game: xuất xác suất của các hành động như di chuyển, xây dựng và bắn trong một lần forward; đã được kiểm chứng với cờ vua, StarCraft II, Doom và các game khác.
Quản trị rủi ro tài chính và tuân thủ: bao phủ việc kiểm tra điều khoản hợp đồng, nhận diện thực thể tài chính và phát hiện email lừa đảo; độ tin cậy có thể được dùng trực tiếp trong quy trình quản trị rủi ro.
Truy xuất và phân loại trong doanh nghiệp: hoàn tất nhận diện ý định, phân loại truy vấn và kiểm chứng sự thật RAG ở độ trễ mili giây, phù hợp với các kịch bản nghiệp vụ có tính đồng thời cao.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0