
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-08
01LLaDA-Image là gì
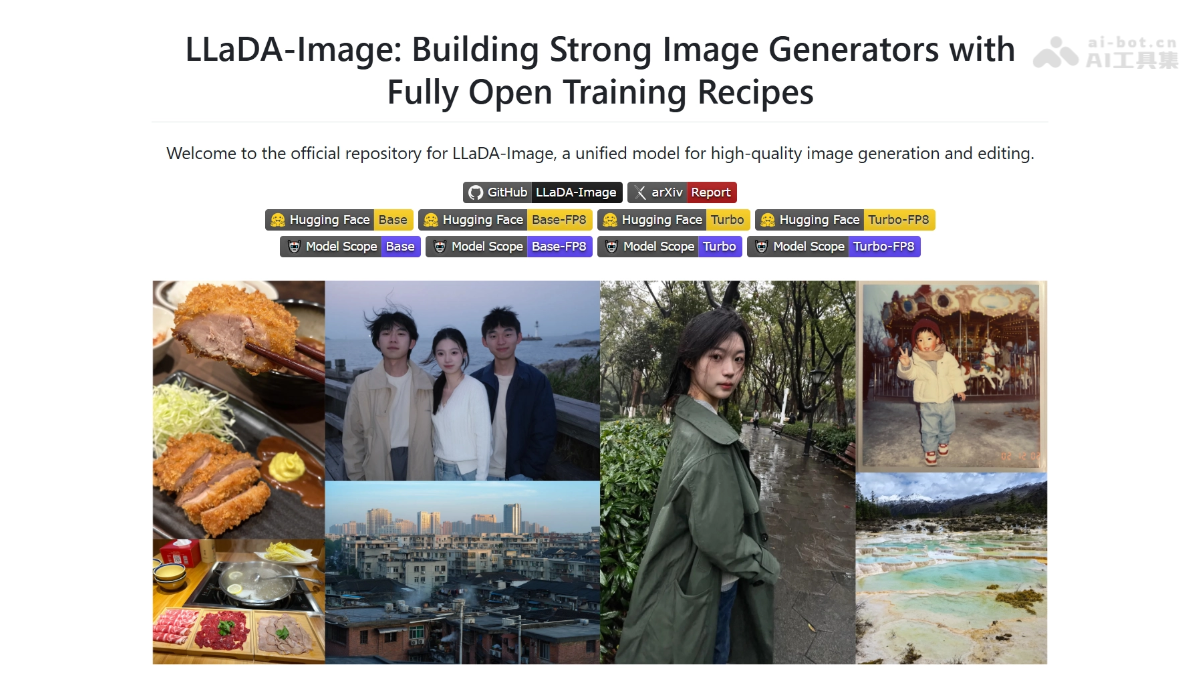
LLaDA-Image là mô hình thống nhất tạo và chỉnh sửa hình ảnh 6B tham số do inclusionAI thuộc Tập đoàn Ant phát hành mã nguồn mở. Mô hình áp dụng lộ trình đổi mới: tiền huấn luyện thuần hình ảnh trước, sau đó căn chỉnh ngôn ngữ; sử dụng kiến trúc khuếch tán toàn phần (LLaDA2.0-mini để hiểu + DiT 6B để tạo ảnh) nhằm hỗ trợ tạo ảnh từ văn bản, chỉnh sửa theo chỉ dẫn và kết xuất văn bản tiếng Trung, tiếng Anh. Phiên bản Turbo chỉ cần 2–4 bước để tạo ảnh, đứng đầu trong các mô hình mã nguồn mở ở cả hai hạng mục tiếng Trung và tiếng Anh của Qwen-Image-Bench.
02Các tính năng chính của LLaDA-Image
Tạo ảnh từ văn bản: Tạo hình ảnh chất lượng cao, giàu chi tiết và chân thực như ảnh chụp dựa trên mô tả bằng ngôn ngữ tự nhiên.
Chỉnh sửa hình ảnh theo chỉ dẫn: Tải lên ảnh tham chiếu và nhập chỉ dẫn bằng ngôn ngữ tự nhiên để chỉnh sửa chính xác khu vực được chỉ định, đồng thời giữ nguyên các phần còn lại.
Kết xuất văn bản song ngữ Trung-Anh: Hiển thị chính xác văn bản tiếng Trung và tiếng Anh trong ảnh được tạo, hỗ trợ thiết kế áp phích, bố cục và chữ nghệ thuật.
Tạo ảnh có điều kiện VQ: Sử dụng token lượng tử hóa thị giác (VQ) làm đầu vào điều kiện để tạo ảnh có kiểm soát.
Chỉnh sửa bằng ảnh tham chiếu: Sử dụng ảnh đã tải lên làm tham chiếu để thực hiện các thao tác như chuyển phong cách và chỉnh sửa nội dung.
Suy luận nhanh Turbo: Mô hình chưng cất chỉ cần lấy mẫu 2–4 bước để tạo ảnh chất lượng cao 1024×1024.
03Nguyên lý kỹ thuật của LLaDA-Image
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Kiến trúc thống nhất khuếch tán toàn phần: Mô hình gồm mô-đun hiểu LLaDA2.0-mini (mô hình ngôn ngữ khuếch tán dựa trên MoE) và mô-đun tạo ảnh DiT 6B. Cả hai đều sử dụng mô hình khuếch tán ở phía sau, được kết nối qua Connector, giúp tách rời việc hiểu ngữ nghĩa và tạo pixel.
Chiến lược huấn luyện theo giai đoạn: Áp dụng lộ trình “học vẽ trước, học nghe lời sau”, trước tiên thực hiện tiền huấn luyện hình ảnh thuần túy và huấn luyện giữa kỳ để xây dựng prior mạnh cho việc tạo ảnh, sau đó đưa vào giám sát ngôn ngữ theo cặp để hoàn tất căn chỉnh văn bản-hình ảnh.
Xây dựng dữ liệu chất lượng cao: Quá trình huấn luyện tạo ảnh sử dụng tổng cộng khoảng 2.2 tỷ mẫu, trong đó 98% là hình ảnh thực; mô tả hình ảnh-văn bản trong giai đoạn căn chỉnh ngôn ngữ do các mô hình lớn dòng Qwen tạo và kiểm tra, bảo đảm độ chính xác khi làm theo chỉ dẫn.
Tối ưu huấn luyện hiệu quả: Toàn bộ quy trình sử dụng RMSNorm không phụ thuộc tham số thay cho LayerNorm, đồng thời áp dụng bộ tối ưu Muon để nâng cao tính ổn định và hiệu quả của huấn luyện quy mô lớn.
Chưng cất nhanh Twin-DMD: Phiên bản Turbo nén mô hình Base thông qua kỹ thuật chưng cất Twin-DMD; chỉ với 2–4 bước lấy mẫu có thể tạo ảnh chất lượng cao 1024×1024, cân bằng tốc độ và chất lượng.
04Cách sử dụng LLaDA-Image
Cấu hình môi trường: Cài đặt Python 3.11, PyTorch 2.8, Diffusers 0.39.0, FlashAttention 2.8.3 và các phụ thuộc khác để thiết lập môi trường suy luận cục bộ.
Lấy trọng số: Tải tệp mô hình LLaDA-Image (bản chất lượng cao) hoặc LLaDA-Image-Turbo (bản nhanh) từ Hugging Face hoặc ModelScope.
Tạo ảnh từ văn bản: Sau khi tải mô hình, nhập văn bản mô tả; đặt bản Base ở 50 bước, guidance scale 5.0; bản Turbo ở 2–4 bước, guidance scale 1.0 để tạo ảnh 1024×1024.
Chỉnh sửa ảnh theo chỉ dẫn: Tải lên ảnh tham chiếu và nhập chỉ dẫn chỉnh sửa bằng ngôn ngữ tự nhiên (ví dụ “đổi nền thành bờ biển”), mô hình sẽ tự động giữ nguyên các khu vực không chỉnh sửa.
Lưu ý về kích thước: Kích thước đầu vào của tạo ảnh từ văn bản và tạo ảnh có điều kiện VQ phải là bội số của 16; tác vụ chỉnh sửa phải là bội số của 32.
05Ưu điểm cốt lõi của LLaDA-Image
Hiệu năng hàng đầu trong nhóm mã nguồn mở: Đứng đầu trong các mô hình mã nguồn mở ở cả hai hạng mục tiếng Trung và tiếng Anh của Qwen-Image-Bench, với điểm tổng thể vượt qua các mô hình mã nguồn mở phổ biến như FLUX.2 Max.
Thống nhất tạo và chỉnh sửa: Một mô hình duy nhất hỗ trợ đồng thời tạo ảnh từ văn bản chất lượng cao và chỉnh sửa hình ảnh tinh vi theo chỉ dẫn, không cần chuyển đổi giữa các mô hình khác nhau.
Suy luận siêu nhanh: Bản Turbo chưng cất chỉ cần lấy mẫu 2–4 bước để tạo ảnh chất lượng cao 1024×1024, rút ngắn đáng kể thời gian chờ.
Kết xuất văn bản Trung-Anh: Có khả năng tạo văn bản tiếng Trung và tiếng Anh xuất sắc, phù hợp với các tác vụ thiết kế như áp phích, bố cục và chữ nghệ thuật.
Tính chân thực như ảnh chụp: Dựa trên dữ liệu tiền huấn luyện gồm 98% hình ảnh thực, kết quả tạo ra có ánh sáng tự nhiên, nhiều chi tiết và độ chân thực cao.
06Địa chỉ dự án LLaDA-Image
Kho GitHub: https://github.com/inclusionAI/LLaDA-Image
Kho mô hình HuggingFace: https://huggingface.co/collections/inclusionAI/llada-image
Bài báo kỹ thuật arXiv: https://arxiv.org/pdf/2609.03796
07Các trường hợp sử dụng LLaDA-Image
Thiết kế hình ảnh thương mại điện tử: Tạo ảnh chính cho sản phẩm chỉ bằng một lần dựa trên mô tả sản phẩm, hoặc nhanh chóng thay đổi nền và điều chỉnh ánh sáng bằng chỉ dẫn, giảm chi phí chụp ảnh và hậu kỳ.
Sản xuất áp phích tiếp thị: Sử dụng khả năng kết xuất văn bản Trung-Anh nổi bật để trực tiếp tạo áp phích thương mại và hình ảnh mạng xã hội có Slogan thương hiệu, thông tin sự kiện.
Sáng tạo nội dung mạng xã hội: Cung cấp cho blogger và nhà sáng tạo khả năng tạo hình ảnh chân dung, phong cảnh và phong cách sống chân thực như ảnh chụp, đồng thời hỗ trợ chỉnh sửa theo phong cách và tạo ảnh nhanh.
Thiết kế ý tưởng trò chơi và phim ảnh: Nhanh chóng tạo hình ảnh ý tưởng nhân vật và bối cảnh dựa trên văn bản, sau đó dùng chỉ dẫn để lặp lại việc chỉnh sửa chi tiết, đẩy nhanh quy trình sáng tạo ban đầu.
Chỉnh sửa ảnh cá nhân: Sau khi tải ảnh lên, dùng chỉ dẫn bằng ngôn ngữ tự nhiên để xóa vật thể thừa, thay bầu trời, điều chỉnh màu sắc và thực hiện các thao tác khác; giữ nguyên vùng chưa chỉnh sửa, thay thế phần mềm chỉnh ảnh phức tạp.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0