
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-10-30
01Nemotron 3.5 Transcribe là gì
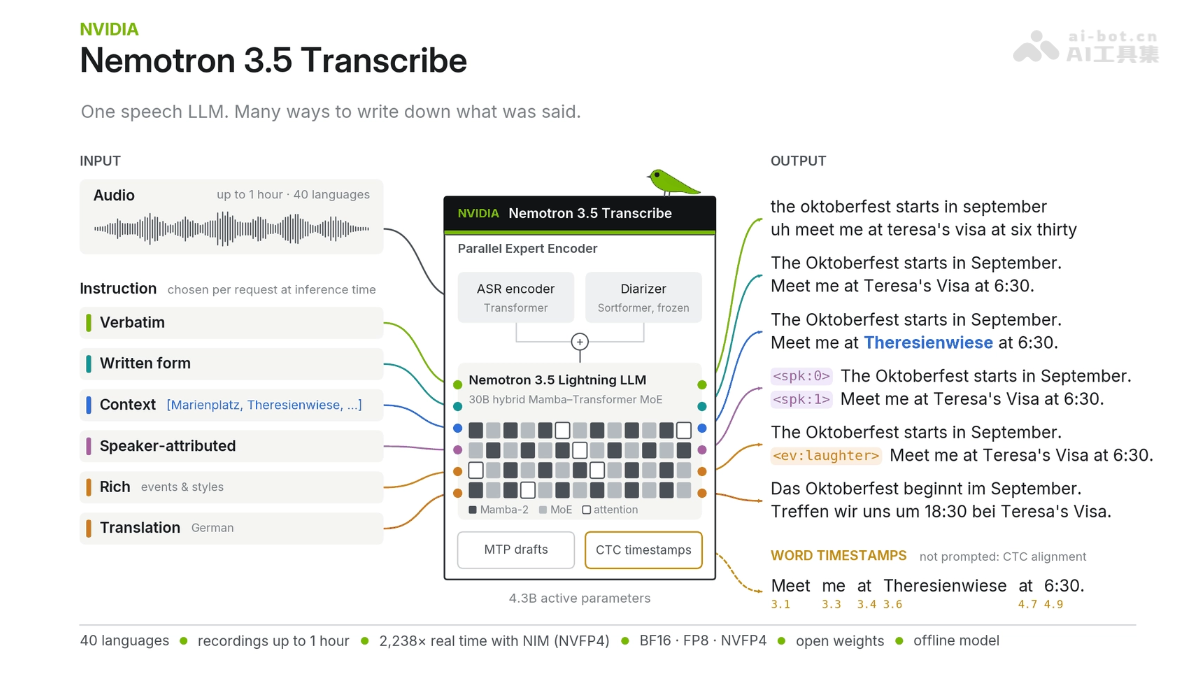
Nemotron 3.5 Transcribe là mô hình ngôn ngữ lớn về giọng nói mã nguồn mở do NVIDIA phát triển, sử dụng kiến trúc bộ mã hóa giọng nói kết hợp MoE, với khoảng 4,3 tỷ tham số hoạt động, hỗ trợ 40 ngôn ngữ, xử lý bản ghi dài tối đa 1 giờ với tối đa 8 người nói, cung cấp các tính năng như chuyển giọng nói thành văn bản nguyên văn, phân biệt người nói và dịch thuật. Nemotron 3.5 Transcribe hỗ trợ tùy chỉnh định dạng đầu ra bằng chỉ dẫn ngôn ngữ tự nhiên, có thể tinh chỉnh để phù hợp với các lĩnh vực chuyên môn và miễn phí cho mục đích thương mại.
02Các tính năng chính của Nemotron 3.5 Transcribe
Chuyển giọng nói thành văn bản đa ngôn ngữ: hỗ trợ 40 ngôn ngữ, có thể chuyển bản ghi âm thành văn bản và nhận diện ngôn ngữ được sử dụng trong lời nói.
Phân biệt người nói: nhận diện tối đa 8 người nói và gắn từng câu với người tương ứng, phù hợp cho các cuộc họp và phỏng vấn nhiều người.
Xử lý âm thanh dài: mỗi lần có thể xử lý bản ghi dài tối đa khoảng 1 giờ.
Chuyển giọng nói thành văn bản bằng chỉ dẫn: dùng ngôn ngữ tự nhiên để chỉ định định dạng đầu ra, chẳng hạn bản chép nguyên văn, văn bản biên tập, loại bỏ từ đệm hoặc cách viết thuật ngữ, mà không cần huấn luyện lại.
Dịch giọng nói: hỗ trợ dịch hai chiều giữa 31 ngôn ngữ và tiếng Anh.
Dấu thời gian cấp từ: trả về vị trí thời gian tương ứng của từng từ trong tệp âm thanh, thuận tiện cho việc nghe lại và tìm kiếm.
Tinh chỉnh theo lĩnh vực: dựa trên bộ công cụ NeMo Speech, có thể nhanh chóng thích ứng với các tình huống chuyên môn bằng một lượng nhỏ dữ liệu trên một GPU.
03Nguyên lý kỹ thuật của Nemotron 3.5 Transcribe
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Mô hình ngôn ngữ tăng cường giọng nói (SALM): mô hình gồm ba phần. Bộ mã hóa giọng nói Transformer chịu trách nhiệm trích xuất đặc trưng âm thanh; một mô hình tách người nói Nemotron 3 bị đóng băng cung cấp thông tin hoạt động của người nói; cả hai cùng kết nối với mô hình ngôn ngữ lớn MoE Nemotron 3.5 Lightning 30B-A3B kết hợp Mamba-Transformer. Tổng số tham số khoảng 34 tỷ, nhưng mỗi lần suy luận chỉ kích hoạt khoảng 4,3 tỷ tham số, cân bằng giữa năng lực và hiệu quả.
Bộ mã hóa chuyên gia song song: tín hiệu hoạt động của người nói do mô hình tách người nói bị đóng băng tạo ra được đưa vào biểu diễn của bộ mã hóa ASR, giúp mô hình hoàn thành việc chuyển giọng nói thành văn bản kèm nhãn người nói trong một kiến trúc LLM duy nhất mà không cần thay đổi, đồng thời được huấn luyện bằng phương thức xuất tuần tự.
Trộn dữ liệu có giám sát cân bằng: dữ liệu huấn luyện được lấy mẫu theo số token trong câu trả lời thay vì số lượng mẫu. Mỗi mẫu ASR có thể kết hợp với nhiều chỉ dẫn nhiệm vụ, nhờ đó một năng lực mới chỉ cần tỷ lệ lấy mẫu dưới 1% để được bổ sung. Toàn bộ quá trình huấn luyện gồm hai giai đoạn: tinh chỉnh có giám sát và một giai đoạn học tăng cường ngắn, trong đó giai đoạn sau trực tiếp tối ưu độ chính xác chuyển giọng nói thành văn bản.
Giải mã suy đoán MTP: mô hình được tối ưu đồng thời cho mục tiêu dự đoán nhiều token (MTP) trong quá trình huấn luyện, nên các lớp MTP của chính nó có thể trực tiếp đóng vai trò mô hình nháp cho giải mã suy đoán của vLLM. Ngoài ra, mô hình nháp DFlash2 cũng được cung cấp riêng để lựa chọn. Kết hợp cả hai, mô hình có thể đạt thông lượng chuyển đổi 2238 giây âm thanh mỗi giây trên một GPU RTX PRO 6000 Blackwell.
Bộ điều hợp dấu thời gian CTC: sau khi giải mã, một bộ điều hợp CTC nhẹ sẽ căn chỉnh văn bản được tạo với âm thanh, tạo ra dấu thời gian cấp từ kèm nhãn người nói cho âm thanh dài và các cuộc hội thoại chồng lấn mạnh mà không làm tăng gánh nặng cho mô hình chính.
04Cách sử dụng Nemotron 3.5 Transcribe
Chuẩn bị phần cứng: bản BF16 cần khoảng 80GB VRAM; có thể chọn bản FP8/NVFP4 hoặc GGUF để giảm yêu cầu phần cứng.
Tải mô hình: tìm NVIDIA-Nemotron-3.5-Transcribe-30B-A4B trên Hugging Face hoặc ModelScope, rồi tải trọng số theo giấy phép OpenMDW-1.1.
Cài đặt môi trường: chọn một trong ba phương thức triển khai: Nemotron Transcribe NIM (container chính thức), vLLM (hỗ trợ tăng tốc MTP) hoặc NeMo-Speech.cpp (chạy cục bộ bằng GGUF).
Chuẩn bị âm thanh: tải lên tệp ghi âm dài tối đa 1 giờ và chuyển đổi định dạng theo yêu cầu của framework đang sử dụng.
Viết lời nhắc: dùng ngôn ngữ tự nhiên để mô tả nhiệm vụ, chẳng hạn “giữ nguyên lời nói và gắn nhãn người nói” hoặc “loại bỏ từ đệm và dịch sang tiếng Anh”.
Chạy suy luận: gọi API để gửi âm thanh và lời nhắc; mô hình trả về văn bản chuyển đổi, kèm nhãn người nói và dấu thời gian cấp từ khi cần.
(Tùy chọn) Trải nghiệm nhanh: nếu không muốn triển khai, có thể dùng không gian trải nghiệm nvidia/nemotron-transcribe trên Hugging Face để thử trực tuyến trước.
(Tùy chọn) Tinh chỉnh theo lĩnh vực: dùng bộ công cụ NeMo Speech để chuẩn bị dữ liệu có nhãn; chỉ cần khoảng 0,5–2,3 giờ trên một GPU để thích ứng với giọng địa phương, thuật ngữ và định dạng riêng.
05Ưu điểm cốt lõi của Nemotron 3.5 Transcribe
Đầu ra theo chỉ dẫn: chỉ với một câu lệnh ngôn ngữ tự nhiên, có thể chuyển đổi giữa bản chép nguyên văn, bản biên tập, bản dịch và các định dạng khác mà không cần huấn luyện lại hoặc cấu hình nhiều mô hình.
Độ chính xác chuyển giọng nói thành văn bản cao: WER trung bình trên bảng xếp hạng Open ASR tiếng Anh chỉ là 4,71%, còn trên bảng xếp hạng đa ngôn ngữ là 4,62%; cả hai đều đứng đầu trong số các mô hình có trọng số mở.
Khả năng phân biệt người nói hàng đầu: lần đầu tiên vượt qua các hệ thống nối chuỗi chuyên dụng trong nhiệm vụ chuyển giọng nói thành văn bản có gắn nhãn người nói với nhiều giọng nói chồng lấn, đồng thời hỗ trợ tối đa 1 giờ và 8 người nói.
Khả năng sửa lỗi theo ngữ cảnh mạnh: sau khi cung cấp danh sách thực thể như thuật ngữ và tên người, tỷ lệ lỗi thực thể có tên có thể giảm 6 lần, giúp các từ chuyên môn không còn bị đoán sai.
Dấu thời gian cấp từ kèm nhãn người nói: căn chỉnh CTC nhẹ giúp kết quả chuyển đổi có thể nghe lại và tìm kiếm, trực tiếp hỗ trợ các ứng dụng như xem lại bài giảng và tìm kiếm nội dung cuộc họp.
Hiệu quả suy luận cao: giải mã suy đoán MTP nguyên bản kết hợp với mô hình nháp DFlash2 cho phép một GPU RTX PRO 6000 xử lý 2238 giây âm thanh mỗi giây.
06Địa chỉ dự án Nemotron 3.5 Transcribe
Kho mô hình HuggingFace:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
Báo cáo kỹ thuật:https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
07Các tình huống ứng dụng của Nemotron 3.5 Transcribe
Biên bản cuộc họp và trích xuất quyết định: tự động phân biệt người phát biểu, giữ nguyên nội dung thảo luận và trích xuất kết luận cùng các việc cần làm theo chỉ dẫn.
Phỏng vấn truyền thông và biên tập tin tức: giữ nguyên lời nói của người được phỏng vấn và gắn nhãn người nói để đảm bảo trích dẫn chính xác, đồng thời có thể loại bỏ từ đệm khi cần.
Xem lại bài giảng và đào tạo: tạo bản chuyển lời có dấu thời gian cấp từ, giúp học viên tìm kiếm trực tiếp từ khóa và chuyển đến thời điểm giảng viên nói về kiến thức đó.
Hồ sơ y tế và lĩnh vực chuyên môn: kết hợp danh sách thuật ngữ và tinh chỉnh theo lĩnh vực để chuyển hội thoại giữa bác sĩ và bệnh nhân thành bệnh án theo định dạng chuẩn, giảm tỷ lệ lỗi thuật ngữ chuyên môn.
Bản địa hóa nội dung đa ngôn ngữ: dịch trực tiếp bản ghi âm bằng 40 ngôn ngữ thành văn bản tiếng Anh, phục vụ hội nghị quốc tế, phỏng vấn hoặc sản xuất phụ đề video.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0