

AnyJev làm gì
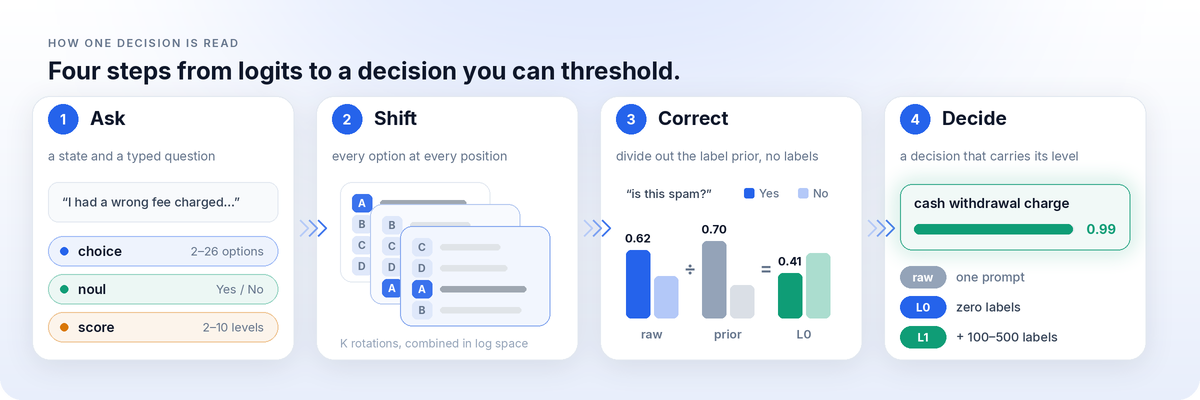
AnyJev biến một mô hình ngôn ngữ mở thành mô hình quyết định kiểu Jev. Thay vì yêu cầu mô hình tạo câu trả lời rồi phân tích văn bản, AnyJev đọc phân phối token tiếp theo của mô hình từ một lần prefill và trả về một quyết định có kiểu dữ liệu kèm xác suất.
Điều này hữu ích cho các quy trình như định tuyến yêu cầu, ước tính liệu một hành động có rủi ro hay không, hoặc chấm điểm mức độ hoàn thành tác vụ. Mỗi kết quả ghi lại cấp độ quyết định được sử dụng, cho phép mã phía sau phân biệt kết quả chưa hiệu chỉnh hoặc không có nhãn với kết quả được tạo bởi một head đã fitting.
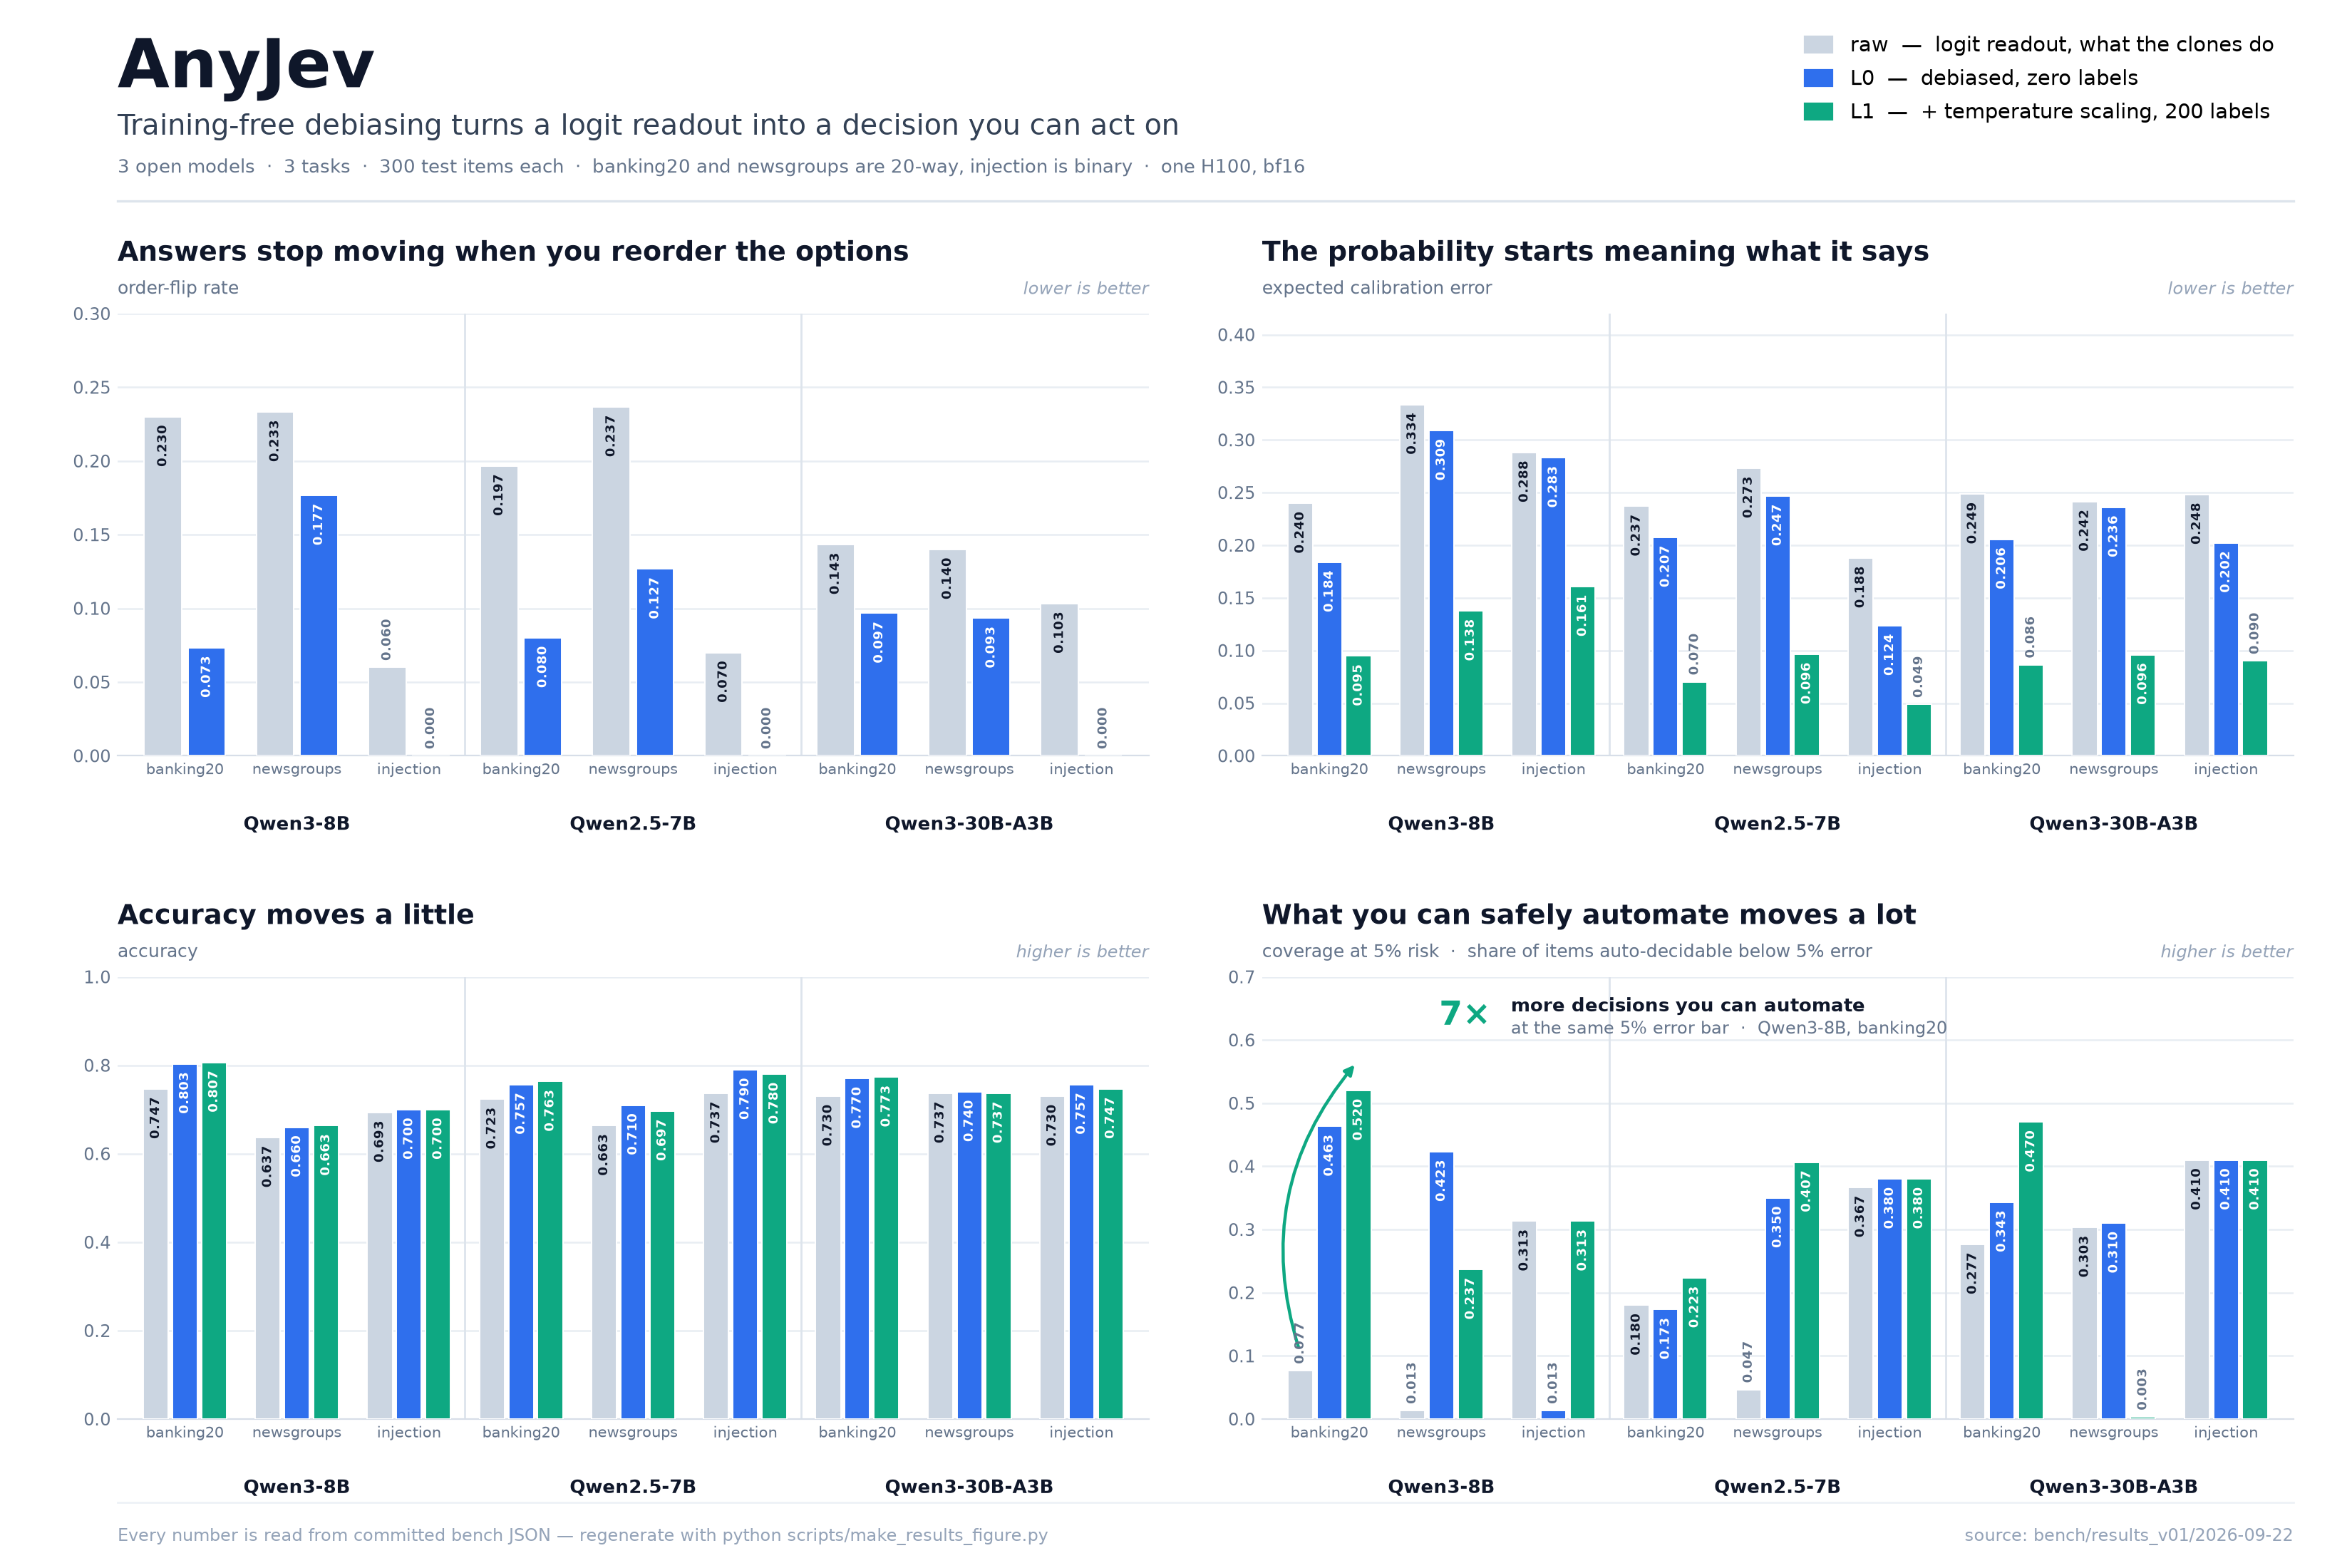
AnyJev giải quyết hai vấn đề thực tế của logits thô: dự đoán có thể thay đổi khi thứ tự tùy chọn thay đổi, và các giá trị độ tin cậy thô có thể chưa được hiệu chỉnh đủ tốt cho tự động hóa dựa trên ngưỡng. Trong thử nghiệm Qwen3-8B BANKING77 của README, L0 giảm tỷ lệ đảo lựa chọn theo thứ tự từ 0.230 xuống 0.073 mà không cần nhãn. L1 giảm sai số hiệu chỉnh kỳ vọng từ 0.240 xuống 0.095 với các ví dụ có nhãn.
Các cấp độ quyết định
AnyJev cung cấp nhiều cấp độ với các yêu cầu khác nhau về dữ liệu và khả năng phục vụ:
- raw: Áp dụng softmax giới hạn trên các token nhãn. Cấp độ này không điều chỉnh độ lệch vị trí hoặc hiệu chỉnh độ tin cậy.
- L0: Không cần nhãn. Cấp độ này đánh giá các phép xoay tùy chọn theo chu kỳ, lấy trung bình để loại bỏ độ lệch vị trí và chia cho prior nhãn ước tính.
- L1: Sử dụng khoảng 100–500 nhãn cho mỗi câu hỏi để fitting temperature scaling trên L0. Cấp độ này cải thiện hiệu chỉnh nhưng không thay đổi thứ hạng.
- L2: Sử dụng khoảng 100–300 nhãn cho mỗi câu hỏi để giải một head LDA thu nhỏ hoặc ridge từ hidden state trung gian. Cấp độ này cần mô hình cục bộ và phụ thuộc vào cả mô hình lẫn câu hỏi.
L0 cần nhiều lần prefill cho lựa chọn có nhiều tùy chọn vì nó đánh giá các phép xoay. Ngược lại, L2 chỉ sử dụng một prompt và dừng tại một block trung gian cố định, nhờ đó rẻ hơn một lượt forward đầy đủ trong các thử nghiệm Qwen3 được báo cáo.
Tính năng chính
- Câu hỏi có kiểu
choice,noulvàscore. - Không tạo văn bản hoặc phân tích câu trả lời.
- Hiệu chỉnh L0 không cần nhãn đối với ảnh hưởng của vị trí tùy chọn và prior nhãn.
- Hiệu chỉnh nhiệt độ L1 với vài trăm nhãn.
- Head dạng công thức đóng L2 được fitting trong vài giây mà không cần gradient hoặc fine-tuning mô hình.
- Tự động chọn L2, L1 hoặc L0 thông qua
level="auto". - Thu thập nhãn tăng dần với
observe. - Quyết định theo batch cho nhiều trạng thái và một câu hỏi.
- Các artifact JSON nhỏ có thể được lưu và tải để phục vụ về sau.
Cài đặt và thiết lập
Cài đặt backend Hugging Face
Cài đặt AnyJev cùng tích hợp Hugging Face:
pip install "anyjev[hf]"Bản phát hành hiện tại phục vụ tất cả các cấp độ quyết định thông qua backend dựa trên Transformers anyjev.backends.hf. Hỗ trợ vLLM và SGLang nằm trong lộ trình và chưa có trong bản phát hành này.
Tạo decider
Nhập API cốt lõi và khởi tạo HFBackend với một mô hình mở:
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
Các head L2 đi kèm bao phủ năm mô hình Qwen3: 1.7B, 4B, 8B, 30B-A3B và 32B. Head L2 vẫn phụ thuộc vào mô hình nền và câu hỏi cụ thể, vì vậy head được fitting cho một mô hình hoặc câu hỏi không thể tự động tái sử dụng cho mô hình hoặc câu hỏi khác.
Định nghĩa câu hỏi có kiểu
Một câu hỏi mô tả kiểu đầu ra, các phản hồi hợp lệ và tên ổn định. Bạn có thể đánh giá nhiều kiểu câu hỏi trên cùng một trạng thái ứng dụng.
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)
Dùng choice cho quyết định phân loại, noul cho quyết định đúng hoặc sai, và score cho điểm số dạng số được chia thành các khoảng. Cơ chế đọc token chữ cái hiện hỗ trợ tối đa 26 tùy chọn.
Thực hiện quyết định L0 cơ bản
L0 là cấp độ mặc định và không cần ví dụ có nhãn. Tạo một state chứa thông tin cần thiết cho các câu hỏi, sau đó gọi decide:
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)
Một phân phối route điển hình có thể ánh xạ từng tùy chọn được cung cấp với một xác suất. Quyết định boolean cung cấp p_true, trong khi quyết định score cung cấp value. Kết quả tổng thể báo cáo L0 khi chưa có artifact cấp cao hơn.
Cần diễn giải xác suất theo cấp độ tương ứng. L0 cải thiện độ ổn định và điều chỉnh độ lệch nhãn ước tính, nhưng không khiến độ bất định được hiệu chỉnh hoàn toàn.
Thêm hiệu chỉnh L1
Nếu có khoảng 100–500 trạng thái đã gán nhãn cho một câu hỏi, hãy gọi calibrate để fitting nhiệt độ L1:
decider.calibrate(risky, states, labels)L1 hiệu chỉnh các xác suất được tạo trên nền L0. Cấp độ này không thay đổi câu trả lời đứng đầu trong thứ hạng, nhưng có thể làm cho các ngưỡng độ tin cậy trở nên có ý nghĩa hơn.
Fitting head dạng công thức đóng L2
Để đạt độ chính xác cao hơn, hãy huấn luyện một đầu L2 dành riêng cho câu hỏi bằng khoảng 100–300 ví dụ đã gắn nhãn:
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
Quá trình huấn luyện thực hiện một lượt chạy mô hình trên các ví dụ, sau đó giải đầu theo dạng đóng. Quá trình này không sử dụng gradient và không thay đổi trọng số của mô hình ngôn ngữ. Theo dự án, một đầu thường có kích thước khoảng 100 KB và có thể được giải trong vài giây đối với các mô hình Qwen3 nhỏ hơn được hỗ trợ.
Hãy tải các tạo tác đã lưu trong một tiến trình sau đó, rồi yêu cầu tự động chọn cấp độ:
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)
Với level="auto", AnyJev sử dụng L2 khi một đầu tương thích có thể định tuyến câu hỏi. Nếu không, hệ thống chuyển về L1 khi có hiệu chuẩn, rồi đến L0.
Thu thập nhãn từng bước
AnyJev có thể tiếp nhận nhãn khi chúng xuất hiện từ hàng đợi đánh giá, kết quả quan sát được hoặc một nguồn phản hồi khác:
decider.observe(route, state, correct_label)Vòng lặp tự động của dự án sẽ giải một đầu sau 30 quan sát, sau đó giải lại ở các mốc 60, 120 và những mốc tiếp theo. Điều này hỗ trợ vòng đời triển khai trong đó một câu hỏi mới bắt đầu ở L0 và chuyển sang L2 sau khi tích lũy đủ phản hồi.
Suy luận theo lô
Khi áp dụng một câu hỏi cho nhiều trạng thái, hãy sử dụng API theo lô thay vì gọi decide lặp lại:
results = decider.decide_batch(states, route)Đây là giao diện được thiết kế để xử lý nhiều đầu vào với cùng một câu hỏi có kiểu.
Dùng thử bản demo đi kèm
Từ bản sao của kho mã, hãy chạy bản demo tổng hợp mà không cần tải xuống mô hình:
python -m demo.jev_mode --backend fakeĐể mô phỏng vòng đời triển khai, hãy thêm tùy chọn vòng đời:
python -m demo.jev_mode --backend fake --lifecycleXóa --backend fake để chạy bản minh họa Qwen3 thực với các đầu được cung cấp.
Mẹo triển khai nâng cao
Giữ ổn định danh tính câu hỏi
L2 được huấn luyện riêng cho từng câu hỏi và mô hình. Một tập tùy chọn mới yêu cầu các nhãn mới và một đầu mới. Việc diễn đạt lại cùng một câu hỏi hoặc thay đổi thứ tự của cùng các tùy chọn có thể được định tuyến đến một đầu hiện có.
Sử dụng lưu lượng chưa gắn nhãn để thích ứng với cách diễn đạt
Đối với các câu hỏi được diễn đạt lại, AnyJev có thể điều chỉnh lại tâm và tỷ lệ đặc trưng của đầu bằng khoảng 30 yêu cầu chưa gắn nhãn. Cơ chế thích ứng này áp dụng cho cách diễn đạt câu hỏi và thứ tự tùy chọn; nó không phát hiện sự thay đổi trong chính các trạng thái của ứng dụng.
Giám sát hiện tượng trôi dạt của dữ liệu thực
Vì sự thay đổi trong phân phối trạng thái không thể được cơ chế điều chỉnh lại phát hiện, hãy duy trì một tập đánh giá được gắn nhãn định kỳ và kiểm tra ngẫu nhiên hiệu năng. Không nên coi việc thích ứng với cách diễn đạt là sự thay thế cho hoạt động giám sát trong môi trường thực tế.
Kiểm soát hành động theo cấp độ quyết định
Mỗi quyết định đều mang theo cấp độ của nó. Các hệ thống phía sau có thể kiểm tra cấp độ trước khi thực hiện một hành động nhạy cảm; dự án cũng hỗ trợ thực thi cấp độ bằng require=. Điều này ngăn một quy trình được thiết kế cho các quyết định đã hiệu chuẩn hoặc quyết định L2 âm thầm thực hiện dựa trên kết quả dự phòng.
Chỉ chọn ngưỡng sau khi thẩm định
Lợi ích chính của hiệu chuẩn là khả năng chuyển các trường hợp có độ tin cậy cao sang tự động hóa, đồng thời chuyển các trường hợp không chắc chắn sang bước đánh giá thêm. Hãy chọn ngưỡng trên dữ liệu đã gắn nhãn mang tính đại diện và đo lường sai số cũng như độ bao phủ thu được, thay vì mặc định rằng xác suất hiển thị luôn đáng tin cậy.
Những hạn chế quan trọng
- Các đầu L2 không thể chuyển sang một câu hỏi hoặc mô hình cơ sở khác.
- Chỉ có các đầu Qwen3 được cung cấp trong bản phát hành hiện tại của dự án.
- L2 yêu cầu quyền truy cập vào các trạng thái ẩn, hiện được cung cấp thông qua backend Transformers.
- Hiệu chuẩn không thể khiến mô hình giải được một tác vụ mà về bản chất nó không thể trả lời.
- L0 có thể làm giảm độ chính xác khi một nhãn chiếm ưu thế rõ rệt trong phân phối trước của lô.
- Chế độ đọc chữ cái hiện tại hỗ trợ không quá 26 tùy chọn.
- Ước tính độ bao phủ rủi ro 5% được báo cáo dựa trên 300 ví dụ và do đó có phương sai cao.
- Độ chính xác của các quyết định có kiểu được công bố đo mức độ nhất quán với một LLM giáo viên, không phải với một chân lý nền được xác lập độc lập.
- Các quyết định được báo cáo được đánh giá riêng lẻ thay vì bên trong một vòng lặp tác tử hoàn chỉnh.
Kết luận
AnyJev cung cấp một lộ trình thực tiễn từ các quyết định có kiểu không cần nhãn đến xác suất đã hiệu chuẩn và các đầu trạng thái ẩn hiệu quả. Hãy bắt đầu với L0, thu thập nhãn thực tế, thêm L1 khi hiệu chuẩn là ưu tiên và huấn luyện L2 khi cần một đường quyết định chính xác hơn dành riêng cho câu hỏi. Hãy lưu lại cấp độ được báo cáo, thẩm định các ngưỡng và giám sát các mẫu đã gắn nhãn khi dữ liệu sản xuất thay đổi.
Để biết chi tiết triển khai và kế hoạch hiện tại, hãy xem kho AnyJev, hợp đồng về các cấp độ, tài liệu benchmark và lộ trình.